Динамическое программирование: Dominating Set при малом вершинном покрытии
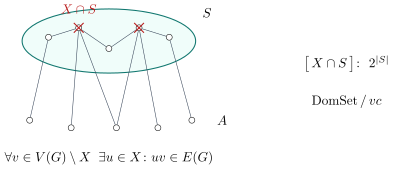
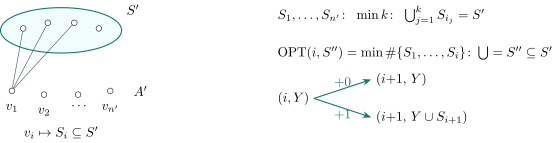
Мы продолжаем заниматься структурными параметрами графов, но теперь сосредоточимся в основном на алгоритмах, чтобы затем применить их в домашнем задании. Сегодня будет использовано несколько разных техник, показывающих, как много интересного получается, если параметризовать задачу подходящим параметром. Начнём с параметра «вершинное покрытие» — это число вершин, которые нужно удалить, чтобы граф стал пустым. Изображать это будем самым простым образом: есть множество , внутри которого могут жить рёбра, а снаружи все вершины независимы. Первая из главных техник, применяемых в таких алгоритмах, — это, конечно, динамическое программирование.
Что может происходить с вершинным покрытием в динамическом программировании? На прошлой лекции мы рассматривали более-менее brute force: перебирали, как ответ пересекает множество . Например, для раскраски мы просто перебирали, как выглядит раскраска этого множества, а остальные вершины затем однозначно докрашивали за полиномиальное время. Тем самым мы отделяли параметр от остальной задачи: перебрав всё, что происходит внутри , мы получали очень простую задачу, которая решается непосредственно. Динамическое программирование будет чем-то посложнее. Начнём с игрушечных примеров и будем переходить к более сложным, стараясь сохранить ваш интерес.
Рассмотрим задачу о доминирующем множестве. В ней требуется найти такое множество , что для любой вершины графа найдётся сосед в множестве ; наша цель — найти доминирующее множество минимального размера. На самом деле всё это несложно модифицируется на взвешенный случай, то есть можно искать минимальное по весу множество, но для простоты мы будем решать невзвешенную задачу. Решать задачу о доминирующем множестве мы будем, используя то, что у графа маленькое вершинное покрытие. Формально такие обозначения не вводились, хотя на прошлой лекции мы ими пользовались: будем писать «Dom. Set / VC» — доминирующее множество «по модулю» вершинного покрытия, то есть задача о доминирующем множестве, параметризованная вершинным покрытием. Обозначения могут быть разными, но смысл один: мы решаем задачу о доминирующем множестве относительно параметра «вершинное покрытие».
— Далеко ли определение ушло: должно быть из замкнутой окрестности?
— Да, из замкнутой окрестности: сама вершина, которая находится в доминирующем множестве, тоже задоминирована. Поэтому проще всего записать определение так: — любая вершина вне множества должна быть задоминирована.
По-другому это можно сформулировать так: если взять каждую вершину множества вместе со всеми её соседями, то в объединении они покроют весь граф. Интерпретации могут быть разными. Например, вы рассказываете новость одному человеку, а он пересказывает её всем своим соседям, и вы хотите, чтобы о новости узнал весь граф; тогда множество людей, которым нужно рассказать новость, — это доминирующее множество. При этом по цепочке новость не передаётся: тот, кому вы рассказали, сообщает соседям, а дальше новость не идёт.
Давайте решать эту задачу. Обычно мы упрощаем себе ситуацию тем, что ничего не делаем внутри вершинного покрытия, а просто перебираем, как там устроен ответ. Итак, алгоритм: переберём, как доминирующее множество пересекается с вершинным покрытием, то есть какие вершины из вершинного покрытия мы возьмём в ответ (взятые будем обозначать крестиком). Эти вершины автоматически покрыли что-то внутри вершинного покрытия, если там были соседи, и покрыли какие-то вершины снаружи. После этого мы знаем, что некоторые вершины уже задоминированы этим множеством и доминировать их не нужно. Однако их всё ещё можно брать или не брать в ответ: даже если вершина кем-то задоминирована, вопрос о ней остаётся — вдруг её нужно взять в ответ, чтобы задоминировать какие-то вершины в вершинном покрытии. Так что задача на этих вершинах всё ещё остаётся достаточно сложной: какие из них брать.
Запишем очевидное соображение. Назовём множество внешних вершин : для любой вершины , если у нет соседа в , её обязательно надо тоже взять в . Рассуждение очень простое: никакого другого способа задоминировать её нет — мы уже перебрали, как выглядит ответ внутри покрытия, это жёстко зафиксировано, и добирать вершины оттуда нельзя. По факту мы разбили нашу задачу на подзадач и каждую решаем отдельно — как было и в brute force, это лишь первый шаг.
Что нужно сделать теперь, на чём остаётся задача? Все вершины снаружи теперь автоматически покрыты: они либо были покрыты выбранным пересечением, либо мы жёстко взяли их в . Непокрытым остаётся лишь некоторое подмножество внутри вершинного покрытия, и нужно набрать вершин снаружи, чтобы покрыть его целиком.
— Непокрытые вершины остаются потому, что мы рассматриваем какой-то конкретный набор , а не ответ для ?
— Мы хотим найти ответ для всего графа, а зафиксировали лишь то, как ответ выглядит внутри вершинного покрытия.
— То есть это какой-то набор, не решение для ?
— Это не решение для , нет. Само внутри может ничего не доминировать; может быть даже так, что ни одну вершину оттуда брать в ответ не надо, то есть вообще не пересекается с . Правда, тогда, скорее всего, придётся взять все вершины снаружи, что выглядит странно, но мы такой вариант допускаем и рассматриваем: выбор вершинного покрытия мог оказаться неудачным, и вершин снаружи может быть меньше, чем внутри. Поэтому пересечение не обязано доминировать , и всего у нас вариантов — рассматривается буквально каждый, от «взять всё вершинное покрытие» до «взять чуть-чуть».
Конечно, если взято всё вершинное покрытие, то делать больше ничего не надо — это заведомо доминирующее множество, за исключением изолированных вершин. Вне вершинного покрытия могут быть вершины, у которых вообще нет соседей, но их можно отбросить исходно: по определению они обязаны жить внутри , поскольку инцидентных им рёбер просто нет.
Теперь задачу можно очень сильно сузить до следующей картинки: есть только и некоторое — вершины вне , которые мы ещё не взяли в (кружочком будем обводить только вершинное покрытие). В мы ничего не делаем, там всё жёстко зафиксировано; вся задача — для каждой вершины из решить, брать её или не брать. Пронумеруем эти вершины: . Каждая такая вершина уже точно задоминирована, поэтому всё, на что она влияет, — это то, что она доминирует некоторое подмножество вершин из . Получается следующая история: выбрать в ответ — значит задоминировать некоторое подмножество .
На самом деле задача оказывается задачей про множества: мы хотим набрать минимальное число вершин, чтобы соответствующие множества в объединении давали всё . Заменим каждую вершину просто на множество: . Нужно найти минимальный по количеству элементов набор множеств такой, что в точности. Именно к такой задаче мы свели исходную. Эта задача имеет своё название — Set Cover, хотя знать это здесь не очень важно; важно понимать, как она решается. Алгоритм для неё, конечно, получится экспоненциальным.
Решаться она будет динамическим программированием — чем-то похожим на рюкзак, но по подмножествам; возможно, вы такое уже видели. Динамическое программирование будет таким: — минимальное количество множеств среди первых , то есть , которые в объединении дают ровно . Такую динамику мы и должны считать; понятно, что сами множества — это просто окрестности вершин, пересечённые с , так что задача чисто про множества.
Переход в такой динамике делается достаточно просто: — это минимум из двух вариантов: либо вы не берёте -е множество, либо берёте. Но здесь возникает неудобный момент, связанный с тем, что объединение должно давать ровно . Если мы берём множество , то хотелось бы сказать: раньше был набран ответ, покрывающий некоторое , и если объединить с , получится ровно . Мы знаем, что получается в объединении, но «откусить» это множество назад сложно: переход назад в таком динамическом программировании делается плохо, и если просто написать разность с , работать ничего не будет. Что же делать, как лечить эту проблему в стандартном динамическом программировании по подмножествам? Тут есть примерно два подхода, и подойдёт любой.
— Считать количество?
— Нет, от подсчёта количества ничего легче не станет. Ответ такой: здесь не надо делать переходы назад. Переход назад сложен из-за того, что динамическое программирование сформулировано неудачно: если бы в формулировке стояло не «ровно», а «хотя бы », то всё бы получилось. Но давайте оставим именно такую динамику и справимся переходами вперёд.
Поскольку у нас нет цели подробно изучать все эти техники в данном курсе, вы можете дополнительно почитать про динамическое программирование по Set Cover, если что-то осталось непонятным, либо задать вопросы отдельно вне лекции — иначе мы ничего не успеем. Подход такой: множества, которые мы можем получить, вычисляются от базы динамики к более сложным состояниям. База: используя ноль множеств, то есть среди первых нуля множеств, можно получить пустое множество, и правильный ответ здесь — ноль.
Задача Imbalance и характеризация перестановки через вершинное покрытие
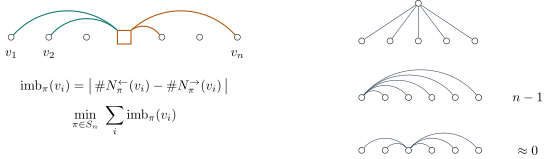
Закончим с переходами в динамике для Set Cover. Рассматривая очередное множество, мы либо не берём его в ответ, либо берём — и тогда оно даёт нам вершины из . В общем случае переход удобно делать вперёд: из состояния мы переходим в состояние , не взяв никакое множество, со стоимостью , либо в состояние , взяв множество, со стоимостью . Не думайте, что здесь какой-то большой rocket science: это нужно один раз понять, и дальше всё будет спокойно получаться.
Рассмотрим теперь другую технику, помимо динамического программирования. Сегодня у нас много разных техник; в запасе была ещё одна задача на динамическое программирование — там был не перебор подмножеств, а рюкзак, причём многомерный, — но её мы пока оставим на потом. Эта новая техника применима в основном к задачам, параметризованным вершинным покрытием. В отличие от динамического программирования, которое применимо к огромному количеству разных параметров, у vertex cover есть своя особая техника, позволяющая решать кучу задач достаточно легко.
Задача называется Imbalance. Мы хотим выстроить вершины графа в некоторую последовательность и смотрим на каждую вершину в отдельности: у неё есть сколько-то соседей слева и сколько-то соседей справа. Имбаланс вершины — это модуль разности числа соседей слева и числа соседей справа. Мы ищем перестановку , минимизирующую сумму имбалансов вершин ; имбаланс, конечно, зависит от конкретной перестановки.
— Разве что-то меняется? Разве сумма меняется от перестановки? Вот мы две соседние вершины поменяли местами.
— Если бы мы не брали модуль, то, наверное, ничего бы не менялось. Вы правы, но мы берём модуль. Подумайте на простом графе, что происходит. Один из простейших графов — звезда. Если выбрать неудачную перестановку, имбаланс будет большим: у каждой листовой вершины имбаланс всегда равен единице, а вот если центр стоит с края, его имбаланс равен . Центральную вершину выгодно поставить в середину: тогда её имбаланс равен нулю, и суммарный имбаланс минимален. То есть ответ всё-таки зависит от перестановки.
Задачи, где надо найти какую-то глобальную перестановку, довольно сложны: мы для них вообще очень мало что умеем делать. Некоторые из них можно решать динамическим программированием, но в общем случае такую задачу мы, видимо, умеем решать только за — какое здесь динамическое программирование придумаешь? На общих графах такие задачи до сих пор доставляют человечеству трудности. Но при параметризации вершинным покрытием всё очень хорошо, и суть в том, что вершины вне покрытия очень сильно похожи между собой: все они делятся на небольшое количество классов.
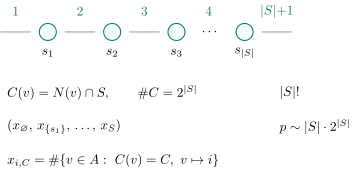
Посмотрим, как можно задать ответ, — попробуем охарактеризовать перестановку относительно вершинного покрытия. Какая самая первая, фундаментальная характеристика перестановки относительно вершинного покрытия, независимо от задачи? Мы делали это на прошлой лекции для пути и для dominating set: нам важен относительный порядок вершин вершинного покрытия в перестановке. Итак, порядок мы зафиксировали — он стоит прямо в перестановке, — и теперь между вершинами покрытия есть промежутки, в которые мы будем как-то напихивать вершины из множества .
Теперь можно заметить: если переставлять вершины внутри одного промежутка, для имбаланса вообще ничего меняться не будет. У такой вершины все соседи слева — вершины из вершинного покрытия, и все соседи справа — тоже вершины из покрытия, поэтому внутри промежутка порядка нет: промежуток — это просто множество вершин. Отметим, что так получается не во всех задачах с перестановками: где-то, возможно, придётся показывать, что нужен какой-то конкретный порядок вершин, но в Imbalance порядок внутри промежутка не важен.
Чем же тогда охарактеризовать множество вершин в промежутке — как его однозначно задать небольшой характеристикой относительно вершинного покрытия? Напомню, что вершины с одинаковым множеством соседей эквивалентны. У каждой вершины из есть класс — множество её соседей; таких классов, конечно, . Значит, множество вершин в промежутке задаётся тем, сколько вершин каждого класса в нём лежит. Это можно представлять как цвета вершин: вершины одного цвета эквивалентны. Таким образом, множество задаётся вектором , индексируемым подмножествами : в начале пустое множество, в конце полное, и в каждую координату нужно поставить целое число.
Сколько всего промежутков? Их : первый, второй и так далее до -го. Введём переменную с двумя индексами — сколько вершин класса попало в промежуток . Это целое неотрицательное число, и решение задачи должно задавать значения всех этих переменных. Что получится, если выписать все ограничения на ? Мы теперь полностью отвязались от графа и хотим просто записать ограничения. Первое ограничение: для любого сумма должна равняться числу вершин класса . Это означает, что я действительно взял все вершины класса и распихал их по промежуткам. Напомню, что порядок уже жёстко зафиксирован, и мы строим это разбиение.
Дальше нужно сказать, что для любых и выполнено и , то есть это целые числа. Пока это просто какая-то целочисленная линейная программа, причём любое решение нам подходит: ограничения очень простые, проблемы найти допустимое решение нет. Всякий набор значений, удовлетворяющий этим условиям, задаёт перестановку — точнее, не совсем однозначно: он задаёт класс перестановок, в которых вершины внутри промежутка можно переставлять как угодно. Осталось записать имбаланс в виде линейного выражения. Относительный порядок фиксирован, так что для вершин вершинного покрытия никакой неоднозначности нет.
— А разве не может быть симметричных случаев? Если у вершины нечётное количество рёбер идёт в , мы можем поставить её либо слева от середины, либо справа.
— Можем, конечно. Но смотрите: мы здесь даже не переживаем за локальную оптимальность, мы просто сводим задачу к другой, которая выражает исходную, а дальше там уже всё само решится — к тому, как решится, я ещё перейду.
Итак, мы составили линейную программу, но пока не выписали целевую функцию. Начнём с имбаланса внутри промежутков — у вершин вне вершинного покрытия. Понятно, что имбаланс конкретной вершины внутри промежутка зависит только от её класса и от номера промежутка: нужно посмотреть, сколько у класса соседей слева и сколько справа, и у всех вершин этого класса в этом промежутке будет ровно такой имбаланс. Поэтому имбаланс вершин внутри промежутков выражается суммой , где — имбаланс вершины класса в промежутке : величина, задаваемая только фиксированной перестановкой покрытия. Посчитать её легко: ставим вершину класса в промежуток и смотрим её имбаланс. Это выразило весь имбаланс промежуточных вершин, и это снова линейное выражение.
Осталось выразить имбаланс вершин из вершинного покрытия, и он, конечно, тоже зависит от того, какие вершины стоят внутри промежутков. Здесь могут возникнуть некоторые трудности. Попробуем посчитать имбаланс конкретной вершины из вершинного покрытия: слева от неё могут стоять вершины — в том числе тоже из вершинного покрытия.
Целочисленное линейное программирование: теорема Ленстры и neighborhood diversity
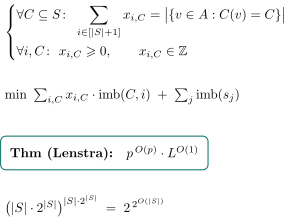
Осталось выразить в нашей целочисленной линейной программе imbalance вершин покрытия, и подсчитывать его придётся честно: никак иначе не обойтись, кроме как посчитать для каждой такой вершины число соседей слева, число соседей справа и взять разность. Зафиксируем вершину вершинного покрытия и назовём её , чтобы ни с чем не путаться. Слева от неё лежат промежутки с номерами от до , справа — промежутки с номерами от до . Тогда число соседей слева внутри промежутков — это сумма : соседями слева будут ровно вершины тех классов , которые содержат , — ведь класс и есть множество соседей. К этому нужно прибавить количество вершин покрытия, лежащих слева, а это уже величина, от -ов не зависящая: число таких , что и . Аналогично число соседей справа: плюс число таких , что и . Imbalance вершины — это модуль разности этих двух выражений, и сумму таких величин мы минимизируем; здесь всё уже не так просто, как с промежутками, где слагаемые были совершенно независимы.
Есть одна проблема: в целевой функции стоит модуль. У этой проблемы есть два интересных решения. Во-первых, поскольку вершин покрытия мало, можно втупую перебрать знак этого выражения: для каждой вершины угадать, чего у неё больше — соседей слева или соседей справа, — и дописать жёсткое ограничение: число соседей слева числа соседей справа либо него; обведённый на доске знак сравнения как раз и перебирается. Это константное число вариантов на вершину, и такой выбор, как и раньше, просто характеризует перестановку; после раскрытия модуля получается честная линейная программа. Во-вторых, модуль в принципе можно пытаться выразить линейно через дополнительные переменные и их минимизацию, но я не уверен, что здесь это получится, — я не проверял, можете подумать над этим сами. Да, время работы я, конечно, домножил на степень двойки, но наш курс вообще будет часто на что-нибудь домножать: наша задача — понять основные подходы, а оптимизация алгоритмов, при всей её важности, пока остаётся за кадром.
Почему же эта линейная программа хорошая? Вообще-то решать целочисленные линейные программы мы не умеем — это NP-трудная задача. Неравенств в нашей программе, кстати, получается немного, но самое важное — в ней немного переменных. Есть теорема, которую когда-то давно доказал Ленстра (алгоритм потом улучшали): целочисленная линейная программа с переменными решается за время , где — длина записи программы. В деталях я могу немного наврать, но порядок времени работы именно такой, и сути это не меняет: в результате мы смогли построить алгоритм, работающий за FPT-время относительно вершинного покрытия.
Давайте посмотрим, сколько всё это работает. Фиксация перестановки — это , дальше перебор знаков модулей даёт ещё множитель . Построение самой линейной программы — тоже порядка , точнее её длина записи — это . Наконец, сама ILP решается за очень много: переменных в программе порядка , и, подставляя это в теорему Ленстры, мы получаем двойную экспоненту. Тем не менее цели мы добились: задача решена за FPT-время. Давайте аккуратно проделаем подсчёт, не буду делать его грубо (и не спрашивайте, почему я не заменяю на параметр , — надо бы; в домашнем задании обязательно заменяйте). Итак, нужно возвести в степень — посмотрим, может ли преподаватель в седьмом часу правильно написать здесь основание и показатель степени.
— Это надо просто домножить показатель вот здесь на .
— Да, давайте так и запишем: .
Понятно, что первый показатель побольше, поэтому второй множитель можно игнорировать — вот он, наш порядок. В этой области часто просто пишут, что это , и это, конечно, правда: если увеличить здесь двойку в основании, она «скушает» множитель в показателе. Обозначим эту технику как integer linear programming — третья техника на сегодня.
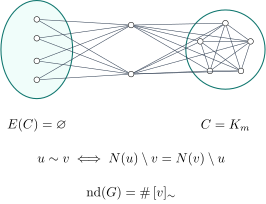
Теперь расскажу про новые параметры, с которыми можно работать; другие интересные техники у меня ещё будут поводы изложить — курс большой. Один из параметров связан с теми самыми классами: когда мы строили линейную программу, мы пользовались тем, что у вершин очень мало разных классов — вершины заменяются друг на друга. Что если количество этих классов само превратить в параметр? Такой параметр называется neighborhood diversity, и он как раз измеряет, насколько разнообразными могут быть вершины с этой точки зрения.
Определять его нужно аккуратно. Если взять полный граф, то в нём множества соседей любых двух вершин не совпадают, хотя все вершины клики эквивалентны с точностью до перестановки; мы же хотим, чтобы и пустой граф, и клика имели маленький параметр. Поэтому скажем так: вершины и принадлежат одному классу, если , то есть если взять соседей и выкинуть оттуда , а затем взять соседей и выкинуть оттуда , получится одно и то же. Посмотрим, в чём здесь разница. Если две вершины имеют полностью одинаковых соседей и не соединены ребром — они одного класса. Но могут быть и две вершины с тем же самым множеством соседей, соединённые ребром, — это уже другой класс: при сравнении по определению у каждой из них «не хватает» второй в качестве соседа. Иными словами, вершины с одним множеством соседей могут образовывать либо полный граф, либо пустой.
Как с этим параметром работать? Нужно доказывать, что ответ ведёт себя очень ограниченно относительно классов: в разных задачах вершины одного класса в ответ целиком брать не нужно. Например, рассмотрим доминирующее множество. Если у меня есть клика, все вершины которой имеют одних и тех же соседей, то, чтобы задоминировать этих соседей, имеет смысл брать из клики лишь одну вершину, если вообще что-то брать: взяв две, я могу выкинуть одну из них — задоминировано будет ровно то же самое. С независимым классом чуть похитрее, ведь его вершины не соединены рёбрами, но и там можно показать, что класс берётся либо целиком, либо одной вершиной. Это остаётся вам на подумать в виде упражнения; что-то по этому поводу будет и в домашнем задании.
— А чему, собственно, равен сам параметр?
— Да, спасибо, что пояснили: я нарисовал пример и сразу перешёл к задаче, а определение не дописал. Neighborhood diversity графа — это просто число классов: число классов . Прикол этого параметра в том, что он вычислим за полином — в отличие, кажется, от всех адекватных параметров, с которыми мы до сих пор рассматривали алгоритмы.
Перейдём к более классическим параметрам, которые ведут нас, например, к древесной ширине. Параметр называется feedback vertex set. Это один из параметров семейства distance to triviality — мы уже определяли параметры вида «сколько вершин нужно удалить, чтобы получился заданный класс графов», — а конкретно это distance to forest. Название же связано с сетями: задача возникала как вопрос о том, что в сети лишнее, из-за чего создаются циклы; цикл — это и есть «фидбэк» в сети, и про историю названия можно почитать. Формально feedback vertex set — это минимальное по размеру такое, что — набор деревьев; иначе говоря, сколько вершин надо удалить из графа, чтобы в нём не осталось циклов. Примечателен этот параметр тем, что, как я уже анонсировал, он обобщает деревья: множество задач на деревьях решается динамическим программированием — мы идём от поддеревьев, вычисляем в них лучший ответ и, находясь в вершине, пересчитываем ответ через посчитанное в поддеревьях.
Longest Path при параметре feedback vertex set
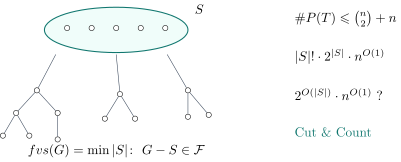
Для дерева задача Longest Path решается без всяких проблем, и логично ожидать, что если начать накидывать на дерево дополнительные вершины, соединяя их с ним как угодно (хоть со всеми вершинами сразу), сложность задачи изменится не сильно: с ростом числа таких вершин сложность алгоритма будет расти постепенно — конечно, экспоненциально. Попробуем это объяснить. Сделаем замечание, на котором будем основываться: в дереве всего простых путей — даже не просто , а ровно биномиальный коэффициент, поскольку путь однозначно задаётся выбором двух концов; если учитывать ещё и пути из одной вершины, нужно добавить . Таким образом, пути в дереве — полиномиальное комбинаторное пространство: их можно все перебрать и проверить любые свойства, то есть найти оптимальный по любому критерию путь, не обязательно кратчайший или длиннейший. Подчеркнём, что в Longest Path ищется именно простой путь: без ограничения на простоту можно было бы просто ходить туда-сюда по одному ребру и набрать путь какой угодно длины.
Решать задачу можно по-разному; здесь предлагается лишь один из способов. Картинка, которую мы будем рисовать в курсе очень много раз: есть множество — наш модулятор до леса (набора деревьев), то есть feedback vertex set, после удаления которого граф распадается на деревья, — и нужно найти наидлиннейший путь. Мы предложим алгоритм, работающий за время порядка . Существует ли простой алгоритм, работающий за , — открытый вопрос (?): известны очень сложные технические алгоритмы с такой зависимостью, в которых комбинируется несколько серьёзных техник, — такое рассказывается за целую лекцию, и то с пропусками. Показательно, что эти алгоритмы работают даже для более сложных параметров типа древесной ширины, хотя feedback vertex set кажется совсем простым параметром. Ключевая техника называется Cut & Count: там используются многочлены, вычисляемые над полями характеристики 2, то есть очень хитрые включения-исключения. Найти простое решение остаётся «крутым домашним заданием» в том смысле, что лектор его не знает и не смог найти; впрочем, цель курса не в том, чтобы разбирать самые жёсткие техники на первых лекциях, а скорее в том, чтобы порадоваться, какие у нас замечательные параметры.
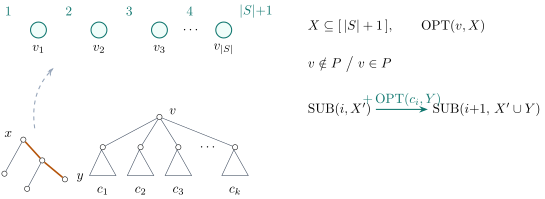
Откуда же в решении берётся множитель ? Мы угадываем, в каком порядке вершины из feedback vertex set лежат на искомом пути. Кроме того, нужно угадать, какие из этих вершин вообще попадут в ответ (отсюда множитель ): наидлиннейший путь не обязан содержать все вершины из . Итак, подмножество и перестановка зафиксированы, и дальше — знакомая нам история: нужно заполнить промежутки. Вершины из стоят на пути в известном порядке, и между ними образуется промежутков; из деревьев нужно вырезать пути и вклеить их в эти промежутки, причём суммарно как можно более длинные. Проблема в том, что вырезаемые пути могут пересекаться: если в один промежуток вклеить длинный путь, а в другой — путь, который с ним пересечётся, простого пути не получится; как вклеить пути так, чтобы они не пересекались, — в этом и состоит вся задача.
Построим динамическое программирование, пользуясь тем, что путей в дереве полиномиально много. Дерево — это ресурс для закрытия промежутков: мы берём дерево, как-то режем его и закрываем некоторое подмножество промежутков; сама идея динамики похожа на первую задачу этой лекции, где дерево помогало закрыть подмножество промежутков. Деревья снаружи не ориентированы, но мы подвесим каждое за некоторый корень, как обсуждали в начале при переходе к динамике по деревьям: у каждой вершины снаружи — не обязательно у корня — появляется своё поддерево , поддеревья вкладываются друг в друга, и пересчитывать мы будем именно по ним. Определим — лучший способ выбрать непересекающиеся пути из поддерева , чтобы закрыть подмножество промежутков; здесь — подмножество индексов промежутков: мы решаем вытащить это поддерево независимо, нарезать его на пути и вставить их именно в промежутки с индексами из . Такая динамика считается для каждой вершины снаружи ; состояний в ней много — , — но это всё ещё то, что нам нужно.
Мы не будем выписывать все переходы формально: цель не в полностью строгом описании алгоритма со всеми проверками корректности, а в том, чтобы обсудить, как задача решается согласно этому параметру. Считаем, как обычно в динамике по деревьям: в поддеревьях всё посчитано, нужно разобраться с вершиной . Если пусто, лучший способ — ничего не делать: закрывать нечего. В общем случае есть два варианта: либо вообще не берём в ответ и разбиваем работу по поддеревьям, либо перебираем конкретный путь через , а оставшиеся после его удаления поддеревья собираем тем же динамическим программированием. Кажется, что это просто большой перебор, — но тривиального здесь ничего нет.
Первый случай: не берём в ответ. Тогда нужно собрать из сыновей : каждому дочернему узлу достаётся своё подмножество, и вместе они должны соединиться в — то есть мы перебираем всевозможные разбиения по сыновьям и берём максимум. Но таких разбиений : каждый элемент идёт к одному из сыновей либо никуда, — а это очень много, потому что большое.
— И прямым перебором разбиений мы в нужное время даже не уложимся?
— Да, поэтому здесь будет вспомогательное динамическое программирование.
— А можно хоть примерно понять, как оно делается?
— Примерно так же, как в set cover. Выстраиваем сыновей в ряд и считаем промежуточную динамику : какую суммарную длину можно набрать, если среди первых сыновей покрыто множество . Рассматривая очередного сына, перебираем, какое множество промежутков он закроет: переход со стоимостью — лучший ответ в сыне для покрытия множества . Это уже вполне понятная, несложная техника, хотя технически и не самая приятная.
Второй случай: участвует в каком-то пути, и здесь разбиение устроено сложнее. Фиксируем концы этого пути — вершины и , которые лежат в каких-то сыновних поддеревьях . Чтобы таким путём закрыть конкретный промежуток, нужно проверить, что — сосед левой вершины этого промежутка, — сосед правой, а находится где-то посередине; тогда путь закрывает промежуток, и мы получаем за это его длину. Что усложняется: при удалении этого пути от дерева начинают отваливаться поддеревья — у каждой вершины пути появляются свои поддеревья, и динамическое программирование приходится считать для большого количества деревьев поменьше, но оно всё равно считается.
— Это считается простым алгоритмом?
— Да, несложным: никаких специфических техник здесь нет, нужно просто понимать, как работает DP по поддеревьям — что такое меньшая задача и что такое большая задача.
К чему всё это: динамическое программирование очень сильно решает во многих из этих задач, но это вовсе не центральная техника курса — просто ей нужно уметь пользоваться. Чего мы сегодня не успели: поговорить про вычисление параметров, например, как эффективно вычислить feedback vertex set, — ведь у хорошего параметра должна быть и хорошая характеристика вычислимости; для домашнего задания это, впрочем, не понадобится. Дальше у нас будут параметры, которые мы пока вообще не знаем, как вычислять. Зачем такие параметры рассматривают? Ну, во-первых, вдруг когда-то вычислим, а во-вторых, это просто интересно. Конкретно упомянутый параметр — кликовая ширина (clique-width); когда мы к ней придём, поговорим о том, что про неё известно, что нет, и почему это на самом деле хороший параметр. И ещё замечание: список техник сегодня далеко не полный — должны были быть ещё потоки, но они отложены на потом.
— Потоки — это про streaming, когда выполнение программы делится на несколько исполнителей?
— Нет, по-русски и то и другое — «потоки», но по-английски различаются streaming и flows; наши потоки — это классические потоки в транспортных сетях, то есть алгоритм Форда — Фалкерсона и всё такое.
Про домашнее задание: вопросы «когда появится ДЗ» и «как его правильно сдавать» уже звучали. Детали организации будут чётко зафиксированы и написаны в чате, чтобы сейчас не давать информации, которая потом может поменяться. На этом лекция завершается.