Параметр графа, вершинное покрытие, раскраска
Всем привет! Вы пришли на курс «Структурные параметры графов» — не путать со структурной теорией графов: название выбиралось долго, и по ходу курса мы поймём, почему он называется именно так. Предварительно запланировано двенадцать лекций — не знаю, доступна ли вам эта информация, но их должно быть двенадцать. Сегодня мы поговорим о том, чем будем заниматься в течение курса, и попробуем ответить на вопрос, чему он посвящён. Я постараюсь осветить с разных сторон, почему это может быть интересно и кому, и как этим занимаются в целом. Начнём с простых примеров и постепенно будем всё лучше понимать общую картину.
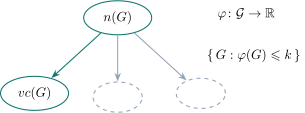
Итак, что такое параметры? Начнём с формального определения. Параметр — это просто некоторая функция от графа: если обозначить параметр буквой , то он действует из некоторого множества графов G в действительные числа. Какие здесь должны быть графы? Конечно же, конечные. Весь этот курс в большей степени относится к computer science: мы смотрим на графы именно с этой точки зрения.
Структурная теория графов стала очень тесно связана с computer science, и теперь эти области развиваются вместе. Графы у нас конечные, а числа, хотя формально и действительные, по большей части будут просто натуральными, иногда с нулём. Когда-то значения будут и действительными, но всё равно положительными. Так или иначе, мы будем строить алгоритмы, зависящие от этих величин, так что зависимость будет от целого числа. Давайте начнём сразу с примеров. Что может быть примером параметра? Как вы думаете, какой самый простой параметр графа, описывающий его сложность, можно придумать?
— Число вершин.
Действительно, это вполне нормальный параметр, хороший вариант. С точки зрения того, чего мы хотим от графа, число вершин — величина естественная: чем граф больше, тем он, вероятно, сложнее. Как всё это связано между собой? Мы хотим так или иначе описывать сложность структуры графа. Сформулирую замечание: параметр отражает — напишу в кавычках — «структурную сложность» графа. В этом весь смысл наших параметров, не зря они называются структурными. И нас очень часто будет интересовать вопрос: если значение параметра ограничено, какие графы вообще могут существовать?
Пусть есть множество графов G, таких что не превосходит параметра k. Мы будем изучать, что это за графы и что с ними можно делать интересного. А понятно ли вам, в каком смысле один граф может быть легче или сложнее другого? С какой точки зрения это можно рассматривать? Что значит, что одно семейство графов сложнее другого? Это, разумеется, неформальные рассуждения: пока мы пытаемся приобрести мотивацию и самую базовую интуицию того, чем будем заниматься.
— С точки зрения параметров.
— Да, но оставим пока параметры в стороне: какое применение всего этого мы хотели бы получить? На самом деле более или менее всё, что нас интересует, — это возможность эффективно выполнять вычисления на некоторых графах. Это основная мотивация нашей работы; иногда она будет варьироваться, и мы разберёмся в этих вариациях. Отсюда замечание — как раз о сложности: чем параметр меньше, тем алгоритмы эффективнее, грубо говоря. Согласитесь при этом, что параметр «число вершин» плох: семейство графов, которое им описывается, вообще конечно. Если я задал некоторый параметр k и рассматриваю все графы, у которых число вершин его не превосходит, то это конечный набор графов.
Ещё анонсирую, что мы будем строить некоторое дерево параметров — от более простых к более сложным; что именно значит «от более простых к более сложным», мы ещё поймём. Корнем этого дерева будет число вершин, а между параметрами мы будем проводить стрелочки, и внизу у нас получится очень пёстрая картина. Как вы думаете, когда появляется стрелочка из параметра в параметр? Какая именно зависимость между параметрами должна быть? В каком случае один параметр как-то ограничивает другой? Такую интуицию мы и должны получить: мои замечания — это интуиция о том, что некоторые параметры будут ограничивать другие.
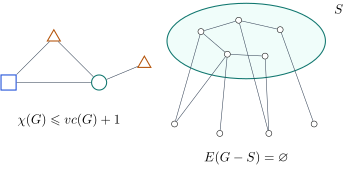
Формальную формулировку мы дадим чуть позже: сейчас я не хочу записывать это утверждение, потому что оно прозвучало бы голословно, а голословности хочется меньше. Давайте сначала рассмотрим больше примеров параметров — тогда замечание станет понятным. Возьмём другой параметр — вершинное покрытие, которое я буду сокращённо называть VC. Это количество вершин, которые нужно удалить из графа, чтобы в нём не осталось рёбер. У вершинного покрытия много определений; примем такое: это минимальное по размеру подмножество S множества VG, такое что граф G с удалёнными вершинами из S — пустой граф. Пустой граф по определению — это граф, в котором нет рёбер.
Понятно, что это такое? Хорошо. Мы, конечно же, знаем: если есть параметр «число вершин» — обозначим его n от G, поскольку число вершин мы всегда будем называть n, — то n от G больше либо равно vertex cover от G. Это просто тождество, и понятно почему: вершинное покрытие — это вершинное подмножество. Теперь разберёмся, в чём суть, — вещь совсем простая. Если мы разработаем эффективный алгоритм, который хорошо работает на графах с ограниченным вершинным покрытием, то мы автоматически покроем и параметр n.
Иными словами, алгоритм, эффективно работающий относительно вершинного покрытия, будет эффективно работать и относительно числа вершин. А понятно ли, что такое «эффективно»? Должна быть какая-то оценка сложности. Давайте посмотрим на конкретную задачу и выясним, какой выбор параметра для неё будет удачным, а какой — нет. Предлагаю задачу о хроматическом числе: найти минимальное количество цветов, в которое раскрашивается граф. Всем понятно, что это значит, или нужно пояснить?
Давайте поясним. Что такое правильная раскраска графа? У вас есть вершины графа, и им нужно назначить цвета так, чтобы цвета концов любого ребра не совпадали. Например, на доске цвета — это треугольник и квадрат. Скажем, цикл из трёх вершин раскрашивается минимум в три цвета. Можно сказать и по-другому: граф должен покрываться небольшим количеством независимых множеств. Вы выделяете несколько множеств вершин, внутри каждого из которых нет рёбер. Это эквивалентное определение: разбить вершины графа на минимальное число независимых множеств.
Относительно параметра n с этой задачей мы однозначно справимся: можно запустить полный перебор того, какая вершина в какой цвет красится, — хоть за n в степени n; есть и более эффективные алгоритмы, за 2 в степени n. Посмотрим, какие алгоритмы допускает эта задача: она допускает алгоритм за O от 2 в степени n. Суть в том, что мы не будем на лекциях углубляться в самые эффективные алгоритмы — нам интереснее, какие параметры позволяют получать более эффективные алгоритмы, а какие нет. Полный перебор мы делать умеем: просто перебираем, что во что красится.
Давайте теперь придумаем эффективный алгоритм относительно вершинного покрытия и убедимся, что он тоже достаточно неплох. Чем хорошо вершинное покрытие? Тем, что все рёбра «живут» при множестве S: если S — вершинное покрытие, то все остальные вершины связаны только с этим множеством, с какими-то его вершинами, а между собой не связаны вовсе. И тогда покрасить внешнюю вершину, когда множество S уже покрашено, совершенно просто. Прежде чем формулировать алгоритм, заметим, что такой граф заведомо красится в цвет: каждую вершину покрытия можно покрасить в свой цвет, а все вершины снаружи — ещё в один.
Согласны? Получается, цветов требуется не очень много — это нам просто для интуиции. Каким будет решение? Примерно таким же, как полный перебор, только чуть более хитрым: внешние вершины обрабатываются отдельно. Переберём покраски графа в k цветов — для всех k. Что такое ? Это порождённый граф на вершинах множества S: мы смотрим только на то «окошечко» графа, которое я обвёл. Для каждой покраски проверим её правильность. Понятно, что если покраска всего графа существует, то она обязательно сужается до покраски этого порождённого графа.
Дальше вершины снаружи можно красить просто жадно: количество цветов нам известно, берём каждую внешнюю вершину, смотрим, какое множество цветов встречается среди её соседей в покрытии, и выбираем минимальное число, не входящее в это множество. Понятно, что при фиксированной раскраске множества S это оптимальный способ. Грубо говоря, это весь алгоритм: красим вершины снаружи жадно. Что получилось? Получился алгоритм, конечно, экспоненциальный. За какое время он работает? Перебор покрасок в такое количество цветов — это примерно vertex cover в степени vertex cover.
Оценка сверху точно будет такой, и всё это умножается на полином от размера графа. Такой алгоритм подходит нам больше: он эффективно работает не только при ограниченных значениях параметра n, но и при ограниченных значениях параметра vertex cover. Теперь давайте наконец сформулируем, что значит, что параметр ограничивает сверху некоторый параметр ; писать буду уже на другой доске. Есть ли вопросы, друзья, всё ли понятно? Сегодня мы намеренно оперируем совсем игрушечными примерами, чтобы понять, чего мы вообще хотим добиться.
Отношения параметров, FPT и XP
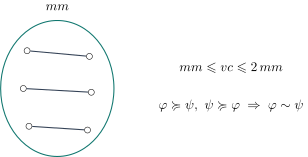
Естественно, нам хочется, чтобы один параметр ограничивал другой. Будем говорить, что параметр ограничивает параметр , если существует функция f из действительных чисел в действительные, такая что для любого графа G значение от G больше либо равно значению от G — только одна из частей неравенства берётся под функцию. Понятно, что это значит? Выше у нас была совсем простая ситуация, где один параметр напрямую ограничивался сверху.
— А в функцию оборачивается именно ?
Хороший вопрос, давайте запишем это аккуратно. Правильнее обернуть в функцию — тогда всё будет корректно, ведь мы не можем позволить функции f принимать бесконечные значения. Итак, уточняю: f действует из положительных чисел в положительные, и требуется, чтобы существовала функция, которая амплифицирует настолько, чтобы он превосходил . При такой записи никакие трюки с бесконечностью уже невозможны. Спасибо, что заметили, — это было действительно важно.
Итак, мы разобрались: бывает, что параметры ограничивают друг друга сверху. Это отношение записывают специальным значком — своеобразным «кривым» неравенством, — но дальше он нам практически не встретится. Именно это отношение изображают рёбра в дереве параметров: от более ограничивающего параметра мы переходим к менее ограничивающему. Вопросы? Вопросов нет. Хорошо. А что ещё бывает с параметрами, кроме того, что один ограничивает другой сверху?
Понятно, что это отношение транзитивно — с ним всё в порядке. Но бывают и несравнимые параметры: это значит, что такой ограничивающей функции не существует. К примерам несравнимых параметров мы ещё перейдём. А пока рассмотрим другой случай. Представьте: я алгоритмист, хочу написать новую статью и, чтобы разработать эффективный алгоритм, вместо вершинного покрытия беру другой параметр — максимальное паросочетание. Можете объяснить, почему мне лучше этого не делать? Напомню, какую цель мы преследуем: мы пытаемся сформулировать, как вообще работать с параметрами, и сейчас я объясняю, как параметры могут быть связаны между собой. Итак, я построил алгоритм относительно vertex cover, а теперь хочу построить его относительно максимального паросочетания. Нет, это не случай несравнимых параметров — здесь я перехожу к другой крайности.
Что такое максимальное паросочетание? Это такой набор попарно непересекающихся рёбер графа, что к нему нельзя добавить ещё одно ребро этого же графа: у любого другого ребра один из концов уже лежит в паросочетании. Так какой же ответ? Верно: эти параметры оцениваются друг через друга с точностью до константы. Действительно, легко доказать, что вершинное покрытие не превосходит удвоенного максимального паросочетания, а с другой стороны, любое вершинное покрытие обязано брать хотя бы по одной вершине из каждого ребра паросочетания.
Давайте поймём, почему это так, — факт простой, если вы его ещё не слышали. Смотрите: вершинное покрытие обязано «убить» все рёбра. Значит, из каждого ребра паросочетания — а они независимы — приходится взять хотя бы один конец; отсюда нижняя оценка через maximum matching. С другой стороны, если объединить все концы рёбер максимального паросочетания и удалить их, граф станет пустым — значит, этот набор вершин является вершинным покрытием. Получается, что параметры, грубо говоря, одинаковые: каждый можно ограничить через другой. Такие параметры будем называть эквивалентными. Определение: если ограничивает сверху и ограничивает сверху, то и эквивалентны.
Поэтому заменять параметр на эквивалентный ему не очень интересно. Возможно, вы уже уловили один из концептов происходящего. Мотивация здесь довольно прямая — и при этом вполне серьёзная: если вы хотите получить статью или новый результат, люди делают именно так. Берут вычислительную задачу, берут параметр и пытаются её решать: если этот параметр ограничен, есть ли эффективные алгоритмы? Так постепенно расширяется набор классов графов, на которых задачу можно решать эффективно. Какие вопросы пока наименее понятны? Я ещё далеко не всё здесь сформулировал. Что из сказанного вызывает наибольшие затруднения?
— Если вернуться к задаче о покраске: мы меняем один параметр на другой; при эквивалентности это не имеет смысла, а при какой зависимости имеет?
Когда связи нет: один параметр может быть сколь угодно большим при малом другом. Так что в основном имеет смысл рассматривать несравнимые параметры. И вы правильно обратили внимание на другой момент: пока вообще непонятно, что такое «эффективные алгоритмы», за чем мы охотимся и с чем сравниваем. Давайте об этом поговорим. Мы будем рассматривать в основном NP-трудные задачи.
Конечно, самый эффективный алгоритм для такой задачи работал бы за полиномиальное время. Возможно, за время этого курса какая-нибудь очередная компания закроет ещё один вопрос тысячелетия, и тогда рассуждать о вычислительных оценках станет особо не о чем. Но пока мы знаем вот что: для NP-трудной задачи полиномиального алгоритма, скорее всего, нет, и поделать с этим мы ничего не можем. К чему мы приходим? Надо разрабатывать алгоритмы хотя бы для специальных случаев. Вы наверняка сталкивались, например, с алгоритмами на деревьях: NP-трудную задачу на общих графах за полином решить нельзя, а если дали дерево, на нём работает какое-нибудь динамическое программирование.
Так или иначе это вам встречалось: найти самый длинный путь в дереве, найти вершинное покрытие в дереве и тому подобное. Алгоритмы для задачи можно классифицировать: в зависимости от выбора параметра вы получаете относительно него либо эффективный алгоритм, либо неэффективный. Давайте я расскажу о классах сложности, которые здесь возникают, — так или иначе это будет нашим основным интересом. Приятная особенность курса в том, что нам не придётся глубоко вдаваться в их формальные определения и связи: мы фокусируемся на параметрах, алгоритмах и структуре графов.
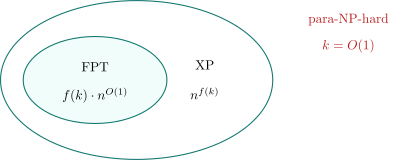
Аспекты сложности возникают у нас лишь постольку-поскольку. Итак, что такое самый удачный выбор параметра для NP-трудной задачи? Сначала договоримся об обозначениях: параметр мы будем, как правило, называть k; формально это функция, но работать мы будем именно с обозначением k. Какой самый лучший эффективный алгоритм относительно параметра k можно получить? Лучшее время работы — такое, в котором полином изолирован от параметра: f от k, умноженное на некоторый полином. Это самое хорошее, чего можно добиться в зависимости от параметра; такие алгоритмы называются FPT-алгоритмами.
Сама аббревиатура нужна просто для того, чтобы быстро ссылаться на такое время работы. А какая зависимость может быть хуже, чем FPT, но всё ещё более-менее приемлемой? Назовите не аббревиатуру, а само время работы. Верно: n в степени f от k. Такое время называется XP. Как всё это расшифровывается? FPT — fixed parameter tractable, XP — slice-wise polynomial; откуда в этих названиях взялись именно такие слова, не вполне понятно. Если вы помните схемы приближения, где фиксируется эпсилон и ищется приближённое решение, там встречаются те же два типа времени работы: зависимость от эпсилон может сидеть в степени полинома, как здесь, а может быть вынесена наружу — это ровно такие же два варианта.
Подумайте сами, что происходит с ростом размера графа и с ростом параметра. В XP-случае всё устроено просто: если параметр — константа, то полином всегда один и тот же. А если параметр константен в FPT-времени, то он лишь добавляет мультипликативный множитель ко времени работы. Иногда же мы можем доказать следующее: задача остаётся NP-трудной даже при константном значении параметра. Это называется para-NP-hard: NP-трудность при некотором константном значении k. То есть бывают слишком слабые параметры: они не накладывают на граф сильных ограничений, и задача остаётся NP-трудной.
Для хроматического числа такой параметр — например, максимальная степень графа: обозначает максимальную степень графа. Это вполне законный параметр. Но вспомните, какая у нас идея: для вычислительных задач мы подбираем параметры так, чтобы существовали эффективные алгоритмы. Некоторые параметры эффективных алгоритмов всё равно не допускают — например, максимальная степень для хроматического числа. А именно: можно построить графы, в которых максимальная степень равна всего 4, и на них уже будет NP-трудно раскрасить граф в 3 или 4 цвета — точную формулировку я сейчас не воспроизведу, это просто пример того, что параметры бывают неудачными.
Этот аспект понятен?
— Если сужаться на графах, то понятно.
А почему именно «сужаться»? Давайте пойдём от обратного. Предположим, я хочу доказать, что для некоторой задачи есть алгоритм за n в степени f от k — скажем, за n в степени f от дельта на произвольных графах. Тогда на графах, в которых дельта равна 4, это должен быть просто полином, согласны? То есть если бы такой алгоритм существовал, то, получив граф максимальной степени 4, я обязан был бы решать задачу за полином. Но я могу доказать, что эта задача NP-трудна.
Когда сводят, например, 3SAT к хроматическому числу — это для тех, кому понятно и интересно; возможно, мы к этому ещё перейдём, — из булевой формулы получается граф, в котором максимальная степень равна 4, и всё: полиномиального алгоритма не выйдет. Есть вопросы?
— Получается, в определении para-NP-hard стоят кванторы: существует k и существует граф, на котором будем работать? Какие там кванторы?
Хорошо, давайте поясним, какие там кванторы, — такого вопроса я не ожидал, так что подумаем, как правильно на него ответить. Смотрите: есть задача — хроматическое число. Мы знаем, что она NP-трудна; доказательств можно найти множество или провести самим, как хотите, и никаких ограничений на граф там не накладывается. Но задачу можно сузить и рассматривать хроматическое число только на графах с максимальной степенью 4 — то есть сузить набор возможных входов: во всех допустимых входах максимальная степень не превышает 4. Какой тогда остаётся вопрос про кванторы?
Итак, когда мы называем задачу para-NP-hard? Когда задача NP-трудна на графах, в которых k равняется константе: найдётся такое константное k, что задача NP-трудна на графах с от G, меньшим либо равным k. Так понятнее? Это не самые приятные части рассуждения: если они остаются непонятными, о них стоит отдельно подумать.
Distance to triviality, вычисление параметров
Мы с вами будем в основном разрабатывать алгоритмы, а не заниматься нижними оценками, хотя и к нижним оценкам мы со временем придём. Пока вопросов не возникло, я продолжаю.
— А рассматривается ли множественный параметр? Когда параметры несравнимы, и время имеет вид f(k, l)?
— Да, так делают. Когда совсем трудно, берут два параметра и предполагают, что ограничены оба. Если мы не можем решить задачу, мы облегчаем её себе — и нередко в итоге решаем и исходную задачу, потому что промежуточные результаты подсказывают идеи, которые затем удаётся развить.
Я сейчас немного об этом расскажу. Итак, про эффективные алгоритмы мы поговорили, пока достаточно поверхностно; про нижние оценки я пока не говорю — мы будем стремиться просто разрабатывать эффективные алгоритмы, и в основном они пока будут именно такого вида. Со временем появятся и XP-алгоритмы, но это по ходу дела. Возникает несколько интересных вопросов. Прежде всего: какова вообще цель всей этой области, зачем она нужна? Для этой мотивации я, пожалуй, ничего записывать не буду. Одна причина проста: людям нужно что-то придумывать, и в этой области действительно возникают разные интересные идеи — эффективные алгоритмы относительно структурных параметров.
Вторая идея такова: мы хотели бы, чтобы параметры хорошо описывали задачи из реальной жизни. Мы знаем, например, что вычисление хроматического числа NP-трудно, но понимаем, что бывают входы, на которых оно считается не так уж трудно — именно из-за устройства входа. У нас есть worst-case complexity, то есть в худшем случае задачу решить нельзя, но задачи из реальной жизни часто обладают специфической структурой. Отсюда одна из мотиваций: давайте найдём хороший параметр, который описывает структуру входа, то есть на наших входных данных ограничен.
Например, граф очень похож на дерево: вам дана компьютерная сеть, она почти дерево, и соответствующий параметр будет маленьким. Или в графе есть центр, к которому всё подключено, — это похоже на вершинное покрытие: есть большой кластер, к которому независимо подключены узлы, и вершинное покрытие может оказаться маленьким. Конечно, реальная жизнь гораздо строже к нам, и случайный шум может сильно увеличивать параметры графов, но тем не менее из этого получается хорошая математика, и какие-то идеи из неё можно применять.
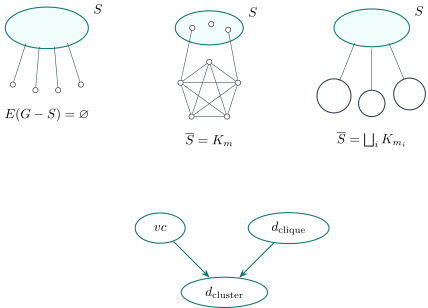
Это что касается мотивации. Теперь давайте предложим ещё какой-нибудь параметр. Откуда вообще можно брать параметры? Как я уже упоминал на примере вершинного покрытия, есть целый класс параметров, который называется distance to triviality. Что это такое? Это количество вершин, которые нужно удалить из графа, чтобы он стал каким-то простым. В случае вершинного покрытия это расстояние до пустого графа. Какая противоположная крайность пустого графа? Плотный граф. Соответствующий параметр так и называется — distance to clique, расстояние до полного графа.
Относительно него тоже можно эффективно решать задачи, и сейчас, если успеем, мы попробуем решить какую-нибудь задачу относительно этого параметра. Уточним, что здесь означает «расстояние»: это наименьшее число вершин, которые надо удалить. Заметим, что distance to clique — это vertex cover дополнения: если инвертировать все рёбра графа и посчитать вершинное покрытие полученного графа, это и будет distance to clique. Что интересно, эти параметры можно слить воедино, и так вполне делают: distance to cluster — расстояние до кластерного графа.
Давайте разберёмся, что такое кластерный граф. Это граф, в котором каждая компонента связности (КС) — полный граф. Посмотрим, как выглядят наши три картинки. Вершинное покрытие: в маленьком множестве произвольные рёбра, а снаружи остались независимые точки. Distance to clique: в маленьком множестве опять произвольные рёбра, а снаружи полный граф, и между ними какие-то соединения. Distance to cluster: в маленьком множестве S произвольные рёбра, а снаружи каждая компонента связности — просто клика. Что же можно сказать про эти три параметра?
Как они связаны между собой? Чем оба предыдущих случая являются по отношению к кластерному графу? Крайними случаями: клика — крайность кластерного графа, и независимое множество — тоже его крайность. Независимое множество — это кластерный граф, в котором все компоненты связности имеют размер один; клика — кластерный граф с единственной компонентой связности. Таким образом, мы уже можем построить первую, совсем маленькую иерархию параметров: distance to cluster обобщает и вершинное покрытие, и расстояние до клики. При этом сами эти два параметра, конечно, несравнимы. Думаю, вы без труда построите разделяющие семейства графов: достаточно взять клику.
У клики очень большое вершинное покрытие, а distance to clique равен нулю. И наоборот: чтобы вершинное покрытие было маленьким, возьмём граф вовсе без рёбер — его vertex cover равен нулю, а distance to clique очень большой. Значит, эти два параметра несравнимы. По такой диаграмме уже видно, как придумывать алгоритмы: можно взять задачу и попытаться решить её относительно параметра distance to cluster. Если это сложно, можно сначала придумать алгоритм относительно distance to clique: разработать алгоритм относительно меньшего параметра сложнее, зато такой алгоритм обобщит алгоритмы для обоих больших параметров.
Поясню смысл таких стрелочек: относительно того, что лежит ниже в иерархии, решать задачу сложнее, но алгоритм при этом покрывает более общие случаи. Хорошо. Остался один аспект, который мы не обсудили. Мы обсудили, что можно разрабатывать эффективные алгоритмы такого толка — и один такой алгоритм мы сегодня ещё должны рассмотреть; можно сравнивать параметры между собой. Но параметры должны быть хоть как-то мотивированы: если придумать параметр, который вовсе не вычисляется, вряд ли он нам нужен. Поэтому мы хотели бы ещё и вычислять сами параметры. Какая здесь мотивация? Просто у нас есть граф.
Мы хотим построить для него эффективный алгоритм, но для этого нужно понять, каков его параметр. Никто ведь не приходит и не говорит: «Я даю тебе граф с таким-то значением параметра». Поэтому параметры лучше уметь считать самостоятельно, чтобы всё было по-честному. В чём проблема? В том, что вычисление параметров — само по себе NP-трудная задача. Как из этого можно выкрутиться? Да, некоторые параметры вычисляются не NP-трудно — например, максимальная степень, но максимальная степень нам не особо подходит. Действительно, иногда параметры можно вычислить за полином — точное полиномиальное вычисление.
Или можно вычислить параметр приближённо.
— А можно просто перебирать k?
— Смотрите: когда мы решали задачу относительно вершинного покрытия, мы хотели, чтобы само это множество было выделено. Конечно, мы можем перебирать k — предположить, что у графа такой-то маленький параметр, — но нам всё равно придётся проверять, что параметр действительно такой. Например, что можно сделать с вершинным покрытием? Можно поступить как с максимальным паросочетанием: вершинное покрытие допускает приближение. Найдём максимальное паросочетание и возьмём все концы рёбер этого паросочетания.
Это даст 2-приближение. Бывают и другие способы вычисления — например, экспоненциальные алгоритмы. Стоит сказать, что это вообще отдельная история: очень часто мы просто считаем, что параметр нам дан, а задача его вычисления стоит отдельно — для неё существуют совершенно разные техники. Можно приближать, а можно, например, посчитать вершинное покрытие за время f(k), умноженное на полином: предполагаем, что вершинное покрытие равно k, и за такое время проверяем, что это действительно так. По ходу курса мы будем возвращаться к этому, если понадобится. Хорошо, давайте перейдём к интересной части — хватит общих рассуждений — и попробуем придумать что-нибудь относительно параметра distance to clique.
Рассмотрим другую эталонную задачу, одну из самых известных NP-трудных задач — Гамильтонов путь. Чтобы было веселее, назовём её «наидлиннейший путь». Что это за задача? Мы хотим найти в графе самый длинный простой путь, то есть путь, в котором никакая вершина не встречается дважды. Думаю, все хоть раз слышали про гамильтонов путь: это проверка того, что самый длинный путь имеет длину n — по количеству вершин. Задача коммивояжёра — из той же области, хотя она взвешенная; у нас сейчас простой вариант. Структура графа очень сильно помогает в этой задаче — давайте посмотрим, как. Со случаем вершинного покрытия можете потренироваться сами, там должно быть попроще, а мы разберём расстояние до клики.
Записывать я буду так: параметризуем задачу Longest Path параметром «расстояние до клики». Итак, у меня есть небольшое множество вершин S, такое, что всё снаружи — клика. Нам нужно придумать полный перебор, похожий на прежний. Вспомните, что мы делали с раскраской: мы фиксировали раскраску этого множества, а затем докрашивали остальные вершины. Теперь задача другого толка — я специально взял не хроматическое число, а гамильтонов путь. Давайте подумаем три минуты, как это можно было бы сделать: что-то перебрать про вершины множества S — возможно, что-то ограниченное — и в итоге решить задачу о наидлиннейшем пути.
Если возникают идеи, говорите. Скажу, что такое S: это так называемый модулятор до клики; дальше я, вероятно, буду обращаться к нему просто как к модулятору. Это как раз множество вершин, которые нужно удалить, чтобы граф стал кликой. Внутри S рёбра могут быть, а могут не быть; между S и остальным графом тоже могут идти совершенно произвольные рёбра. Базовая мысль — минимальная подсказка — такова: вершины множества S опорные, про них можно перебирать практически всё что угодно. А вот у внешних вершин во многом одинаковая роль — к тому же они образуют клику, — поэтому про них нужно перебирать что-то небольшое.
К сожалению, совсем независимо обработать их здесь не получится. Итак, что можно перебрать про множество S применительно к пути? Во-первых, заметьте: у нас не гамильтонов путь, а наидлиннейший, поэтому логично сначала перебрать, какие из этих вершин вообще входят в ответ, а потом — их порядок. Обозначим параметр через d; такой перебор — это 2 в степени d, умноженное на d факториал. За функциями мы сегодня не следим, подойдёт любая f(d): наша сегодняшняя цель — уловить концепт. Итак, мы перебрали, как вершины из S входят в ответ: мы знаем, что путь устроен так — кусочек вершин не из S, вершина из S, вершина из S, снова кусочек вершин не из S, и так далее.
Как вы думаете, какие вершины в этих кусочках не важны?
— Все, из которых прошлые и предыдущие.
— Уточню вопрос: какие вершины снаружи S здесь не важны? Я не очень понял, что вы предлагаете.
Longest Path, max leaf number, treewidth
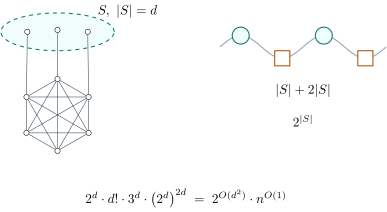
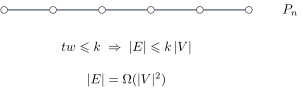
Да, конечно. Суть в том, что вершины, которые в пути лежат рядом с модулятором, особой роли не играют. Выделенным кружком я рисую вершины из S, а вершины снаружи буду отмечать квадратиком. Почему вершины-квадратики не важны? Потому что такую вершину можно вытащить из пути и вставить в любое другое место графа. Получается, что интересных вершин очень мало: вершин из модулятора плюс — поскольку у каждой вершины в пути не больше двух соседей — вершин из клики.
Отлично, XP-алгоритм мы уже получили. Почему? Вершин из клики не больше, чем n, и мы имеем порядка n в степени 2|S| вариантов: перебираем, какие вершины из клики взять, вставляем их в путь и проверяем, что путь действительно строится, а все остальные вершины клики докидываем потом. Согласны с таким утверждением? Если непонятно — задайте вопрос. Да, верно: вся клика будет содержаться в пути. Вопрос лишь в том, сможем ли мы расставить выделенные вершины так, чтобы они склеились в путь. Если смогли — то и все остальные вершины клики можно докинуть. В каком-то смысле вершины клики нужны нам только для того, чтобы нанизать на ниточку эти |S| вершин в нужном порядке.
Если бы между ними и так уже были рёбра — впрочем, между соседними вершинами модулятора могло вообще не оказаться промежуточных вершин, это отдельный случай. Итак, XP-алгоритм получен. Теперь заметим, что вершины из клики не так уж различны. Когда вершины клики можно считать эквивалентными? Действительно, от вершины важно только множество её соседей в S: все соседи внутри клики у неё предопределены, и различаются вершины лишь соседями в S. Получается, что вершины делятся на классы эквивалентности — это буквально близнецы; выражаясь умными словами, их перестановка задаёт автоморфизм графа.
Такие вершины можно менять ролями, и ничего не изменится. Поэтому вариантов здесь очень мало — всего 2 в степени s классов эквивалентности. Как же тогда описывается искомый путь? Вот вершины множества S, их перестановку мы уже зафиксировали. А между ними стоят вершины, которые склеивают всё это в путь: в каждом промежутке либо ноль, либо одна, либо две вершины — это мы тоже можем перебрать. Для каждой из этих вершин есть 2 в степени s вариантов, и достаточно просто сказать: возьми представителя вот этого класса эквивалентности.
В конце останется лишь проверить, что ни из одного класса эквивалентности мы не набрали больше вершин, чем в нём есть. Итак, путь характеризуется перестановкой множества S, количеством понадобившихся вершин из каждого класса эквивалентности и их расстановкой. Если мы уложились в размеры классов, путь построен, а значит, в него докинутся и все остальные вершины клики. Это понятно? Могу разобрать что-то подробнее, друзья. Строго говоря, нужно формально доказывать два утверждения: если в этом графе существует путь, то найдётся и путь описанного вида; а в таком пути вершину можно задавать просто её классом эквивалентности.
Но это довольно утомительно и заняло бы минут тридцать, поэтому я этого не делаю — лучше задавайте вопросы. В научной статье это, конечно, надо доказывать формально, но мы здесь научную статью не пишем; главное, чтобы вы понимали, как это доказывается.
— В асимптотике получилось что-то вроде 3 в степени s, 2 в степени s?
— Давайте посмотрим. Множитель d факториал ушёл на перебор того, как выглядят вершины модулятора в пути. Дальше есть перебор того, сколько вершин стоит внутри каждого промежутка, — это константа в степени d, примерно 3 в степени d; d факториал всё равно доминирует. Остаётся самое опасное место, где могла бы возникнуть двойная экспонента, но, думаю, здесь она не возникнет. Нам нужно набрать из классов эквивалентности не больше 2d вершин — размер S у нас равен d. Классов эквивалентности 2 в степени d, и из них мы хотим выбрать порядка 2d штук.
Двойной экспоненты не получилось, но получилось 2 в степени d в квадрате. Это не значит, что мы останавливаемся: цель этой науки не в том, чтобы получить хоть какую-то зависимость и этим удовлетвориться. Это лишь первый шаг к ещё более эффективным алгоритмам. Пока что мы получили алгоритм порядка 2 в степени O от d в квадрате — обычно записывают именно так, потому что d факториал — это 2 в степени d log d, и он съедается этим множителем. Такой порядок люди, конечно, стремятся улучшать, если это релевантно для конкретного параметра. Возможно, стоит попытаться получить такой же алгоритм и для distance to cluster и улучшить его оценку.
Какие-нибудь вопросы? Хороший вопрос — давайте опишем процесс преобразования длинного пути в короткий путь-представитель. Каков вообще был план решения этой задачи? Мы брали очень длинный путь и выкидывали из него то, что можно вставить обратно. Сейчас станет ясно, откуда берётся тройка в степени. Оговорюсь: я не гарантирую, что показатель равен ровно d, — может быть и d плюс один, потому что промежутков d плюс один. Итак, у вас был очень длинный путь, в нём d вершин модулятора, а между ними — какие-то промежутки. Что может быть в промежутке? Вершин из клики там может не быть вовсе — просто две соседние вершины из модулятора, согласны?
Кивайте мне хотя бы. Здорово. Дальше: в промежутке может быть одна вершина, две вершины или больше, и всё промежуточное принадлежит клике. Мы с вами поняли, что из промежутка можно выкидывать вершины, если их там больше двух, ведь такую вершину можно вставить в любое место. Поэтому остаётся всего три варианта: ноль, одна или две вершины в промежутке — отсюда и 3 в степени d. В оставшееся время попытаюсь предложить дальнейшую мотивацию.
Параметры, которые мы сегодня рассмотрели, отражают не совсем то, что хотелось бы: они улавливают лишь очень простые графы. Например, они не покрывают такие графы, как путь: у пути и вершинное покрытие большое, и расстояние до клики большое. При этом путь — простейший класс графов, на котором, наверное, все невзвешенные задачи решаются за полиномиальное время. Поэтому нам ещё предстоит исследовать, какими бывают параметры. У меня на сегодня был ещё один параметр, но он довольно мутный: он мало кому нравится, а занимаются им просто потому, что он существует.
Я пытался найти в литературе, зачем этот параметр нужен, и ответ сводится к тому, что его зачем-то ввели в восьмидесятых. Тем не менее расскажу, что это такое. Параметр называется max leaf number — максимальное количество листьев в остовном дереве графа, то есть максимум числа листьев T по всем остовным деревьям T графа G. Графы у нас связные: несвязный граф, друзья, будет встречаться очень редко. Параметр странный: у пути он равен двум, и у цикла тоже двум, потому что остовные деревья цикла — только пути. К сожалению, этот параметр не такой удачный, как vertex cover или расстояние до клики, поэтому, возможно, что-то про него будет в домашнем задании — с ним интересно поработать, — но ничего особенно хорошего о нём сказать нельзя.
В том смысле, что непонятно, чем он крут и почему им надо заниматься. Какова вообще цель всей этой истории? Получать всё более и более хорошие параметры. За последние годы было придумано много разных параметров, и этим занимаются в том числе светила — лидеры мнений в науке: они тоже пытаются придумывать новые параметры, которые хорошо описывали бы структуру графов. И, как это называется в науке, the most celebrated parameter — это древесная ширина, treewidth. Мы к ней придём, друзья, скорее всего, где-то в середине курса.
Почему так? Древесная ширина — параметр, живущий сам по себе, и я не хотел бы делать курс только про неё. Чем она хороша? Она, например, обобщает вершинное покрытие и хорошо описывает деревья. В анонсе курса даже было написано: многие задачи мы умеем решать на деревьях — а что, если пойти дальше деревьев? Что, если граф будет чуть-чуть усложняться: насколько возрастает сложность алгоритмов? Примерно для этого и была придумана древесная ширина — не буквально для этого, но сегодня именно она отвечает на этот вопрос. У неё много хороших свойств; сейчас это центральный объект всей структурной теории графов.
И она, конечно, замечательна. Но, пожалуй, центральный вопрос этой области, на который пока никто толком не умеет отвечать, — какие хорошие параметры выбрать для плотных графов. Сейчас объясню. Что такое плотный граф? Смотрите: про большинство хороших параметров, таких как treewidth, сразу можно сказать, что если у графа treewidth не больше k, то число рёбер в нём не превосходит k, умноженного на число вершин. Я выбрал здесь обозначения E и V, чтобы было понятно: рёбра и вершины. Когда k — константа, в графе очень мало рёбер. Как видите, с кликами это никак не помогает работать.
Плотный граф — это граф, в котором число рёбер есть омега от квадрата числа вершин. Интуитивно можно рассуждать так: пустой граф — очень простой, и полный граф — тоже очень простой, пока у нас нет весов. Если веса есть, полный граф ничем не легче любого другого графа, потому что весами можно моделировать существование или отсутствие ребра. Большинство задач у нас будут невзвешенными — кроме случая древесной ширины: разреженные графы как раз хороши тем, что там всё получается даже с весами. Мы находимся в поисках параметра, который структурно включал бы в себя и пустые графы, и полные — то есть очень плотные.
Примерно такие параметры мы и будем рассматривать. Самый первый из них — это, конечно, distance to clique: у клики distance to clique равен нулю. На этом мы сегодня остановимся — получилось много всего, с миру по нитке. Я постараюсь выносить ценный материал в домашние задания: некоторые параметры будут разбираться именно там. Я также обещал, что мы построим большой граф параметров. Он пока в разработке, но он в планах и будет появляться потихоньку. Следите, пожалуйста, за чатом курса: там будут появляться домашнее задание, дедлайны и, вероятно, подробности по оцениванию.
Там же можно задавать вопросы по любым аспектам курса, а если хочется — пишите мне в личные сообщения. На этом всё, спасибо.