О чём курс и архитектура CPU: от такта до instruction level parallelism
Добрый вечер. Сегодня мы начинаем с вами вновь читать курс по видеокартам в Computer Science Space — уже второй раз. Нас интересуют вычисления на видеокартах широкого назначения, в общем случае, под разные задачи: в том числе сортировки массивов, в том числе смежные области — машинное обучение, компьютерная графика, рейтрейсинг и прочее. Но нужно понимать, что фокуса на чём-то конкретном нет, и поэтому, если вы думали, что здесь будет акцент на машинном обучении, то это не так, хотя что-то мы обсудим. Просто на всякий случай предупреждаю.
Цель курса, как мне кажется, в том, чтобы немного расширить мышление и узнать новую парадигму алгоритмов, а именно массовый параллелизм: случай, когда речь не про десятки потоков, а про десятки тысяч потоков. И, в принципе, просто это прикольно. Поэтому если у вас запрос примерно такой, то что-то похожее вы здесь найдёте.
Я занимаюсь этим профессионально в компании Agisoft вместе с коллегой, который тоже составлял этот курс, — Борис Симиютин; он, скорее всего, прочитает какие-то лекции тоже. Используем мы это для работы с картинками, потому что в картинках много пикселей: в каждой, например, может быть 10 мегапикселей, или 100 мегапикселей, или гигапиксель в каких-то сильно профессиональных случаях. И если вы хотите эти фотографии обработать, что-то в них найти, то, очевидно, каждый пиксель нужно учесть. Такой же по объёму вычислений случай — это монитор, который показывает вам перед глазами какую-то картинку, например в компьютерных играх: чем больше у вас разрешение монитора, тем сильнее всё тормозит, тем выше нагрузка на видеокарту. В этот момент нужно что-то очень мощное — это видеокарты, и чем-то они отличаются от процессора.
Для того чтобы на следующей лекции обсуждать, что такое видеокарты и чем они отличаются от процессора, сегодня мы в первую очередь поговорим о том, что есть в процессоре. Возможно, вам это уже рассказывали в архитектуре ЭВМ, в каких-то спецкурсах по C++, ассемблеру или чём-то ещё, но нужно поднять общий контекст. Я буду рад, если вы меня поправите или дополните: можно прямо в лекции поднимать руку и задавать вопросы, я более чем за интерактивный формат, потому что так гораздо интереснее и вам, и мне. Плюс есть чатик в Телеграме, в рамках которого вы тоже можете рассказать что-то интересное. Если я где-то сказал неправду — поправьте, пожалуйста, это будет интересно.
Итак, в чём состоит курс? План примерно такой; это домашние задания, и из них виден акцент на том, что мы будем обсуждать разные алгоритмы. На слайде он напечатан целиком, под заголовком «План курса, задания на github + экзамен» (экзамен в речи не упоминается ни разу, но он в плане есть): «— Введение в OpenCL/CUDA API; — Архитектура видеокарты; — Примеры оптимизаций с local memory; — Транспонирование, умножение матриц; — merge sort; — Разреженные матрицы; — Bitonic sort, radix sort; — LBVH construction + Ray Tracing; — Растеризация: Vulkan, Larrabee, cudaraster; — Ray marching (SDF, shadertoy); — Nanite в UE5: Real-time rendering полигональной модели любого размера». Где-то в конце LBVH construction вполне релевантна рейтрейсингу и компьютерной графике. Есть про умножение матриц — в первую очередь, наверное, умножение плотных матриц; впрочем, неважно, просто умножение матриц имеет некоторое отношение к машинному обучению.
В конце мы обсудим Nanite в Unreal Engine 5 просто потому, что, мне кажется, это, опять же, прикольно. И там есть некоторые инженерные дизайн-решения, которые, как мне кажется, хорошо иллюстрируют подход к тому, как нужно решать сложные технические задачи. Потому что, когда через эту призму посмотришь на сложную систему, она всё ещё восхищает, но уже не кажется волшебной или каким-то открытием: кажется, что это почти обречённый на такой исход в этой формулировке путь исследования.
Дальше — требования к слушателям курса. Это сложно определить формально; на самом деле подразумевается в том числе, что вы что-то знаете про олимпиадное программирование на каком-то совсем базовом уровне, но тем не менее понимаете, что такое асимптотический анализ, и в целом чувствуете себя комфортно, когда речь заходит, например, о сортировках. Не обязательно помнить всё наизусть, но если вы, слушая про merge sort, думаете «ну да, вроде бы понятно», — это то, что ожидается.
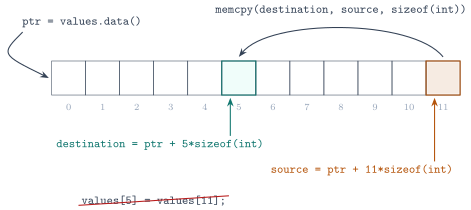
Что ожидается в техническом плане про языки программирования? Например, в случае C++ это должно быть понятно. Слайд формулирует это так: «Самое сложное, что встретим в C++, — арифметика над указателями». У нас есть какой-то массив, мы обращаемся к элементу по индексу, в данном случае к 11-му индексу, и кладём его на 5-й индекс, записываем: values[5] = values[11];. Это иллюстрация, которую я хотел показать, чтобы было понятно, что ожидается: вы всё-таки в состоянии — может быть, не сходу, но хотя бы волевым усилием заставив себя терпеть C++ — закодить операцию с арифметикой на указателях.
В данном случае с помощью memcpy мы можем реализовать то же самое. Берём указатель на начало массива, отсчитываем 11 позиций и тем самым находим адрес, откуда брать данные; точно так же рассчитываем адрес, куда мы хотим положить данные, — на пятый индекс. Что такое байты, указатели в байтах: sizeof говорит, сколько байт в int; можно было бы умножить на 4, потому что все мы знаем, что int — это 4 байта. Вот это примерно те вещи, которые считаются уже известными. В результате это превращается в трансфер данных, в данном случае 4 байт: вызываем memcpy — и мы получили результат.
На слайде строка values[5] = values[11]; перечёркнута красным, а под ней по шагам собирается эквивалент на указателях — в этом весь смысл примера:
void* memcpy(void* destination, const void* source, size_t bytes_count);

int main() {
    std::vector<int> values;
    values[5] = values[11];                      // ← зачёркнуто

    void *ptr = values.data();                   // адрес первого элемента в values

    void *source      = ptr + 11 * sizeof(int);  // откуда
    void *destination = ptr +  5 * sizeof(int);  // куда
    size_t bytes_count =        sizeof(int);     // сколько байт
    memcpy(destination, source, bytes_count);    // копируем
}
Соответственно, это то, что ожидается. Ожидается, что вы знаете: считать массив — это уже асимптотика линейная, на слайде . Если мы хотим сравнить каждую пару чисел, то это квадрат — . Там же слайд перечисляет сортировки, которые считаются знакомыми: bitonic/merge/radix sort.
В принципе, это всё, потому что даже обёртку, библиотеку, писать самому не придётся. Если говорить о Vulkan — а в одном из заданий, если я правильно помню, он будет использоваться, — [неразборчиво] писать самому, потому что, например, отрисовка треугольника занимает то ли тысячу, то ли пять тысяч строк кода. Это просто занимает много времени и не очень интересно, это скорее boilerplate-код, поэтому какая-то обёртка предлагается; но если очень хочется, можно её выкинуть и писать самому — пожалуйста. В случае CUDA и OpenCL это разумный объём работы, он вполне должен быть вам по силам, просто может быть медленнее. А акцент хочется сделать именно на kernels, на shaders — то есть на тех подпрограммах, которые уже запускаются на видеокарте и делают полезную нагрузку.
Использовать и кодить это всё можно на чём угодно. Слайд говорит об этом прямо: «Компьютер подойдёт любой — код можно будет запустить на CPU». Есть план, как это запускать на процессоре; если у вас будут с этим технические проблемы, пишите в чатик, и либо я отвечу, либо, может быть, кто-то из ваших однокурсников. Но это в целом проторённая дорога, и уже достаточно уверенно можно заявлять, что всё работает на процессоре — просто вы не будете видеть тех эффектов в перформансе и скорости, которые видны при запуске на видеокартах. Для этого ваше решение будет автоматически запускаться на одной и той же видеокарте; а также для того, чтобы был спортивный дух соревнования, потому что, очевидно, когда мы говорим про курс про перформанс, интересно узнать, у кого самое быстрое решение, а потом бороться за четвёртый знак после запятой и обогнать кого-то просто брутфорсом, заставив видеокарту расплавиться. В любом случае это интересно, особенно интересно межвременное соревнование с прошлым — а именно с прошлогодним курсом. Покажите, что человечество идёт вперёд, и это будет хорошо.
Итак, что нас интересует? Нас интересует архитектура процессора, чтобы дальше на его фоне увидеть в случае видеокарты некоторые вещи перекликающимися, а некоторые — видоизменёнными, адаптированными под какую-то задачу и какую-то специфику. Разделитель первой главы перечисляет всё, что в неё входит: «Глава 1: архитектура CPU — ALU, FPU, GFlops, FMA, Instruction Level Parallelism, Branch Prediction, Meltdown/Spectre, Cache Lines, Simultaneous Multithreading, Hyper-Threading, SIMD, SSE, AVX».
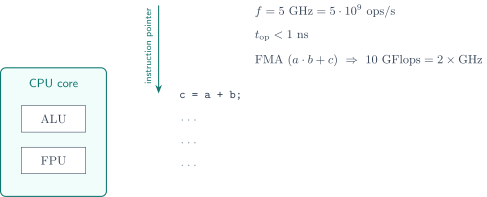
Процессор в нашей сейчас, естественно, упрощённой и ограниченной модели в первую очередь включает в себя арифметические юниты и floating point юниты — на слайде они расшифрованы как «ALU — Arithmetic Logical Unit» и «FPU — Floating-Point Unit». Очевидно, одни складывают целые числа, другие — числа с плавающей точкой. Может быть, там есть ещё какие-то специальные операции, но у нас пока такой высокоуровневый взгляд на этот мир.
В целом процессор работает — вы наверняка уже слышали — на какой-то частоте: когда покупаете процессор, там пишут 5 ГГц, 6 ГГц, 10 000 ГГц. У процессора сейчас около 5 ГГц. Знаете ли вы, сколько это? И сколько это чего?
— Миллиард.
Это миллиард, да. Гига — это в целом , и герц — это количество чего-то в секунду: например, вращений какой-нибудь турбины или чего-то ещё, а в случае процессора это количество тактов в секунду. Это 5 миллиардов операций — на слайде так и напечатано: «Делает это быстро! 5 GHz — операций в секунду!». Возникает естественный вопрос: каких операций? Ведь мы только что подсветили, что таких операций может быть как минимум два вида: логически-арифметические и числа с плавающей точкой.
Обычно речь про число с плавающей точкой или что-то такое — про самую примитивную операцию, которая в процессоре сделана прямо в железе и занимает ровно один такт. Вот эти 5 ГГц — это количество тактов в секунду. Более сложные операции у процессора могут быть и могут занимать несколько тактов. Поэтому 5 ГГц не имеет отношения к любой операции: 5 ГГц определяет самую минимальную операцию. Но пропорции тут обычно примерно одинаковые в зависимости от архитектуры.
Итого выходит, что на операцию наш процессор тратит меньше наносекунды — слайд так и пишет: «На операцию тратит меньше 1 наносекунды!». То есть супер-пупер быстро: если секунда бьётся на 5 миллиардов операций, то на каждую самую примитивную, идеальную операцию тратится одна пятимиллиардная секунды, то есть секунды — нс.
Гигафлопсы — их часто слышат — это количество флопсов, floating point операций, то есть операций с плавающей точкой; слайд расшифровывает это как «Giga-Floating point operations per second». Это одна из двух, наверное, основных метрик, которые можно услышать и про видеокарты, и про процессоры в том числе. По сути, она нам говорит, насколько быстро можно складывать числа. Речь идёт, естественно, обычно про сумму — их, по-моему, и считают. Будем считать, например, что у процессора 10 гигафлопсов у одного ядра, у одного потока; на слайде это записано с той же оговоркой: «Условно у одного ядра CPU 10 GFlops». Это, опять же, очень условно и не так важно.
В целом считают, очевидно, те флопсы, которых больше всего, а больше всего процессор пытается делать тех флопсов, которые нужнее всего. Поэтому, слава богу, это не такой уж совсем бенчмаксинг, а довольно разумная метрика. Обычно в этом случае считают FMA-операции — fused multiply-add, — потому что очень часто мы хотим добавить к аккумулятору перемноженные два числа. Например, когда мы считаем какое-нибудь скалярное произведение векторов — лучшее, что пришло в голову; наверное, какая-нибудь ещё метрика тоже часто такое считает, но в целом это частый случай. Слайд договаривает то, что вслух не прозвучало: GFlops получается «в два раза больше, чем GHz, т. к. FMA операция: fused multiply-add — две операции за такт (a * b + c)» — именно отсюда из 5 ГГц получаются 10 GFlops.
Итак, что делает наш процессор? Складывает какие-то числа: например, берёт переменные a, b, суммирует их и кладёт в c. У нас есть некоторый instruction pointer, и он говорит, что сейчас за операция делается. Когда эта операция декодирована и выполняется, она неизбежно выполняется в несколько этапов, потому что, как минимум, нам нужно взять данные a и b — например, их нужно загрузить из оперативной памяти. Затем они оказываются, казалось бы, где? Знаете ли вы, где они окажутся? Что с ними станет? Наверное, в регистрах.
Это можно воспринимать как такой рабочий стол, на котором процессор, прежде чем делать какую-то операцию, хочет получить все данные, которые для этого необходимы. Очевидно, instruction pointer тоже является необходимой частью его функционирования и тоже лежит в специальном, специально выделенном для этого регистре — слайд задаёт этот вопрос прямо: «где хранится?». При загрузке в эти регистры данные могут быть разной битности в зависимости от архитектуры процессора; сейчас можно, не теряя общности, считать, что у нас 64-битные регистры — на слайде так и подписано, «в регистры (64-битные)». Понятно, что есть ещё специальные, отдельно выделенные большие регистры, о них мы поговорим чуть позже, но в целом вот это — битность архитектуры.
Какой-нибудь instruction pointer или указатель на адрес памяти тоже часто 64-битный. Слайд формулирует это вопросом: «указатели в таких регистрах позволяют адресовать какой максимальный объём памяти?». Понятно, что если бы у нас был 32-битный адрес памяти — а адрес памяти тоже должен уметь оказаться в регистре, — то он адресовал бы всего лишь 4 гигабайта памяти, то есть байт, и это бы нас сильно стесняло.
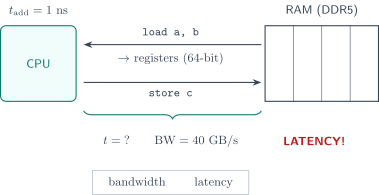
В результате всё это у нас находится в регистрах: прежде чем делать какую-то операцию, все данные должны там оказаться, и они туда грузятся. Если мы за одну наносекунду умеем делать арифметическую операцию, то возникает вопрос, как это соотносится в пропорциях с тем, как быстро мы подгрузим эти данные из памяти. На слайде появляется и само число, и вопрос: «DDR5 memory bandwidth: 40 GB/s» и красное «Сколько времени?» с синей скобкой, охватывающей загрузку a, b и запись c. Если я вам скажу, что скорость загрузки из памяти — точнее, пропускная способность загрузки памяти — 40 гигабайт в секунду, то кто побеждает в этом уравнении? Что является узким местом: подгрузка данных (ну или запись данных — давайте пока опустим запись) или операция? Почему подгрузка данных?
— Всегда так как-то.
[реплика лектора неразборчива] Давайте мы сейчас выведем это из базовых принципов. Вот у нас есть числа, давайте проведём анализ. Тут даже вроде не такие плохие, относительно подогнанные числа: 40 ГБ/с на два 32-битных операнда, то есть на 8 байт, дают пар операндов в секунду — ровно те же 5 ГГц, что и частота; само это деление вслух не проговаривается. Нас интересует, сколько времени займёт подгрузка a и b, а у нас на самом деле нет информации про это, если строго говорить, потому что это пропускная способность памяти — это сколько гигабайт в секунду протаскивается по шине. При этом время подгрузки данных может занимать даже 10 секунд. У нас просто нет здесь этой информации объективно.
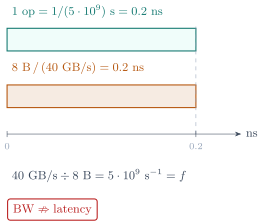
Естественно, в этот момент возникает очень большая зависимость от того, влезают наши данные, с которыми мы работаем, в кэш или нет. Если, например, мы суммируем два огромных гигабайтных массива, которые не влезают ни в какой сейчас разумный кэш, то тогда не будет никакого идеального паттерна доступа в кэш: у нас будет доступ в память, и мы будем действительно по ней грузить. Может быть, достаточно комфортно будем грузить, может быть, даже насытим вот эту пропускную способность, но оно будет с большой задержкой.
Итого, действительно, обычно доступ к памяти — узкое место, просто потому что инициировать этот трансфер и дождаться, пока он дойдёт до процессора, долго. Мне, во всяком случае, комфортно смотреть на это так, что жизнь устроена следующим образом: процессор — это относительно маленькая точка, внутри которой информация из одной точки в другую достигается достаточно быстро. Если же мы говорим про память, это вообще внешний модуль, до него какой-то путь, и вот оно там идёт, бежит; у меня такая модель мира — байтики, они там долго идут. Это, наверное, ещё и хорошо иллюстрирует, почему какой-нибудь кэш у процессора находится прямо на чипе процессора: как только он чуть-чуть дальше — всё, мы продолбались, и он не будет так эффективен, как мы хотим.
То есть latency в этот момент становится крайне важна — ровно на этих словах на слайде появляется красное «LATENCY!!!!11111». Нас часто интересует именно задержка, а не пропускная способность. В частности, процессор в целом довольно хорош как раз тем, что он очень быстро делает небольшое количество операций, и за счёт этого может быстро делать операции в операционной системе. Если мы хотим быстро закрыть окошко, перетащить его, ещё что-то — всё это требует быстрой интерактивной реакции, минимальной задержки. Процессор всячески пытается этого добиться высокой частотой, ну и, как мы уже обсудили, кэшами.
Итого, две черты нас интересуют в оперативной памяти — слайд сводит их к двум пунктам под планкой памяти, «bandwidth» и «latency». Пропускная способность — сколько в целом мы можем тащить данных, если у нас большая по рабочей нагрузке задача. И как долго ждать очередной запрос, если мы вдруг решили, что нам нужны именно эти данные.
Давайте посмотрим на эти две операции. На слайде к строке c = a + b; добавляется вторая, f = d + e;, и синяя скобка с красным вопросом: «Как ускорить?». Если мы признали, что latency оперативной памяти оказалась узким местом, которое гораздо больше нас сдерживает, чем число операций, которые делает процессор, — потому что каждую операцию он делает буквально за один такт, если данные уже в регистрах, — то какие проблемы мы видим с этими двумя операциями? А проблема — это потенциал для ускорения. Да, мы на 100 % не используем способность памяти, причём используем её совсем грустно: в тот момент, когда мы грузим данные в первой строчке, когда мы, например, захотели подгрузить a и b, инициировали этот процесс, он начался — мы сидим и ждём, пока оно [неразборчиво; по смыслу — «на процессор»] придёт.
Причём оно даже ещё не началось: мы отправили своё письмецо, оно там декодируется, что-то происходит, шины инициируют трансфер, оно идёт, нам наконец прилетело это в лоб, мы проснулись, начинаем суммировать. За один такт моментально просуммировали — и опять пишем эти данные в память, где лежит c. Но это очень грустно. Что можно было бы улучшить? Например, мы могли бы не просто загрузить a и не просто инициировать a и b одновременно, чтобы они вместе уже эту latency, эту задержку оплачивали, — а пытаться сделать это сразу для всех четырёх переменных: a, b, d и e. Потому что они буквально независимы: эти операции как side effect друг на друга никак не воздействуют, а значит, их можно выполнить в любом порядке.
Можно ли сделать запись в c, как вы думаете, таким же образом, одновременно с подгрузкой a и b?
— Может, они ссылаются на одно и то же место в памяти?
Это хороший вопрос. Если они ссылаются на одно и то же место в памяти, то это проблема, это причина, почему есть какой-то модификатор. Я никогда в жизни его не писал — наверное, extern. Не extern, а volatile или кто-нибудь. Или там ещё какое-то слово, restricted. Вот, я даже не знаю. (Точнее: ключевое слово из C99 называется restrict, в GCC и Clang — __restrict__; volatile и extern к алиасингу указателей отношения не имеют.) Что-нибудь из этого может быть как раз по поводу того, чтобы подсказать компилятору, что два указателя точно не пересекаются в адресах памяти, чтобы он не гарантировал какую-то там линеаризуемость, что-нибудь про гонки, — абсолютно неважно. В общем, здесь ничего про это нет: разные буквы — разные адреса.
— А вы сказали, как сделать так, чтобы одной операцией это всё сделалось?
Есть архитектуры, в которых mem-mem операции, — если вы о чём? Я имел в виду очень простую вещь: конкретно здесь мы хотели увидеть потенциал — что если у нас есть две таких операции, то между ними нет зависимости на чтение и вообще на сайд-эффекты. Поэтому мы можем подгрузку четырёх сделать одновременно — запустить её, инициировать; она может с небольшой задержкой, но в принципе одновременно происходит. Потом просуммировать и отправить две операции записи одновременно: они летят в сторону c и f, а мы дальше побежали.
— Можно использовать типа AVX или NEON.
Можно что-нибудь типа AVX, но я на самом деле клонил к более простой штуке — это часто называется instruction level parallelism. Мы здесь говорили «делать что-то одновременно»; обычно подразумевается многопоточность, но здесь это происходит само собой, прямо в рамках конвейера процессора. На слайде в этот момент появляется третья строка, x = c + f;, где c обведено красным, а f — фиолетовым: это и есть зависимость по данным между третьей строкой и первыми двумя; вслух эта строка не читается, но именно она объясняет, почему первые две операции независимы, а третья — нет. Следующий слайд подписывает скобку: «ILP — Instruction Level Parallelism» и «(out-of-order execution)».
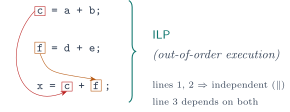
И это происходит не только про операции вроде «просуммировать» и операции вроде «инициировать подгрузку данных», но в том числе про разные другие вещи — такие как взять по instruction pointer и декодировать инструкцию, которую нужно выполнить, и прочее-прочее. То есть у нас есть сила процессора по подглядыванию в будущее, по одновременному исполнению в конвейере разных операций; за счёт этого он пытается выжать максимум вообще всего, что только может, из своих ресурсов. А его ресурсы включают разные вычислительные модули: операции арифметические, с плавающей точкой и прочее-прочее. Мы не сильно вдаёмся, какие там ещё есть вещи. Очевидно, и работа с кэшом, и с памятью — всё это потенциально многое может пересекаться.
В этот момент возникает потенциальное out-of-order исполнение — в противовес in-order исполнению, в котором всё идёт подряд, просто по порядку операций. Всегда ли мы можем перетасовывать исполнение операций? А когда не можем?
— Ассоциативность?
Ну да, наверное, это математический способ сказать, что можно менять порядок. Если можно менять порядок, то можно менять порядок. В смысле программирования это обычно формулируется как наличие или отсутствие сайд-эффекта у какой-то операции. Потому что если, например, какая-то операция может спровоцировать деление на ноль, которое должно спровоцировать остановку программы, то какая-то более поздняя операция, например пишущая на диск, не имеет права начать выполняться до того, как мы поймём, приведёт деление на ноль к проблемам или нет.
В частности, тут можно тоже задаться вопросом: а что нам делать, если у нас две операции, которые мы только что так здорово распараллелили через instruction level parallelism, находятся в разных ветках? Слайд в этот момент заменяет код на if (a < b) { c = d + e; } else { f = h + g; } и ставит красный вопрос «Что делать?». Сможем ли мы что-то хорошее сделать?
— (реплика из аудитории неразборчива)
Ну да, то есть тут много вариантов. Во-первых, нам не нужно делать одновременно эти две штуки. Но давайте, например, сфокусируемся на этих двух операциях: подгрузить a, b, сравнить их, подгрузить c, d, просуммировать их и так далее. И действительно, нам становится очень важна именно эта возможность представить, что у нас нету if‘ов, — ведь в большинстве случаев if — это проверка, что индекс не выходит за пределы массива, и он почти всегда не выходит. Поэтому мы статистически могли бы очень сильно это проэксплуатировать и видеть наши инструкции в такой примитивной модели мира, когда инструкции тупо идут подряд и нигде код не ветвится. Было бы соблазнительно жить в такой парадигме — и это достигается через предсказание ветвления кода.
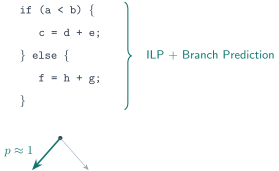
Это очень хорошо исследованная задача, в которой борются уже, я не знаю, за какие девятки после процентов вероятностей; в том числе в процессоры уже пихали нейросетки ещё давно, до больших языковых моделей. Но тем не менее, в общем, с помощью этого это можно сделать — в случае for‘а.
Спекулятивное исполнение и его цена: branch prediction, Meltdown/Spectre и иерархия памяти
Давайте, например, сфокусируемся на этих двух операциях: подгрузить a, b, сравнить их, подгрузить c, d — ну, d и e просто — просуммировать их, и так далее. И действительно, как вы сказали, нам становится очень важна вот эта возможность представить, что у нас нет if-ов. Ведь в большинстве случаев if — это проверка, что индекс не выходит за пределы массива, и он почти всегда не выходит. Поэтому мы статистически могли бы очень сильно это заабузить, заэксплуатировать и видеть наши инструкции в такой примитивной модели мира, когда инструкции тупо подряд и нигде код не ветвится. Было бы соблазнительно жить в такой парадигме — и это достигается через предсказание ветвления кода.
На слайде всё это время висит одна и та же врезка, которую лектор ни разу не читает вслух: «Умеет считать: ALU — Arithmetic Logical Unit, FPU — Floating-Point Unit. Делает это быстро! 5 GHz — операций в секунду! На операцию тратит меньше 1 наносекунды!» Вертикальная стрелка вдоль иконки ядра подписана instruction pointer. Фигурная скобка справа от кода сначала подписана «ILP — Instruction Level Parallelism», и красным рядом стоит вопрос «Что делать?» — именно на него и отвечает весь дальнейший разговор; на следующем кадре скобка читается уже как «ILP + Branch Prediction».
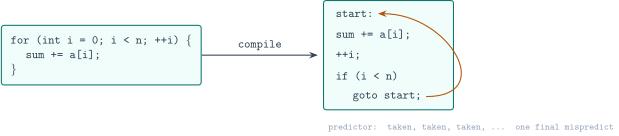
Это очень хорошо исследованная задача, в которой борются уже не знаю за какие девятки после процентов вероятности. В том числе в процессор уже пихали нейросетки ещё давно, до больших языковых моделей. В случае for‘а — то, что я сказал по поводу индекса в рамках массива, — for после компиляции превращается во что-то подобное:
start:
sum += a[i];
++i;
if (i < n)
    goto start;
На слайде от goto start; ведёт изогнутая стрелка назад, к метке start:. По факту нет никакого for, есть просто операция goto, и вот этот if гарантирует нам выполнение до тех пор, пока нас это всё интересует. И она почти всегда будет молотить, предсказывать правильно и прыгать, прыгать, прыгать. В какой-то момент она ошиблась: предсказание собиралось прыгнуть, начинает подгружать отсюда элемент, а поняв, что ошиблась, — ну, подгрузила и подгрузила, ладно, ничего с ним делать не будем, идём дальше.
Действительно, кажется, что подгрузка данных — это не просто «мы получили подарок, эти четыре байта», но ещё и разные сайд-эффекты. Например, сайд-эффект — это page fault, если мы обратились по элементу, по адресу которого у нас нет: будь то потому, что набагали, будь то потому, что у нас просто программа пытается сделать что-то сомнительного характера. Это тоже является сайд-эффектом, так же как является сайд-эффектом деление на ноль. Поэтому если мы, например, подгрузили b — или подгрузили бы — и успели начать делать операцию деления, то есть риск, что у нас вся программа упадёт.
Слайды формулируют это жёстче, чем речь, и эти надписи не произносятся. На одном из них код if (...) { a = b / value; }, фрагмент / value обведён красным, и рядом три красные реплики: «Деление на ноль!», «А что будет если value=0?», «А Branch Predictor не предупредили!!!». На следующем — то же самое для цикла: for (int i = 0; i < n; ++i) { sum += a[i]; }, красным обведено a[i], подписи — «Page Fault!», «А что будет если i за пределами a[]?» и снова «А Branch Predictor не предупредили!!!».
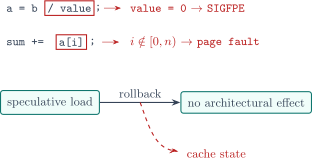
Очевидно, что это должно было быть как-то защищено — и действительно это защищено. Есть какой-то хитрый механизм, который branch prediction и начинает всё это исполнять, но у него есть механика: грубо говоря, откатывание или неприменение тех операций, которые влияют на более большую картину мира. Поэтому всё работает в порядке. Хотя когда-то давным-давно в школе мне учитель рассказывал, что был в пентиумах дефект, который вот этим делением крашил всё просто потому, что он думал, что branch prediction туда придёт, а по факту этот if мог и никогда не выполниться. Но сейчас я такого в жизни не встречал и даже не слышал, поэтому надо найти учителя и узнать, о чём он говорил; может быть, у него остался тот пентиум. (Известный дефект Pentium — это FDIV 1994 года: неверный результат деления, а не крах из-за спекулятивного исполнения; сам лектор помечает историю как школьное воспоминание, которое надо проверить.)
Но это пример page fault, то есть выхода за пределы массива. Поэтому branch prediction в этом смысле, мы полагаемся, сделан очень хорошо, никогда не облажается, и всё будет в порядке. Если вы вдруг думаете, что у вас падает программа потому, что это branch prediction, — скорее всего, вы занимаетесь самообманом. Шанс такой есть, но он крайне мал: если вы не можете доказать, что это так, скорее всего, вы ошибаетесь. Так же как и с компиляторами: компиляторы багают постоянно, но в большинстве случаев чаще багают именно программисты.
— То есть, по факту, при каком-то делении на ноль мы перейдём в обработчик ОС, и это можно как-то…
По идее, я думаю, что для вас никогда не должна различаться ситуация, существует ли branch prediction вообще или нет. Поэтому он не должен спровоцировать ничего, что вы можете заметить. Кроме перформанса, очевидно. Итого, instruction level parallelism и branch prediction — это не просто случайно появившиеся вещи и «делаем мы так всегда», а это вещи, которые нацелены на конкретные проблемы.
Почти все, мне кажется, хорошие алгоритмы, впечатляющие достижения, которые меня интересовали, отталкиваются от того, что есть какое-то целеполагание, какая-то боль, какая-то проблема. Например, люди голодные — появился Макдональдс; наверное, это так работает. И здесь точно так же. Была проблема с тем, что алгоритм часто упирается в доступ к памяти, была проблема с latency: оперативную память не смогли сделать быстрее, например, из-за физически большого расстояния до процессора — появляются кэши, появляется разный prefetching памяти, ещё что-нибудь. В instruction level parallelism проблема с ветвлением — поэтому нивелируем эту проблему branch prediction, и так далее, и так далее. Поэтому очевидно: сначала первичен анализ, а потом решение, потому что иначе вы, возможно, занимаетесь преждевременными оптимизациями или просто придумали красивую историю; если она ради красивой истории — это нормально, но если это просто ради целей, то лучше сначала цель изучить.
Хорошо. Итого, мы поняли, что instruction level parallelism, branch prediction и data prefetching не имеют побочных эффектов, из чего формально можно сделать вывод, что они не нужны. Ровно это красным спрашивает сам слайд: «Значит ли это что ILP + Branch Prediction + Data Pre-Fetching не имеют побочных эффектов? Может тогда они и не нужны?!» — обратите внимание, что третий механизм, Data Pre-Fetching, назван именно слайдом. Значит, где-то был обман. Ну да, они на скорость влияют. Я, к сожалению, до этого уже споверил [так в записи; по смыслу — «проспойлерил»: четыре расшифровки в разных условиях дают одно и то же несуществующее слово], но хорошо.
И это же влияет на то, что в какой-то момент, видимо, интересанты в кибербезопасности, назовём их так, обнаружили, что вообще-то говоря сайд-эффекты есть. И может быть, мы можем через них в обратную сторону узнать, что произошло всё-таки и не было скрыто от наших глаз до конца, и за счёт этого узнать какие-то данные, которые не были предназначены для наших глаз. И с помощью этого, например, эскалировать привилегии, каким-то образом получить рут-доступ и украсть все ваши биткоины. Заголовок слайда с этого места — «Архитектура CPU. Meltdown/Spectre уязвимости».
Делается это, условно, примерно таким образом. Код набирается на слайдах постепенно и целиком вслух ни разу не произносится, поэтому выпишу его так, как он напечатан:
myData         [N]   = [a, b, c, d]
myDataAndKernel[N+M] = [a, b, c, d, e, f, g, secret value]

while (true) {
    if (myData[ myDataAndKernel[ptr] ]) {   // много итераций ptr < N
        ...                                  // резко меняем ptr = N+K
    }                                        //              + break
}

for (int i = 0; i < N; ++i) {
    startTime = currentTime();
    ... = myData[i];                         // считываем каждый элемент
    time = currentTime() - startTime;
    if (time < typicalTyme) {
        // i - индекс по которому сработал pre-fetching, значит ptr[N+K] = i
    }
}
Две особенности слайда воспроизведены как есть: опечатка typicalTyme вместо typicalTime и запись ptr[N+K] = i в комментарии — ptr здесь индекс, а не массив, по смыслу имеется в виду myDataAndKernel[N+K] == i.
Представим, что у нас есть данные, к которым программа действительно имеет доступ, — a, b, c, d. Это один массив. Другой массив дублирует эти же данные a, b, c, d, причём они сами на себя ссылаются: если мы по этому адресу a считаем данные, то это опять будет a — вот такая стационарная точка, она сама на себя ссылается. А эти данные уже вне нашего юзерспейса: они там, не знаю, где-то хранят какие-то секреты, или там другой пользователь свои записи хранит. Это то, куда мы хотим добраться: конкретно этот secret value нас очень интересует. Мы, например, знаем, по какому он адресу — к этому сводится и случай, если нас интересует вообще всё: мы просто подряд все адреса будем пытаться вскрыть. Ну вот, условно, мы целимся туда.
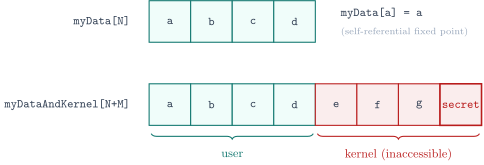
Что мы делаем? Мы прогреваем наш branch prediction, чтобы увидеть какой-то side effect и через него получить значение, которое лежит в этой интересной ячейке. Мы просто берём и очень долго обращаемся к этому массиву по корректному индексу, в рамках наших дозволенных адресов a, b, c или d. По полученному из этой ячейки элементу мы опять обращаемся к myData: если нам достался a, то мы обратились к a, ещё раз прочитали a рекурсивно; обратились к b — обратились к b опять, считали. И делаем так долго-долго. Потом внезапно берём и обращаемся за пределы.
Что произойдёт? Произойдёт page fault, операционная система нас накажет, процесс будет грохнут, что-нибудь такое хитрое. Скорее всего, не обязательно он будет грохнут, потому что мы можем отловить сигнал, который нам пошлёт операционная система, и так далее. И вот это мы и хотим дальше эксплуатировать: теперь мы хотим как-то на этих руинах выяснить, какой же секрет там был считан. Нам его не дадут — то есть вывести в консоль то, что здесь считалось, мы не можем. А что мы можем?
— (реплика из аудитории неразборчива)
Да, время доступа. Кажется, это вот и есть подсказка. Кажется, что если мы сделали всё грамотно и хорошенько прогрели обращение, то в момент, когда мы сделали некорректное обращение, prediction подскажет, что мы обращаемся в нужный нам адрес, нужно, конечно, загрузить эти данные; подгрузится элемент, попытается по нему сделать обращение и потом уже огребёт. Но до этого подгрузка в кэш произойдёт, а значит, ситуация изменилась, и вот этот secret value, адрес по этому числу, уже должен бы быть закэширован.
Значит, давайте просто возьмём и в этом массиве myData попытаемся считать каждый элемент — каждый элемент с каким-то таймером будем считывать. И тот, кто считывается, грубо говоря, быстро, — это тот, кто находится по индексу secret value. Здесь есть некоторые упрощения, очевидно: нужно было обращаться здесь по модулю размера N. Но мы всё равно получаем хотя бы какую-то информацию, а значит, через неё мы можем собрать этот secret value. Может быть, мы один бит из него узнаем — но этого в целом достаточно, чтобы за бесконечное время узнать вообще всё что угодно по любому адресу: например, по всем адресам, всю память, все данные.
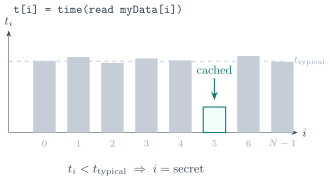
— Обратившись к myData[0], например, за ним всё идущее размера — не знаю, 512 или сколько там — всё в кэш попадёт, и дальше всё будет быстро нам попадать. Может, я что-то пропускаю сильно? (Размер кэш-линии на самом деле 64 байта.)
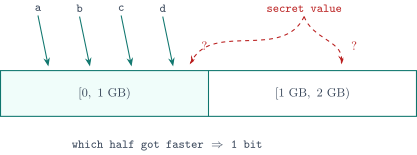
— Да. Ну, мы можем сделать, во-первых, большой массив, чтобы оно не попадало, и так далее. Во-вторых, мы можем подтасовать здесь индексы так, чтобы они кэшировали только часть этого массива. И, грубо говоря, нам достаточно сделать следующее. Давайте вот этот массив в голове у себя разобьём на две части: первая часть — гигабайт, вторая часть — гигабайт. И вот a, b, c, d долбятся в первую часть, не очень важно куда — в первую ячейку. А secret value — редкий случай, когда мы обращаемся по несчётному числу, да, типа.
Как нам это сделать? Либо он попадёт в первую часть, либо во вторую. Если во вторую — вторая ускорилась; если он попал в первую — вторая не ускорилась. Всё, это тоже информация. Нам нужно получить хоть какую-то информацию, мы сейчас неоптимальный способ ищем. И этот замер нам даст информацию о том, что закэшировалось; каким-то образом это нужно различать от кэшей, которые были закэшированы раньше, это справедливо, но вот направление мысли примерно такое.
— [неразборчиво] …как обращение к myData до индекса небольшого счёта даст? Почему myData входит во втором цикле? (Точная формулировка вопроса не восстанавливается; по ответу видно, что спрашивают, зачем мы перечитываем myData во втором цикле.)
— Да, потому что myData — это массив, который находится по этим адресам. Здесь мы с него что-то считываем, значит, каждое считывание кэширует что-то в памяти. Поэтому у нас есть два принципиальных типа ячеек в myData: те ячейки, которые закэшированы, и те, которые не закэшированы. Те, которые закэшированы, — это те, в которые мы обращались в рамках этого цикла while, то есть индексы, которые нам вернул myDataAndKernel и по которым мы потом обратились в myData. А мы это и хотим узнать: мы хотим, резко считав secret value, узнать, собственно, по какому индексу он спровоцировал доступ к myData. Потому что именно эта ячейка по адресу secret value считается в кэш, а значит, именно эта ячейка здесь будет быстро считываться.
Ну, мы его можем взять по модулю M. То есть мы пытаемся найти подсказку: мы сначала узнаем его последний битик, потом заново узнаю предпоследний битик, и так далее. Я помню, что когда-то очень давно узнал на работе — супер старое, когда-то давно, — что нужно, если у вас есть, например, в Java строчка, хранящая пароль, как только он использован, туда присвоить что-нибудь другое. И ещё, наверное, нужно сделать, чтобы она не попала в пул строчек какой-то. Неважно. В общем, речь о том, чтобы, если у вас есть какие-то секретные данные, они недолго были в памяти, причём не просто надеясь на то, что аллокатор их деаллоцирует [в записи — «доделагатор их заделацирует»; восстановлено по грамматике и смыслу, не по звуку], потому что он, может, вернул это в пул памяти, но они там всё в том же сыром виде лежат. А нужно ещё и затереть их какими-то данными.
Так же как и на диске: если вы просто удалите файлы, часть из них можно восстановить. Обычно не тогда, когда удалили случайно, но если вы удалили специально — скорее всего, всё восстановят. Поэтому, наверное, нужно затереть или дрелью много раз.
И интересные последствия от этого. Процессоры стали медленнее, стали бороться с этими техниками оптимизации. Слава богу, не начали выкидывать кэши, префетчинг и всё остальное, потому что иначе всё станет резко очень медленно, и никого это не устраивает. Но щупали какой-то компромисс, какое-то промежуточное решение, которое как минимум снизит скорость считывания таким образом данных, а в идеале сделает это невозможным как минимум через браузер, потому что через браузер уже совсем стрёмно. Если я захожу на какой-то процессор [так в записи; по смыслу — «на какой-то сайт», это оговорка лектора], если бы он ещё майнил на моём процессоре что-то — ещё куда ни шло; если он узнает все мои данные с компьютера, ну, я такое обычно не очень предпочитаю.
И решается это тем, чтобы лишить нас инструмента, который подсказывает нам, случился сайд-эффект или нет, — то есть способа узнать, насколько быстро происходит доступ к данным. А значит, таймер стал работать плохо, ну и очевидно, дальше геймдев в браузере стал испытывать некоторые проблемы, и фреймрейт стал дёрганым и прочее. Вот спасибо специалистам безопасности, которые это обнаружили. Конкретные числа есть только на слайде, в блоке «Последствия:»: «в JavaScript точность performance.now() стала секунд (ухудшили )» и «микрокодом добавили ограничений в branch predictor».
Теперь давайте, собственно, да?
— Когда мы узнаем сайд-эффект? То есть у нас сайд-эффект — это время, когда мы прочитали что-то, записать в кэш?
— Сайд-эффект — это попала ячейка по адресу secret value в кэш или не попала.
— И это мы узнаём на счёт времени.
Ну, опять же, там, скорее всего, не совсем так это делается. Может быть, там какой-то микробенчмарк делается, который как-то более тщательно это замеряет; я не вдавался в детали, высокоуровнево концепт такой. Я не помню, но там, по-моему, можно поймать — я не берусь утверждать, лучше спросите искусственный интеллект, например, — но почти наверняка можно поймать сигнал сегфолта. То есть как минимум на плюсах, например, bad allocation (std::bad_alloc) ловится тривиальнейше: вы можете аллоцировать огромные векторы, ничего плохого-то не будет. Это то, в чём я просто уверен сходу. А про доступ по некорректному адресу — ну, не уверен. Может быть, нельзя.
— А мы доступ не получим, мы не получили число.
А вот это хорошо, это уже тонкий дизайн. Я не знаю: я хотел, я такой — ну типа разберусь; примерно я разобрался, примерно вот я почувствовал — и вот на этом остановился. Если кто-то разберётся более детально, тонкие вопросы сформулирует, а дальше ещё и ответы напишет, то это будет супер — то подпишите в наш секретный чатик, я буду очень рад и через год с радостью добавлю эти комментарии.
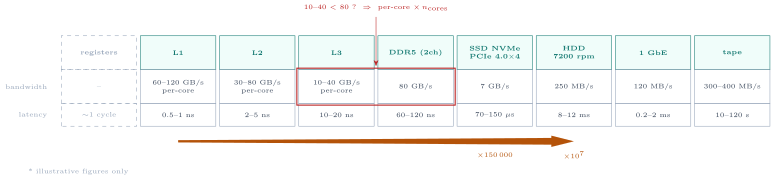
Итак, давайте обсудим, в целом какая у нас есть картина мира. Проблема с доступом к памяти, а именно с latency: в момент, когда мы резко захотели какой-то элемент из памяти, мы на самом деле очень сильно надеемся, что эти данные были в кэше, иначе доступ будет долгий и могут быть проблемы. Поэтому у нас есть некая иерархия данных. Есть совсем быстрые данные — здесь не написано, но это регистры: их мало, доступ к ним моментальный, буквально мы можем сделать за один такт суммирование двух элементов, которые были в регистрах. Мы даже не считаем их — это вот наши «под руками», может быть, даже «в руках».
Дальше — кэши нескольких уровней. Некоторые кэши на каждое ядро, некоторые кэши позволяют иметь доступ у других ядер: то ядро, которому кэш принадлежит, — для него ближе, для другого ядра этот же кэш доступен, но он дальше. Какие-нибудь чиплетные архитектуры на эту тему можно посмотреть.
Сама таблица на слайде набирается по столбцу за кадр, и её числа вслух не читаются, поэтому выпишу их полностью:
| Тип | L1 cache | L2 cache | L3 cache | DDR5 (2-channels) | SSD NVMe PCIe 4.0×4 (seq) | HDD 7200 rpm (seq) |
|---|---|---|---|---|---|---|
| Пропускная способность (bandwidth) | 60–120 GB/s per-core | 30–80 GB/s per-core | 10–40 GB/s per-core | 80 GB/s | 7 GB/s | 250 MB/s |
| Задержка доступа (latency) | ~0.5–1 нс | ~2–5 нс | ~10–20 нс | ~60–120 нс | ~70–150 мкс | ~8–12 мс |
Подпись растущей стрелки под строкой задержек меняется вместе с числом столбцов: x100, затем x150.000, затем x10.000.000. Красный кикер на первом кадре таблицы, тоже не прочитанный вслух: «Раз доступ к памяти настолько медленнее чем вычисления из регистров — промазываем L1/L2/L3/L4 кэшами!» — здесь назван L4, уровень, которого нет ни в таблице, ни в речи. И важная деталь: начиная со второго кадра таблицы внизу появляется сноска «* числа условные, все совпадения с реальностью — случайны». На первом кадре сноски ещё нет, так что сами по себе эти числа — иллюстрация, а не справочник по железу.
И здесь возникает вопрос — а как вы думаете, почему так получилось, что вот здесь тенденция линейная, относительно хотя бы она упорядочена, а здесь пропускная способность у памяти кажется выше, чем у кэша, сильно дольше по времени?
— (гипотеза из аудитории неразборчива)
Это справедливо, это справедливо, но вот до этого тенденции такой не было. Например, вот это число — ну, она сопоставима с этим. Но тем не менее. Мне кажется, что здесь просто на картинке нужно внимательно заметить словосочетание per-core: это просто на каждое ядро пропускная способность. А значит, если мы этот кэш будем использовать из всех ядер, то мы уже резко превысим эти 80 гигабайт в секунду. Сам слайд этот вопрос и ставит: пара «L3 cache / DDR5» обведена красной рамкой, над ней стоит «???», а между числами напечатано 10–40 < 80.
Но ваша гипотеза мне тоже нравится, потому что она бы была уже достаточной. Для меня это было бы уже причиной добавить в процессор, который я якобы создаю, L3-кэш — это уже было бы оправдано. Но здесь оправдано ещё сильнее, потому что суммарная способность кэша ещё больше. Первый кэш — у каждого ядра, второй кэш — у каждого ядра, насколько я помню, но почти наверняка так. У третьего кэша — у каждого свой, но они ещё имеют доступ к чужим. И получается асимметричный паттерн доступа и асимметричные задержки.
Вы можете себе представить — ну вот как Intel любила рассказывать про AMD-шные процессоры: «ну это на клей просто чиплетов натыкали, у нас-то монолит», — через два года у них тоже чиплеты, но неважно. И в каждом чиплете есть вычислительные железки, а есть, собственно, кэш. Но между ними есть коммуникация, потому что это всё ещё быстрее, чем лезть в оперативную память, потому что latency здесь скачет очень сильно. От 10, там, видимо, 20 — а вот 20, смотрите, оно ползло. Ну вот 6 раз скачок — это очень много. А задержка доступа в чужой кэш, грубо говоря, в два раза больше, чем вот до своего.
— Это наносекунда, да?
— Да.
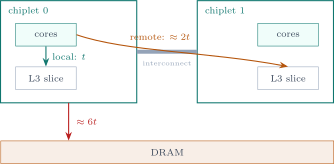
Ну и, соответственно, мы помним, что наносекунда — это что-то близкое к одному такту. То есть если процессор делает операцию в регистрах, это один такт, это вот единица наших измерений. Если он берёт эти данные с памяти — ну вот сразу в 100 раз медленнее. И нужно просто понимать, что доступ к памяти медленный. Хуже только доступ к жёсткому диску. А ещё хуже — доступ к магнитной ленте; там дальше будет, но неважно.
Давайте ещё посмотрим на картину мира с точки зрения того, какие у нас есть магистрали, шины доступа к данным. Если мы говорим про оперативную память, то вот до неё уже далековато. Дальше у нас самый крутой в мире SSD — тем не менее, до него доступ уже и сильно медленнее, и сильно дольше по задержке, «хотя, кстати, не так уж сильно дольше, чем DDR, но сильно медленнее» [так в записи; по его же таблице соотношение обратное: по задержке 70–150 мкс против 60–120 нс, то есть разрыв примерно в тысячу раз, а по пропускной способности 7 GB/s против 80 GB/s, то есть всего примерно в одиннадцать раз].
И доступ к нему идёт по так называемой PCI-шине. Возможно, если вы собирали компьютер, в котором 10 видеокарт, 20 SSD и прочее, оказывается, что с вас просят дополнительные деньги за более мощный процессор, у которого больше этих воображаемых PCI-линий. Кто-нибудь их видел? Я не видел. Вот и думайте. И, в общем-то, эта же PCI-линия используется для доступа к видеокарте. На слайде шины подписаны точно: столбец таблицы — SSD NVMe PCIe 4.0×4, а связка «оперативная память — видеопамять» — PCI-E 4.0 x16 в красной рамке.
Поэтому топологию можно видеть как процессор, доступ к оперативной памяти. От оперативной памяти эти PCI-линии могут тянуть данные в видеопамять, или в SSD, или ещё в какую-то периферию, которая тоже подключена — например, какие-нибудь Optane, интеловские странные, и прочее, прочее. Ну и здесь уже есть вычислитель видеокарты, его процессор, который, в свою очередь, находится в очень похожей ситуации с процессором: у него есть доступ к своей памяти, у него есть свои регистры и так далее, но это вот на следующей лекции мы обсудим.
Числа на этой схеме вслух не называются, а без них дальнейший вопрос теряет остроту. CPU — FLOPS, канал к RAM - DDR5 — 40 GB/s. GPU — FLOPS, канал к VRAM - GDDR6 — 1000 GB/s. Между оперативной памятью и видеопамятью — обведённая красным PCI-E 4.0 x16 на 8 GB/s, и отдельная изогнутая стрелка ведёт из столбца SSD в оперативную память. То есть по вычислениям видеокарта впереди в раз, а канал до неё в раз у́же, чем её собственная шина к видеопамяти. Заметьте, что колода здесь сама себе противоречит: в таблице DDR5 стоит 80 GB/s, а на схеме связь «процессор — оперативная память» подписана 40 GB/s; и то и другое накрыто сноской «числа условные».
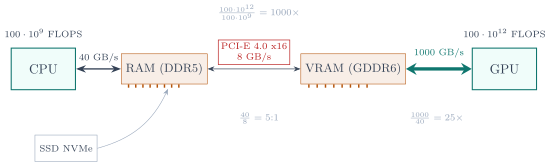
— Вот эта картина мира нам важна зачем, как вы думаете?
— Чтобы мы лишний раз не кидали память в видеокарту.
— Да, супер согласен.
— И быстрее вычислить на процессоре.
— Супер согласен. Идеальный пример следующий. Представьте, что у вас здесь лежит массив и другой массив, и вы хотите их просуммировать. Видеокарта гораздо быстрее просуммирует два массива, но лишь в том случае, если эти данные лежат в видеопамяти. Если нам нужно, чтобы посчитать эту задачку, отправить данные отсюда сюда, дальше моментально видеокарта посчитала, опять прогрузить результаты обратно, то мы просто вот этот путь проходим два раза — дольше, чем процессор напрямую посчитал бы сам. И поэтому маленькие задачи, в которых ещё и просто инициализация этого трансфера дороже, или большие задачи, но задачи, в которых не окупается вычислительно этот трансфер,
Иерархия памяти и многопоточность CPU
Супер, согласен. Идеальный пример следующий: представьте, что здесь лежит один массив и другой массив, и вы хотите их просуммировать. Видеокарта просуммирует два массива гораздо быстрее — но лишь в том случае, если эти данные уже лежат в видеопамяти. Если же для того, чтобы посчитать эту задачку, нужно отправить данные отсюда сюда, дальше видеокарта моментально посчитала, а потом прогрузить результаты обратно, то мы проходим этот путь дважды и тратим больше времени, чем если бы процессор посчитал напрямую сам. Поэтому маленькие задачи, в которых ещё и сама инициализация трансфера дороже вычислений, и большие задачи, в которых трансфер не окупается вычислительно, обречены и будут неизбежно считаться на процессоре.
— (реплика из аудитории неразборчива)
Не понял.
— (реплика из аудитории неразборчива)
Не понял, что я сейчас… То есть вопрос такой: с какого порога имеет смысл считать на видеокарте? Мне кажется, что здесь у нас уже почти все данные есть. Здесь нарисована пропускная способность доступа к видеопамяти и скорость в операциях. Конечно, остаётся вопрос, всегда ли достигаются эти числа, какие именно операции она действительно может сделать в таком объёме, и прочее, и прочее. Но концептуально нам достаточно примерно почувствовать несколько вещей.
Если мне нужно просуммировать два массива, я, по сути, на один байт делаю примерно одну операцию — на четыре байта одну операцию. То есть пропорция один к одному. А пропорция пропускной способности памяти к вычислениям какая? Давайте широко будем считать: здесь и здесь — то есть примерно один к одному. С точностью до 100 поправка у нас будет — абсолютно плевать. А у видеокарты пропорция: здесь и здесь , тоже примерно похоже; немножко перекошено, но близко.
На самом слайде эти числа подписаны явно, вслух они не проговариваются: у процессора и канал к памяти 40 ГБ/с (RAM - DDR5), у видеокарты и канал к своей памяти 1000 ГБ/с (VRAM - GDDR6), а между ними обведённая красным рамкой надпись PCI-E 4.0 x16, 8 GB/s. (Арифметически «примерно один к одному» здесь — сознательное огрубление: операции на байт у процессора против операций на байт у видеокарты, то есть разница в 40 раз; лектор читает напечатанные порядки и сам оговаривает право на такую грубость.)
При этом мы видим, что вот это число катастрофически больше, чем это, — в 25 раз. И это число катастрофически больше, чем это, — в тысячу раз. То есть всё, что в принципе можно посчитать на видеокарте, будет считаться бесконечно быстрее. Но у нас есть узкое место, и поэтому все эти рассуждения здесь были не важны: они были важны лишь про то, что видеокарта, если она может это посчитать, посчитает моментально. Остаётся вопрос, нужна нам эта штука или нет.
Чтобы посчитать два массива на процессоре, нам нужно считать все данные налево, а потом записать результат направо. Чтобы посчитать на видеокарте, нужно прогрузить данные вниз, а потом вверх. Пропорция этого числа и этого числа — 5 к 1 в этом конкретном случае. Значит, нам нужно, чтобы вычисления у процессора занимали хотя бы в пять раз дольше, чем трансфер этих данных. Обычно у вас коэффициент не около пяти: у вас либо 1000 к 1, либо 1 к 1.
Вот 1 к 1 — это просуммировать два массива. А если вы в каждом пикселе считаете какой-нибудь фрактал Мандельброта, который прямо в регистрах процессора численно что-то крутит, то это, очевидно, чисто вычислительная задача, в которой данные ничего не стоят, — а значит, видеокарта справилась бы гораздо лучше. Потому что прогрузить в карточку картинку, отобразить её или сохранить на диск не стоит ничего.
Да, вопрос?
— (реплика из аудитории неразборчива; судя по ответу — почему трансфер вообще нужен и нельзя ли считать прямо по данным на стороне хоста)
Потому что эта пропускная способность — просто в железе часть того, как функционирует видеопамять. PCI-шина сама по себе не может пропустить больше, чем 8 гигабайт в секунду, грубо говоря. Зависит от поколения, от того, сколько у вас линий, и прочего — это условный пример. Просто в смысле синтаксиса вы можете виртуализировать оперативную память и прямо из CUDA-кернела адресовать буфер больше, чем видеопамять. Я этого никогда в жизни не делал, потому что хочу, чтобы данные были в видеопамяти и дальше с бешеной скоростью полетели к звёздам. А если так, то я полагаюсь на то, что драйвер и компилятор как-то лучше меня распределят. Если уж вы занимаетесь перформансом, то в большинстве случаев вы предпочитаете полный контроль. А тут много отклонений, естественно.
— (реплика из аудитории неразборчива; по ответу — о том, можно ли явно загружать данные прямо в кэш)
У видеокарты это особенно явно будет заметно. Мы узнаем про локальную память — это почти что регистры; мы будем явно в них прогружать и от этого сильно выигрывать в перформансе. У процессора я, например, никогда в жизни этого не делал. То есть какая-то операция prefetch в ассемблере стопроцентно есть, но я не знаю, кто сейчас такое делает; думаю, в очень нишевых случаях. В общем, очень-очень редко. А в видеокарте — постоянно.
— (реплика из аудитории неразборчива; по ответу — о компиляции и передаче шейдеров и кернелов в играх)
Есть ещё более серьёзная проблема. Возможно, вы запускали игру, и на консоли всё гладко, а на компьютере тормозит. Я слышал об этом, у меня консоли никогда не было, я играю на компьютере. И разница, например, в том, что компьютер — это так называемый Android, а консоль — так называемый iPhone. Потому что, когда у вас железо предопределено, вы можете предварительно скомпилировать шейдер под архитектуру той видеокарты, которая там будет. А если у вас такая вундервафля, собранная еле-еле, — у меня, например, две видеокарты и компьютер лежит на полу рядом, — то вам нужно компилировать кернелы на лету, и вы можете сделать это, прекомпилировав их при запуске программы.
Я просто иллюстрирую, что есть ещё и всякие такие проблемы. Представим, что мы кернел с самого начала скомпилировали, или скомпилировали под те видеокарты, которые есть, или у вас свой сервер и там ровно одна видеокарта, — тогда эта проблема уходит. Остаётся то, что вы говорите про трансфер. Трансфер я мог бы сделать один раз заранее: всё-таки кернелов ограниченное количество, даже если их тысяча, они не такие большие. Поэтому это меня не пугает. Меня пугает инициализация трансфера данных, потому что каждая такая прогрузка по PCI-шине — это ещё и отданная команда, которая дальше исполнится с какой-то задержкой. Это очень большая проблема, если вы отправляете маленькие, не знаю, килобайтные буферы и их очень много: это очень плохая идея. Чаще всего лучше сделать один большой буфер, а уже его внутри нарезать.
Дальше, очевидно, есть забытые старые штуки — жёсткие диски, которые сейчас тоже бешеные деньги стоят. И есть ещё всякие спецэффекты, потому что нас может интересовать кэш и память, а дальше интересует диск: если у вас огромные объёмы данных, десятки тысяч фотографий или какие-нибудь огромные данные нейросетей. С нейросетями это, наверное, естественно, но часто в задачах нетривиально сделать её out-of-core и разбить задачу на куски так, чтобы при этом на стыках не было разницы в результатах по сравнению со случаем, когда вы обрабатываете всё монолитом. Это класс алгоритмов — алгоритмы во внешней памяти, out-of-core, в противовес in-core. На слайде это сказано прямо: «Это важный факт если вспомнить что в некоторых задачах объем данных не влезает в RAM! См. алгоритмы во внешней памяти (out-of-core)».
Есть ещё какой-нибудь Ethernet. Ethernet в смысле задержки нередко не такой плохой, например, по сравнению с жёсткими дисками. Мне кажется, это тоже интересный факт. И есть, очевидно, то, что от нас скрывают власти, — это магнитные ленты.
Вся эта линейка живёт на одном слайде-таблице, которая по ходу рассказа дорастает столбец за столбцом от кэшей до магнитной ленты. Её полный вид:
| Тип | Пропускная способность (bandwidth) | Задержка доступа (latency) |
|---|---|---|
| L1 cache | 60–120 ГБ/с на ядро | около 0,5–1 нс |
| L2 cache | 30–80 ГБ/с на ядро | около 2–5 нс |
| L3 cache | 10–40 ГБ/с на ядро | около 10–20 нс |
| DDR5 (2-channels) | 80 ГБ/с | около 60–120 нс |
| SSD NVMe PCIe 4.0 x4 (seq) | 7 ГБ/с | около 70–150 мкс |
| HDD 7200 rpm (seq) | 250 МБ/с | около 8–12 мс |
| Ethernet 1 GbE | 120 МБ/с | около 0,2–2 мс |
| Магнитная лента | 300–400 МБ/с | около 10–120 секунд до первого байта |
Под таблицей на каждом её слайде стоит сноска, без которой таблицу легко принять за справочник реальных характеристик железа: «числа условные, все совпадения с реальностью — случайны». Отдельно стоит заметить то, что вслух не произносится: лента по пропускной способности быстрее жёсткого диска (300–400 МБ/с против 250 МБ/с) — медленная у неё только задержка до первого байта, и в этом вся суть столбца. В заголовке столбца SSD слово PCIe обведено красным — той же рамкой, что и PCI-E 4.0 x16 на схеме, чтобы связать их между собой. И ещё: пропускную способность в этой таблице для DDR5 указано 80 ГБ/с, тогда как на схеме канал CPU — RAM подписан 40 ГБ/с; все пропорции выше (в 25 раз, 5 к 1) посчитаны по схемным 40 ГБ/с. Длинная стрелка под строкой задержек подписана на участке от L1 до SSD (это точно: 150 мкс против 1 нс) и на участке до HDD; на последних версиях слайда остриё стрелки уезжает дальше, на Ethernet и на ленту, а подпись остаётся прежней, так что относить её следует именно к жёсткому диску.
Преимущество лент, очевидно, в том числе то, о котором вы упомянули, — хранение. Поэтому, если вы думаете, что их не используют, то где-то в Антарктиде какие-нибудь гитхабы архивируют ваши репозитории именно на магнитных лентах. (Речь об Arctic Code Vault, и он не в Антарктиде, а на Шпицбергене, в Арктике.) В теории, наверное, и жёсткие диски бывают более долгосрочные и прочее, но, если погуглить поверхностно, у меня осталось впечатление, что именно магнитные ленты используются для этого. Слайд ставит здесь цифру, которая вслух не называется: «Огромный объем! Долгое хранение! (20 лет)» — и тут же «По промокоду GPGPUCOURSE — лилипут в подарок!», с картинкой лилипута, катящего бобину по коридору дата-центра.
SSD-шники, флешки — это то, что вы можете положить на полку, а через 10 лет очень грустно разочароваться. Как минимум используйте их хотя бы периодически, но вообще лучше не надейтесь, что они навсегда сохранят ваши данные. И в целом очевидная рекомендация: используйте бэкапы — дальше никто их не использует и всё такое.
Хорошо. Интересный мысленный эксперимент. Можем ли мы за бесконечный бюджет, но при технологически ограниченном будущем сделать жёсткий диск бесконечно долгим для хранения? Не-не-не, это сложные пути. Я бы попросил лилипута брать следующий жёсткий диск и перезаписывать на него каждый час, и так далее. Я просто хотел сказать, что это типа решаемая проблема. Это повышает планку: если в каком-то из случаев мы не сможем решить проблему, это будет очень грустно.
Если мы хотим ускорить его по пропускной способности, это тоже решается. Наверняка слышали про рейды — не компьютерная игра, — когда вы можете грузить, например, каждый второй байт с одного диска, каждый первый байт с первого. Или ещё больше, ещё больше. Это же может дать вам отказоустойчивость, если какой-то из дисков выйдет из строя, — если у вас есть избыточность кодирования. На слайде три красных вопроса выписаны подряд, и лектор их пересказывает, не цитируя: «Можем ли сделать HDD бесконечно долгим для хранения?», «Можем ли сделать HDD гораздо быстрее? (bandwidth) RAID!», «Можем ли сделать HDD гораздо быстрее? (latency)».
Но то, что мы не можем решить, — это задержка. Потому что жёсткий диск, узнав, что нужно считать, начинает раскручивать барабан, читающая головка должна куда-то переместиться. Всё, что в физическом мире, происходит медленно.
Давайте посмотрим на этот код. Что вы думаете про этот код — по перформансу?
sum = 0;
for (int x = 0; x < width; ++x) {
    for (int y = 0; y < height; ++y) {
        sum += image[y * width + x];
    }
}
Мы просто в картинке проходим по всем рядам — это y — и по всем столбикам — это x — и считаем сумму яркости картинки.
— Нужно OpenMP.
Согласен, хороший рефлекс.
— С кэшами будет проблема.
Действительно. Понятно, что если картинка маленькая, то всё что угодно будет хорошо, потому что маленькая картинка влезет целиком в кэш и всё такое. Но у нас картинка 100 мегапикселей, какая-то большая.
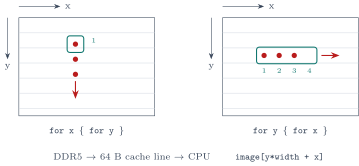
Посмотрим на этот альтернативный код. Кстати, олимпиадное программирование часто об этом тоже говорит; по-моему, у нас это было на олимпиадном программировании ещё в школе. Разница здесь только в том, что мы сначала обходим столбики и строчки или строчки и столбики: два варианта отличаются ровно порядком вложенности двух for, тело цикла в обоих одно и то же — sum += image[y * width + x]. В свою очередь, от этого будет разница в том, какой элемент будет считан следующим. Какой элемент будет считан следующим в этом варианте?
— Нижний.
Действительно: потому что чаще всего меняется вложенный for, то есть y, то есть номер строчки, а значит, мы спустимся пониже. Справа же внутренний for двигается по x, значит, следующий элемент будет справа.
Что бы мы выбрали? Про кэш уже сказали, и действительно: кэш адресует память без вот таких красивых картинок. Он не знает, что это картинка, у него память линейно адресована. Поэтому, если наша картинка хранится построчно — а это чаще всего и встречается, — то в правом случае, проинициализировав, подгрузив вот этот элемент, он скажет: «закэшируй, пожалуйста, всё, что рядом с этим», а значит, все следующие элементы грузятся уже из кэша. Это хорошо и приятно.
— Это надо смотреть тогда на размеры: то есть, если шире, то лучше по строчкам.
Нет, потому что в этот момент у вас когнитивная ошибка: вы видите картинку, а компьютер картинку не видит. У него каждый адрес подряд, и механика кэша выстроена так, что, подгружая любой байтик, грузит в кэш 128 соседних байт или 64 байта — в зависимости от размера кэшлайна. (На слайде нарисован конкретный случай: DDR5 -> 64 byte cache line -> CPU.) И всё. На самом деле вашу мысль можно переформулировать так, что нам может быть важно, в зависимости от того, как ориентирована картинка, выложить её в память по строчкам или по столбикам. Вот на этом, наверное, можно выиграть. Но это какой-то микротюнинг: обычно вы просто до такого уровня оптимизации кода не доходите и предпочтёте код попроще, чтобы у вас не было такого ветвления — это сумасшествие. И так всё постоянно; я багал очень много, путая y и x.
Поэтому нужно учитывать ещё, как выложена картинка в памяти, — на слайде это и спрашивается красным: «А как выложена картинка в памяти?». Вопрос с подвохом, здесь можно было докопаться на эту тему, но нужно просто понимать, что происходит. Кэширование идёт вот по таким строчечкам: справа зелёная рамка кэшлайна накрывает четыре подряд идущих элемента, помеченных 1 2 3 4, и все четыре нам нужны. А тут кэширование выглядит так, что эффективность его нулевая: та же зелёная рамка накрывает один-единственный полезный элемент. Мы подгрузили кэшлайн и дальше ничего из него не попросили, потому что — если картинка маленькая [так в записи; по смыслу рассуждения должно быть «большая»: про маленькую картинку лектор сам сказал выше, что она целиком влезет в кэш и всё будет хорошо], — то, когда мы дойдём до этого же элемента на следующем столбике, у нас кэш уже был полностью переписан всем тем массивом данных, что влезает в один столбик картинки.
Итак, давайте теперь обсудим базовые вещи, на которых уже можно подсветить и увидеть разницу между процессором и видеокартой. Смотрим на процессор: в нём что-то есть, у него не только ядра — у каждого ядра есть несколько потоков, например. Это то, как вам пытается Intel продать их ядра: что в каждом ядре по два потока, гипертрединг. Наверное, можно считать, сколько потоков, сколько ядер, — это не важно. Это всё обман, очевидно, и топ-вэлью — это купить i5, в котором нет гипертрединга вовсе, зато там чистые настоящие ядра. Неважно, за счёт чего это происходит, — хороший вопрос. Слайд, который здесь на экране, называется «Архитектура CPU: многопоточность» и отвечает на него одной строчкой: «Многопоточность благодаря переключению контекста!» (а рядом нарисован реактивный автомобиль, проносящийся мимо дорожного знака «6 GHz», у которого стоит единорог, — шутка про то, что шесть гигагерц бывают только в сказке; вслух она не комментируется).
Давайте вернёмся в прошлое. Пусть у нас есть какой-нибудь замечательный Pentium 4. Там всего одно ядро, но какое! Оно обеспечивает функционирование всей персональной системы. А я хочу открыть два приложения, например Telegram и какой-нибудь браузер: хочу, чтобы здесь у меня были мемасы, а здесь я читал полезную информацию по подготовке к лекции. Как это работает? Очевидно, параллельно. Хотя ядро, казалось бы, одно — как-то это достигается.
— Виртуальными потоками.
Есть гипертрединг, нет его — это неважно: даже без него на каждом ядре может исполняться большое количество потоков. Но для простоты примера будем считать, что их ровно два. Это виртуальные потоки, между ними происходит переключение, и вот это нас интересует.
Есть некоторое переключение контекста. До этого мы обсудили, что у процессора есть сейчас выполняемая инструкция, есть instruction pointer, который указывает на выполняемую сейчас инструкцию, и есть регистры, в которых лежит этот самый instruction pointer и какие-то числа, над которыми происходят операции. Слайд перечисляет это списком: «Context switch: обновляет Instruction pointer (указатель на строку кода); подгружает значения регистров процессора (откуда?)» — причём вопрос «откуда?» напечатан красным и будет обсуждаться отдельно.
Из этого вытекает, что переключение контекста включает в себя что, например? Когда один поток решил запаузиться, а другой берётся в работу, что происходит? Нам нужно как-то не потерять, не забыть контекст, который определяет то, что сейчас делалось в первом потоке. Например, это instruction pointer, который говорит, какая следующая строка программы — в ассемблере это не строки, а команды, но можно говорить на языке строк программы, — а также все данные, которые сейчас были в регистрах. Всё это нужно взять и бережно отложить в сторонку. А про второй поток, который сейчас взялся за работу, всё симметрично: мы должны из какого-то специального хранилища достать его контекст вычислений. Поэтому в английской терминологии это и называется context switch, буквально переключение контекста.
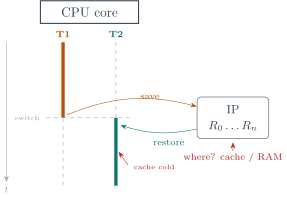
И это очень дорогая операция, потому что регистров всё-таки немало. И кэш, скорее всего, тоже сейчас прогрет как раз для интересов первого потока, а не второго, а значит, нам всё заново нужно подгружать в кэш из памяти. И это большая беда. На чём мы здесь можем сэкономить, как бы нам это ускорить, как вам кажется?
Во-первых, давайте подумаем, какое у нас вообще есть хранилище для регистров. Куда мы можем их отложить в сторонку — кэш или оперативная память? Я, кстати, честно говоря, не знаю, как на практике происходит; наверное, я всегда хочу надеяться на кэш. Но в теории, если у вас очень много потоков, наверняка и в оперативную память отгружается. Наверное, это один из примеров случаев, когда, запустив избыточно много потоков, вы получите, естественно, не ускорение, а деградацию по скорости.
— Ещё вроде бы часто в оперативную память добавляют такой хвост, который является кэшем, если он не помещается в обычный кэш. И там как-то чуть-чуть интереснее происходит аналитика, но в целом…
Это может просто свап на жёсткий диск. Или [неразборчиво].
— Нет, вроде бы именно в оперативку ставится.
Просто оперативка, мне кажется, в смысле физического железа однородна: я не могу представить, не слышал совсем, чтобы у неё было что-то такое. У дисков, понятно, есть разные слои кэша: есть SSD в жёстком диске, а у SSD есть DRAM, небольшой кусочек. А, возможно, да. Хорошо. Если вы про оперативную память что-то такое знаете — расскажите, мне будет очень интересно.
В любом случае регистры отложились в память или в кэш; в любом случае это [неразборчиво] нас место. (По смыслу: откладывание регистров так или иначе стоит нам места для хранения.) Воображаемые ментальные модели: вот у меня есть рабочий стол, там регистр, я играю в игрушки, играю в лего, откладываю его на какую-то полку, полку закрыл — теперь я играю не в лего, а рисую какую-то картину. И так далее, вот так переключаюсь. Каждое переключение занимает время — особенно оттереть краски, которые налипли на стол.
Теперь давайте посмотрим на следующую детализацию того, что здесь происходит. Мы не просто что-то считаем, а ещё и подгружаем данные из памяти. Значит, у этих потоков можно представить, что потенциально одновременно выполняются какие-то операции, и есть два типа операций: зелёненькое — вычисление, фиолетовенькое — подгрузить данные из памяти. Легенда слайда расшифровывает зелёный кирпичик: ALU - Arithmetic Logical Unit; сам слайд называется «Архитектура CPU: Hyper-Threading, SMT», и рядом нарисована планка RAM - DDR5, в которую ходит фиолетовый блок. Первый поток выложен как ALU ALU ALU ALU, второй — как ALU RAM RAM ALU. Какой поток отработает быстрее, если у одного потока четыре операции, а у другого две операции и две подгрузки данных?
Первый — потому что у него всё это в регистрах вычисляется, доступа к памяти нет, а мы уже обсудили, что это страх, медленно, большая latency. Слайд отвечает ровно этим: «Thread 1 отработает быстрее! Latency [RAM] много больше чем у [ALU]» — с ленивцем, пририсованным к блоку RAM, и смазанным от скорости волком возле ALU. Поэтому память — это то, что нас пугает, а значит, и то, что мы хотим оптимизировать; это потенциал ускорения.
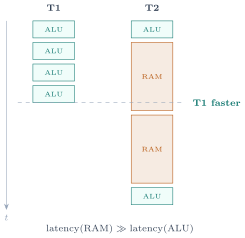
Давайте подумаем: если у нас два потока вот таким образом живут и переключение между ними, контекст-свитч, происходит вот здесь, например, и вот здесь, и так далее, — пока что будем считать, что оно бесплатное. Какое суммарное время работы таких двух потоков, например, относительно варианта, когда сначала отработал первый поток и лишь потом вступил в дело второй? Есть ли хоть какая-то разница? Если контекст бесплатный, то никакой разницы не будет: мы буквально просто перетасовали, в каком порядке выполняются операции. Вся арифметика этого места есть на слайде и ни разу не произносится вслух: «Какое суммарное время работы двух таких потоков?» — ; «Можно ли делать [ALU] пока ждем [RAM]?» — .
Но жизнь не так идеальна, и у нас здесь происходит контекст-свитч, поэтому так мы делать не можем. А на самом деле очень хотелось бы, ведь эта картина — полшага в сторону чего? Как мы можем оптимизировать такой подход?
— Регистровый файл.
Что с ним?
— Сделать дубликат.
Не-не-не, это всё правильные ответы, но про потом. Сейчас нас интересуют низковисящие фрукты. Низковисящий фрукт здесь в том, что я бы мог, казалось бы, этот ALU сместить чуть-чуть вверх: казалось бы, он мог бы действовать в то время, когда во втором потоке грузятся данные из оперативной памяти. Супер скучно и уныло. Мог бы я делать ALU с самого начала времён, прямо отсюда? Зависит от железа и прочего, но здесь, в нашей простой ментальной модели, на данный момент нельзя — потому что вот ALU, вот он, один кирпичик. Не два, а один. Поэтому нельзя. А вот память — это другой принципиальный железный кусочек, значит, его делать одновременно с ALU можно. Поэтому мы пытаемся всё это ускорить: хотелось бы таким образом, но так нельзя, потому что ALU пересекается, — на слайде это перечёркнуто красным крестом ровно на том блоке, который пришлось бы выполнять одновременно со вторым ALU. Значит, вот хотя бы таким образом.
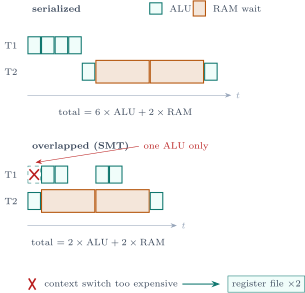
Здесь проблема в том, что мы могли бы так делать, прыгая между потоками туда-сюда, по чуть-чуть подсасывая новые операции по мере того, как latency была выплачена и данные из оперативной памяти пришли через кэш к нам в регистры. Но контекст-свитч — это второй демон, который нас здесь отпугивает. И поэтому давайте придумаем регистровый файл.
От Hyper-Threading к SIMD и первым GPU
Отсюда и возникает идея регистрового файла. Если мы поймём, что именно тормозит в контекст-свитче, мы сможем это оптимизировать. Если большее время там занимает подгрузка регистров из памяти и откладывание наших регистров сейчас — то есть сохранение контекста и подгрузка контекста, а в словосочетании «контекст-свитч» как минимум подразумевается, что это большая доля работы, — то нам бы хотелось иметь, например, два рабочих стола. Здесь я играю в лего, а здесь я рисую картины. Тогда переключение контекста — это встать, сесть там, продолжить работу; встать, сесть здесь, продолжить работу. В общем, я бы хотел быстро переключаться между ними, то есть снять проблему с откладыванием регистров.
На слайде это проговорено ровно теми же словами, хотя вслух он их не читает. Поверх временной диаграммы двух потоков стоит перечёркнутая красным надпись «Context switch — дорого! Долго подгружает регистры!». Сам вопрос диаграммы сформулирован там же: «Какое суммарное время работы двух таких потоков?» — ответ , и следом «Можно ли делать ALU, пока ждём RAM?» — ответ . На следующем слайде внутри блока core появляется блок register file, к нему ведёт красная стрелка от подписи «Давайте держать два множества регистров!», а снаружи ядра нарисована планка RAM - DDR5. Там же, в углу, картинка-шутка: гоночная машина, дорожный знак «6 GHz» и единорог рядом с ним — процессора на 6 ГГц не бывает.
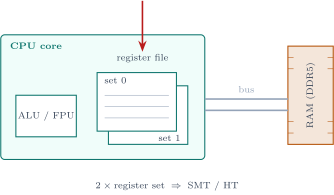
Значит, я хочу, чтобы у меня было просто в два раза больше регистров. Понятно, что в идеале дальше, может быть, захочется в 10 раз больше регистров — тогда 10 потоков одновременно с большими шансами заткнут все дыры. Потому что если у меня какие-то потоки делают много-много вычислений, фиолетовый блок скучает; а если у меня запущено 10 программ, ну кто-нибудь да нагрузит его. Соответственно, чем больше альтернатив, тем чаще я смогу найти того, кто сейчас нагрузит каждую из этих железок.
Но здесь, скорее всего, сыграли какие-нибудь константы вроде того, что на регистровый файл вы тратите бюджет ваших транзисторов. И это, по сути, выбор. Я могу так сделать и получить какой-то бенефит, какую-то пользу, какое-то ускорение: отсюда ускорение условное 20%, а следующий шаг даёт нам уже всего лишь 2%. Это исчезающая польза, diminishing returns, вместо которой я мог бы, например, потратить этот транзисторный бюджет на какой-нибудь больший кэш — больший кэш тоже ускоряет, через другие механики, но ускоряет. Видимо, какой-то баланс найден, и в данном случае почти всегда в процессорах двухпоточный параллелизм, в смысле гипертрединга или simultaneous multithreading. Но есть какие-нибудь эзотерические архитектуры типа IBM PowerPC или что-то из прошлого — там было, по-моему, 4 потока или что-то такое; на Википедии я это прочитал, можете прочитать и вы. (Четырёхпоточный SMT — это серверная линейка IBM POWER; PowerPC — другое семейство.)
— Извините, а что такое регистровый файлик?
— Регистровый файлик. Вот у вас были регистры, а теперь у вас их тупо два. Есть регистр A — теперь у меня два регистра A. И два регистра B. И так далее.
— Это нужно для переключения контекста?
— Да. Ментальная модель — вот рабочий стол. Если у меня есть рабочий стол и он один, то каждый раз, когда я начинаю заниматься другим делом, я должен убрать старый инструмент, отложить в сторонку и не потерять записи, взять записи вот этой другой задачи, делать её, и так далее. Если два стола — я здесь разложил игрушки и здесь разложил игрушки. Эти игрушки-инструменты — это и есть данные в регистрах.
— Что вы сказали про нагрузку на транзисторе?
— Мы могли бы сделать 4 рабочих стола. Вопрос в том, сколько места в квартире. Квадратный метр нынче дорог, поэтому вы выбираете, на что тратить это место. Если вы хотите где-то поставить супершикарное кресло, в которое можно чилить, ещё, может быть, ковёр, на который нужно смотреть, — это всё очень важно. Поэтому вопрос в том, какую вы можете получить пользу, и вы обычно предпочитаете максимальную. Нас здесь интересует, например, скорость — скорее всего, выгоднее потратиться на кэш.
— А регистровый файл где вообще хранится? В самом процессоре?
— Можете воспринимать процессор как материальную точку, в которой есть всё: и вычисления для всяких операций, и штука, к которой подсоединена оперативная память по такой трубе. Ну и кэш, и прочее, да.
— То есть он [неразборчиво]?
— Да. На самом деле можно дальше детализировать, призумить картинку и увидеть, что регистры прям совсем близко, а кэш там чуть-чуть подальше, потому что это хорошо отражает вот эту latency. Регистр моментальный, он прямо в руке, а кэш — это скорее ящик в столе или соседняя полка в шкафу.
— Как гипертрединг выглядит для операционки?
— Я здесь не очень шарю, я немножко могу погаллюцинировать, как сейчас принято. Явным образом операционная система знает логические процессоры и физические процессоры, поэтому обычно делят на термины cores — ядра и threads — потоки. Их может быть один к одному или два к одному; бывает больше, но обычно так. В каком-нибудь условном i5 бывает один к одному. Есть ещё всякие энергоэффективные ядра, в которых нет гипертрединга, — как раз потому что попытка выжать максимум из теплового пакета, из бюджета, который на них выделен, показывает, что гипертрединг здесь не выгоден, например. А где-то выгоден, да, это я просто примеры иллюстрирую. Поэтому может быть так, что у вас часть ядер с потоками соотносится два к одному, и на этом же процессоре есть ещё вот такие [неразборчиво; по контексту — маленькие ядра], у которых один к одному.
Ну и ещё: SMT — это либо AMD-шный термин, либо просто общий термин для всех тех, кто не является Intel, потому что Hyper-Threading, естественно, запатентован. Как и ультрабуки. Вы знали, что ультрабуки — только с Intel? Слайд подводит итог одной строкой: «Это и есть SMT и HT!».
Итого, надо ещё как-то это всё ускорять. Давайте придумаем, что можем сделать, давайте придумаем страшные слова, которые уже кто-то упоминал. Очень часто мы хотим работать, например, с большим массивом: просуммировать там много элементов, делать какие-то единообразные, одинаковые операции. Например, взять 8 char, или 4 short, или 2 int и просуммировать их с двумя int. И сделать это, например, в идеале за один такт. Мы могли бы это сделать за два такта, понятное дело, просуммировав A с B, а потом C с D. Но если это так часто происходит, давайте договоримся, что процессор, если сделать всё правильно, к этому готов, и мы можем за один щелчок пальцев сделать такую массовую операцию.
— Ну и расшифровывается это как simultaneous instruction multiple data…
— Single instruction.
— Спасибо, да. Single Instruction Multiple Data. То есть одна инструкция, множественные данные, ко всем она применяется одинаково и однородно.
Заголовок слайда при этом — «Архитектура CPU: SIMD intrinsics (т.е. встроенные)», а пример с 8 char / 4 short / 2 int лектор пересказывает прямо с первой строки таблицы, 1997 - MMX - 64 бита: 8 x char, 4 x short, 2 x int. Следом он замечает: «А, тут картинки есть». Картинки — это три слайда подряд, каждый меньше двух секунд на экране: сначала колонка «Было:» с одной 32-битной тройкой int a = int b + int c, потом к ней добавляется 16-битная тройка short a = short b + short c, потом колонка «Стало:» — одна 64-битная строка short a0 | short a1 | short a2 | short a3, равная сумме таких же строк из b и c, а в шапке таблицы обведено 4 x short. Под этим стоит вопрос, который вслух не произносится вовсе: «Какое следовало бы ожидать ускорение?»
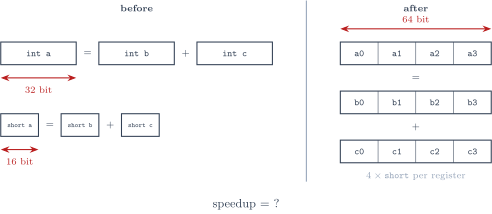
В общем, оно очень удобное, очень быстрое. Не всегда линейное ускорение, естественно, потому что, например, оно может быть всё-таки с несколько большей latency. Понятное дело, что оно всё равно эффективнее, чем суммировать массив по одному элементу, иначе бы это не имело никакого смысла. Но оно бывает хуже по тому, сколько тактов требует. Более того, некоторые из них — вот дальше мы их обсудим, AVX — приводят к тому, что процессор начинает греться, прям жёстко греться, и начинает работать супермедленно, потому что ему из-за троттлинга нужно снижать частоты. И это приводит к тому, что программа начинает тормозить, потому что частоты снижаются и для всех других операций и не успевают набраться обратно, когда она переходит с AVX. Поэтому прекрасная идея, как замедлить на каком-нибудь Intel — может быть, и на AMD тоже — какое-нибудь вычисление: воткнуть редкие-редкие AVX-инструкции. Он в этот момент начнёт троттлить, греться, а вы такой: «да я пошутил», — он начинает считать. Он опять троттлит — ну, очень грустно будет.
Таблица расширений разворачивается на слайдах строка за строкой, но вслух из неё звучат только обрывки: ни одна из дат и ни один из счётчиков полос для AVX, AVX2 и SSE2 не произносится. Полный её текст:
1997 - MMX    - 64 бита: 8 x char, 4 x short, 2 x int
1999 - SSE    - 128 бит: 4 x float, 2 x double
2000 - SSE2   - 128 бит, теперь и над целыми: 16 x char, 8 x short, 4 x int, 4 x float, 2 x double
2004-2006 SSE3 / SSSE3 / SSE4 / SSE4.1 / SSE4.2 - расширения набора инструкций
          (горизонтальная работа в регистре, функции для видеокодирования и обработки строк)
2011 - AVX    - 256 бит: 8 x float, 4 x double
2013 - AVX2   - 256 бит, теперь и над целыми: 32 x char, 16 x short, 8 x int, 4 x long
2016 - AVX512 - 512 бит, впервые появился в Intel Xeon Phi
                (~60 pentium ядер, это pivot закрытого GPGPU-проекта Larrabee)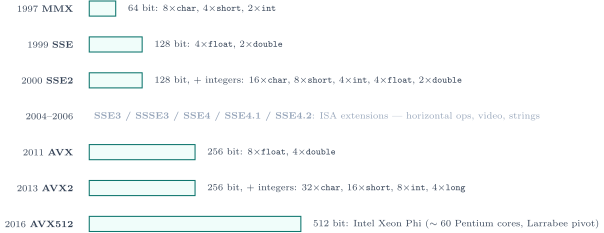
Есть ещё SSE — то же самое, в два раза больше. SSE2 — то же самое, но теперь ещё и над целыми числами: здесь не было, видите, здесь был int, здесь не было int, а здесь добавили. Дальше можно заметить некую тенденцию. Некоторые дополнительные операции бывают, конечно, типа горизонтальной работы в регистре, то есть, например, перетасовать. Это же очень интересно. Можно, например, сделать специальные функции для видеокодирования или для обработки строк.
Как решить, какие функции добавить? Очень просто. По факту вам нужно смотреть, что сейчас тормозит, что хотят пользователи, что частая операция, где люди готовы запариться и написать тот ад, который нужно написать, чтобы использовать эти инструкции. И если вы угадываете — но обычно, очевидно, на основании реальных данных, реальных перформанс-замеров каких-то. Или, может быть, у вас есть какие-то партнёрские отношения с очень крупной компанией, которая готова скупить все ваши процессоры вообще. Тогда буквально, что они у вас попросят? Они вам скинут свой бинарник, вы его профилируете и сделаете процессор, который за один такт исполняет всю программу, естественно.
Ну и вот AVX — это такая, наверное, самая широкая инструкция. Есть AVX2, есть AVX, как вы можете догадаться, 512 — это сразу после двойки (по списку на слайде между AVX2 2013 года и AVX-512 2016 года три года, так что «сразу» здесь риторическое), там ещё в два раза больше. Впервые он появился в Intel Xeon Phi — это очень похоже на видеокарту, в то время во всяком случае: порядка 60 ядер и прочее, по сути типа 60 пентиумов вот воткнули, и оно, значит, там что-то делает. Очень прикольная штука, она экономически провалилась в конечном итоге, проект был закрыт, но в большой степени по научным статьям, как минимум, которые они опубликовали и которые мы обсудим на одной из лекций, — про их проект Larrabee, в котором поверх этого Xeon Phi, то есть поверх примерно 60 pentium-ядер, попытались сделать видеокарту: видеокарта, OpenGL-драйвер, её можно использовать, там прям отдельная операционная система работала. Крутой масштаб.
Давайте теперь посмотрим, как это работает. Вот фрактал Мандельброта. Почему это хороший пример? Потому что в отличие от суммирования двух массивов… Ну вот видите, нужно заниматься анализом происходящего: если люди жалуются на AVX-512, что он троттлит, его просто выкидывают. Поэтому если вас что-то не устраивает в программе и вы про какую-то фичу хотите зарепортить баг — подумайте. Вдруг вы её единственный используете, и её просто выкинут. Это не иронично, очень хочется иногда так сделать, когда репортят какие-то баги.
И давайте обсудим фрактал Мандельброта. Почему он нас интересует? Потому что это не суммирование двух массивов, в котором мы упираемся — как мы уже обсудили — в подгрузку данных, просто-напросто в memory bandwidth. Это гораздо более интересная вещь, сейчас обсудим какая. Предполагается, что вы знаете какой-то зацикленный процесс; неважно, в нём очень много численных операций. Нас интересует некая точка , и мы для неё просто делаем большое количество итераций каких-то численных — не очень важно каких — и проверяем, этот численный ряд расходится куда-то или он сходится. Это всё, что нас интересует по факту.
Код на слайдах набирается в четыре шага, с маркерами «1»–«4» на полях:
float x = 0.0f;
float y = 0.0f;
for (iteration = 0; iteration < MAX_ITERATIONS; iteration++) {
    float xn = x * x - y * y + x0;
    y = 2 * x * y + y0;
    x = xn;
    if (x * x + y * y > INFINITY) {
        break;
    }
}
К последнему шагу слайд даёт подпись «быстрый выход если ряд разошелся» и картинку самого фрактала, а следующий слайд добавляет вопрос, который задаёт всю рамку дальнейшего разговора: «Во что мы упираемся? Compute bound или memory-bandwidth bound?»
В этот момент мы даже за пределы регистров не выходим, потому что вот она вся математика: здесь нам нужны и и какие-то промежуточные вычисления, после этого и обновляются на новые значения. Какие там операции — да какая разница; главное, что мы в рамках регистров супер комфортно себя чувствуем. Самая дорогая здесь операция — это сложить, умножить, сложить, умножить; очевидно, здесь нам помогают и FMA, fused multiply-add, операции. И вот почти все гигафлопсы — это, наверное, один из немногих случаев, когда мы можем таки выжать (в записи звучит «выжить», но по смыслу идиомы — «выжать»). Ну и дальше проверяем, выходит она за пределы нашего порога допуска, расходится ряд или нет. В зависимости от этого получаем картинку; чтобы она стала цветной, мы ещё интерполируем, насколько быстро она расходится. Можно загуглить, просто прикольно.
Теперь давайте решим, как же нам этот compute-bound барьер пробить и попытаться ускорить. Давайте заметим, что мы делаем операции в большом количестве пикселей максимально похоже, а значит, можем сказать, что у нас есть не просто и , а четыре подряд идущих и четыре подряд идущих . (На слайде это чуть строже: вектором является только текущее значение ys, а стартовое y0 раздаётся всем четырём полосам скаляром через _mm_set1_ps(y0), — то есть четыре полосы это четыре соседних пикселя одной строки, у которых общий.) А синтаксис вот очень приятный, и думается, что дальше будет только лучше.
Векторная версия того же цикла, с заголовком слайда «128 бит = 4 x float», целиком:
__m128i maskAll = _mm_setzero_si128();
__m128i iters   = _mm_setzero_si128();
__m128  xs = _mm_set1_ps(0.0f);
__m128  ys = _mm_set1_ps(0.0f);
for (iteration = 0; iteration < MAX_ITERATIONS; iteration++) {
    __m128 xsn = _mm_add_ps(_mm_sub_ps(_mm_mul_ps(xs, xs), _mm_mul_ps(ys, ys)), xs0);
    __m128 ysn = _mm_add_ps(_mm_mul_ps(_mm_mul_ps(_mm_set1_ps(2.0f), xs), ys), _mm_set1_ps(y0));
    xs = _mm_add_ps(_mm_andnot_ps((__m128) maskAll, xsn), _mm_and_ps((__m128) maskAll, xs));
    ys = _mm_add_ps(_mm_andnot_ps((__m128) maskAll, ysn), _mm_and_ps((__m128) maskAll, ys));

    maskAll = _mm_or_si128(_mm_castps_si128(_mm_cmpge_ps(_mm_add_ps(_mm_mul_ps(xs, xs), _mm_mul_ps(ys, ys…
    iters = _mm_add_epi16(iters, _mm_andnot_si128(maskAll, _mm_set1_epi16(1)));
    int mask = _mm_movemask_epi8(maskAll);
    if (mask == 0xffff) {
        break;
    }
}
iters = _mm_shuffle_epi8(iters, _mm_setr_epi8(12, 13, 8, 9, 4, 5, 0, 1, -1, -1, -1, -1, -1, -1, -1, -1));
Строка с _mm_cmpge_ps обрывается не при оцифровке, а на самом слайде: она не помещается в правое поле, и закрывающие аргументы _mm_cmpge_ps из видео восстановить нельзя.
Мы просто делаем все те же фиксированные заранее операции. На самом деле довольно просто: смотрите, это add, sub — это subtract, mul — multiply, умножить, ещё один умножить. И вот вы чуть-чуть посмотрели — если не зажмурились, то можно увидеть, здесь константа 2.0f. В принципе приятно. И вот это новое значение, тут то же самое. Ну всё, в принципе, более-менее ничего сложного нет.
Дальше есть какие-то maskAll и какие-то andnot. Что это такое? Это что-то про if-ы, потому что у нас вот в этом коде есть if-ы про расходимость. В целом мы могли бы всё равно продолжить их за компанию считать до тех пор, пока есть хотя бы один, кто ещё хочет продолжить играть в эту игру. Но тем не менее есть способы маскировать для кого-то отдельно. И вот здесь, например, compare greater equals — _mm_cmpge_ps, на слайде он обведён зелёным и помечен маркером «4». Это, собственно, способ сравнить, правда ли, что каждый отдельный элемент хочет уже закончить с этим адом. Чтобы показать, откуда берётся маска, он возвращается на слайд со скалярным if-ом и показывает на него. И вот здесь мы проверяем: если маска подняла флажок для каждого элемента, то мы прерываемся; если хоть один продолжает — мы продолжаем.
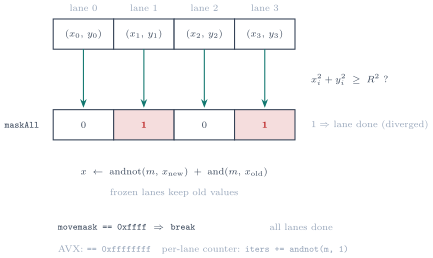
Так что на самом деле это не супер страшно. Вот я только с таких штук угораю, конечно, когда там вот такие вещи нужно подобрать: ну типа, я не буду этого делать больше никогда в жизни. Это как раз те самые горизонтальные операции в регистрах, потому что если нам нужно их как-то перетасовать, то нам нужно через аргументы этой функции — какими-то индексами, битами, масками, чёрт знает чем — сформулировать, что нужно сделать. Но, честно говоря, часто в эпоху LLM, наверное, совсем просто делать, а так в целом просто берёте, отлаживаете, маленький пример сделали и в нём дальше играете, тестируете. Рядом с этим кодом на слайде стоит «Крик» Мунка.
— Ты сейчас напомнил: вот эти операции — в чём их особенность?
— Их особенность в том, что они делают сразу операцию над несколькими элементами. В данном случае число 128 говорит, что здесь 128 бит. В обычном float 32 бита, значит, здесь каждый содержит 4 элемента. И мы сразу берём и 4 элемента с 4 элементами складываем. В обычном случае это заняло бы, например, 4 такта процессора, а здесь давайте будем считать, что полтора, например, или даже один, или два — ну какое-то число. Всё равно мы увеличиваем пропускную способность в пределе вот до четырёх раз, например.
— То есть там аргументы получается… Почему там три аргумента, допустим?
— Где? А это два. Вот здесь два, да.
— Это вообще плюсы, нет ещё?
— Это ещё плюсы.
Ну что, вот это всё — это просто какая-то, скорее всего, библиотека типа. Вот у Intel очень крутая, на самом деле, есть программка, сайт точнее, где вы можете находить эти инструкции. Они ещё подразбиты по категориям набора инструкций, которые у вас есть: SSE, AVX и прочее. Так что для этого что-то создано, чтобы люди не слишком мучились. Но в целом, честно говоря, я не знаю — ведь я вот это написал, может быть, ещё один или два раза в жизни я что-то такое писал, может быть, даже на работе, но типа вообще это никому не нужно. Ну, типа, это редкость.
Нам это интересно постольку, поскольку…
— А что изменилось?
— А, да, битность больше, нас стало ещё больше, да? И разница на самом деле очень маленькая. Вот отсюда сюда перейти не страшно, потому что у вас меняется битность, и операции там очень похожи. Они, конечно, отличаются, и не просто числом 256, 512, потому что иначе будет скучно. Но в целом портировать не так сложно.
Он в этом месте раз за разом перещёлкивает между 128-битным и 256-битным вариантами, каждый из которых держится на экране меньше двух секунд, и показывает на различия, не называя их вслух. Различий ровно три. Заголовок становится «256 бит = 8 x float», все типы и интринсики получают префикс __m256 / _mm256_. Сравнение пишется как _mm256_cmp_ps вместо _mm_cmpge_ps. Условие выхода становится if (mask == (int) 0xffffffff) вместо if (mask == 0xffff), а финальная перестановка — _mm256_shuffle_epi8(iters, _mm256_setr_epi8(0, 1, -1, -1, 4, 5, -1, -1, 8, 9, -1, -1, 12, 13, -1, …)). Между делом на 128-битном слайде появляется ещё одна зелёная рамка, с маркером «4.5», — вокруг самой проверки (mask == 0xffff).
— Это надо очень сильно под железо, получается.
— Нет, не очень сильно под железо, потому что вы можете… Как это делается? У нас просто есть немного такого кода на работе, и мы по сути делаем так. Вы пишете бейзлайн-функцию, которую просто естественно нужно написать — например, для того, чтобы знать, что вы, собственно, пишете. Потом вы делаете её копию, в которой пишете под случай, не знаю, когда есть SSE2. И ещё одну штуку под случай, когда есть AVX2. Дальше вам нужно сделать просто диспатчинг, который будет спрашивать, а что у тебя есть, и пускать в ту версию, которая поддержана.
Именно на этой реплике, на 75-й минуте, он выводит на экран разделитель новой главы — «Глава 2: история GPU. Fixed pipeline rendering, vertex + fragment shaders», — но вопросы про SIMD продолжаются под ним ещё две с лишним минуты.
— А есть версии компиляторов, которые сами [неразборчиво]?
— Ну, это постоянно говорят, что кто-то что-то опять сделал, и оно обычно очень неэффективно работает. Может быть, уже случилось.
— Вроде в 26-х плюсах же?
— Вроде в 26-х плюсах что-то есть, да, я даже слышал на конференции что-то весной. Дальше задаётся вопрос — буквально, там кто-то даже спросил, я хотел спросить, но меня опередили: есть ли там диспатчинг встроенный? Нет, нет. То есть если вы собрали бинарник под архитектуру, оно больше нигде не заработает, если там меньше набор инструкций. Это то, что вот мы, например, вручную пишем: if, else, if, else в зависимости от доступных инструкций.
— В смысле, перекомпилировать?
— Ну, перекомпилировать — вам нужно будет сделать бинарник и поставку под каждого пользователя. Или положить кучу бинарников, которые на ходу диспатчатся. То есть это просто не масштабируется. А если вы библиотеку поставляете пользователям? А если вы программа, которая использует три библиотеки, в каждой из которых этот диспатчинг? Ну ладно, вам достаточно тоже собрать три штуки всего лишь, но неважно. Короче, неприятно.
— Я не понял проблемы, если честно.
— Ну, есть разные платформы, на них разные железки. Собирать под каждую тяжело. Обычно предпочитают всё-таки сделать одну штуку, иначе это всё немного усложняет. Но это возможно, можно так сделать, да.
— (вопрос из зала: почему не сделать несколько версий бинарников?)
— Несколько версий бинарников. Не, ну у нас вот это ветвление, оно на практике не очень ощутимо. И то, насколько мы упрощаем себе жизнь в каждом релизе — а релиз-то вам придётся делать каждый раз, — это сильно упрощает. Но, опять же, это всё очень можно спокойно оспорить, потому что у вас могут быть разные вводные и разные вещи для вас важны. Поэтому полезно знать, почему что-то делается, иначе будет как в анекдоте с сосисочками в кастрюле.
Итого, видеокарты. Давайте суперкоротко это обсудим и, в общем-то, на сегодня закончим. В 1996 году графика была, собственно, на процессоре. (Слайд формулирует это иначе: «До 1996 года 3D графика на CPU (DOOM, Quake, Nukem 3D)»; поверх трёх скриншотов там нарисованы красные размерные стрелки 320 и 240 — то есть разрешение , которое вслух не называется.) И, наверное, основной фактор, почему это перестало справляться, — это большие мониторы. Большие мониторы содержат много пикселей, в каждом пикселе нужно что-то посчитать, процессор не справляется. Он упёрся в свой потолок — какие-нибудь, не знаю, гигагерц, 4 гигагерца. Кто-нибудь слышал, чтобы 10 гигагерц были? Нет, и я не слышал. И непонятно, что делать.
Да, вы можете напихать больше ядер, но вот тогда не могли, например. И при этом играть хотелось; это, наверное, в том числе коммерчески начинало быть очевидной такой веткой развития. В результате начали появляться 3D-ускорители, которые заточены на конкретный класс задач с ограниченным функционалом: они могут нарисовать треугольник, и есть три варианта, как его осветить, грубо говоря. Конкретные имена перечисляет только слайд: 1995-1997 - становятся популярны 3D-ускорители: S3 ViRGE, ATI 3D Rage (куплена AMD), 3dfx Voodoo (куплена NVIDIA). Ни производители, ни обе покупки вслух не упоминаются.
Это fixed pipeline rendering. Fixed в том смысле, что в нём предопределён набор рычажков, которые можно дёргать. Конкретная, грубо говоря, библиотека, которую вы можете использовать. А свою библиотеку вы написать не можете. На слайде это вынесено в красную рамку: «Fixed pipeline, нет возможности исполнять произвольный код».
Но в какой-то момент игроделы стали делать странное. Они захотели делать красную воду (так в расшифровке; по смыслу соседней фразы, вероятно, «красивую»), какие-нибудь волны реалистичные и прочее. И делать это в рамках fixed pipeline стало невозможно просто потому, что происходил, по сути, комбинаторный взрыв. У вас было такое обилие идей, и они появлялись на ходу, что вы просто не могли это зашить в такой долгий цикл: разработать железо, для него драйвер, пустить это в продакшн, оно дошло, оно пришло разработчикам, разработчики смогли оттестироваться, и только потом это всё приходит к пользователям в виде игры, которая работает на их железе. Сумасшествие. Плюс нет разнообразия, нет гибкости — это всё беда.
Поэтому, собственно, появились программируемые шейдеры. По сути, это способ сказать, что я хочу делать с каждой вершинкой и что я хочу делать в каждом пикселе, отрисованном на экран. В таком случае я могу там написать совершенно произвольную математику, которая считает освещение. Датировку даёт опять только слайд: 2000-2002 - в DirectX 8.0 и OpenGL появляются программируемые шейдеры (vertex + fragment shaders), причём слова «программируемые шейдеры» обведены зелёным — это тот же код цвета, которым дальше размечен весь конвейер.
И, в общем-то, выглядит это так, что у нас есть вершинки. Мы каждую вершинку, например, проецируем в экран, потому что вершина же живёт в трёхмерных координатах, а экран двумерный. Значит, мы умножаем на матрицу, описывающую камеру, и тем самым переводим 3D в 2D. Теперь, когда у каждой вершинки есть двумерные координаты, я могу натянуть треугольники на эти пиксели экрана.
Картинка конвейера на слайде собирается в два приёма и несёт весь аргумент своей раскраской. Сначала появляются uniform state и vertex array с семью пронумерованными точками, из которых стрелка ведёт в vertex shader — он обведён зелёным, то есть программируемый. Затем добавляется element array [(1,2,3), (3,2,4), (4,2,7), (7,2,5), …] — список треугольников по индексам вершин, выделенный красным, — и две стадии под шейдером, triangle assembly и rasterization, обе в красной рамке, то есть фиксированные. Ни эти кортежи индексов, ни названия стадий вслух не произносятся.
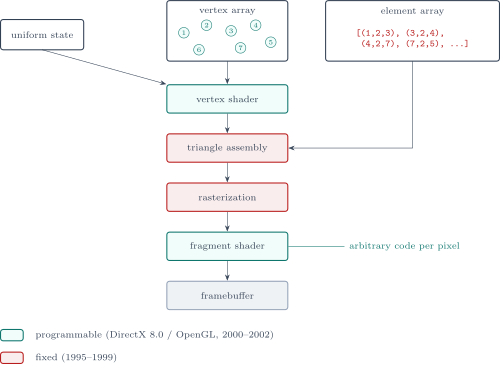
Здесь происходит всё ещё хардварный fixed-pipeline растеризатор, который для каждого треугольника, натянув его на вершины в экране, понимает, какие пиксели внутри этого уже плоского треугольника.
— Как вы думаете, что будет дальше?
— (реплика из аудитории неразборчива)
— Да, раскраска. То есть в каждом из этих пикселей мы, собственно, не просто хотим знать, что сюда попал такой-то треугольник, а посчитать, что там за цвет.
GPGPU и первое знакомство с OpenCL API
Здесь происходит всё ещё хардварный fixed-pipeline растеризатор, который для каждого треугольника, натянутого на вершины в экране, понимает, какие пиксели лежат внутри этого уже плоского треугольника. Как вы думаете, что будет дальше?
— (ответ из аудитории отсутствует в записи)
Да, раскраска. То есть в каждом из этих пикселей мы хотим не просто знать, что сюда попал такой-то треугольник, а посчитать, что там за цвет. Это как раз и делает фрагментный шейдер: в каждом пикселе он может рассчитать нужный цвет из текстуры, учесть, как далеко мы от источника освещения, посчитать, затенено оно или нет. На слайде это и подписано красным: «В каждом пикселе работает наш произвольный код!» И это даёт гибкость, позволяет экспериментировать. А если вы даёте гибкий инструмент, который может кто угодно запрограммировать дома, то разнообразие позволит прийти к крутым эффектам и крутым результатам.
В каком-то смысле есть гипотеза, что машинное обучение — ещё более старое, чем современное, лет пять назад, то есть доисторическая эра, — очень сильно выиграло от того, что видеокарты пробили какой-то психологический порог по вычислительным мощностям и при этом были достаточно дёшевы. Славное было время. За счёт этого люди, которые не особо понимали, что можно, а чего нельзя, какие научные исследования и способы приходили в тупик, совершенно не оглядываясь на это, делали всё что угодно. Понятно, что я имею в виду людей, которые всё-таки относительно в области или рядом с ней. Но тем не менее в масштабах мира идёт большой эксперимент, почти генетическое программирование, оно к чему-то приводит, и такие вещи очень сильно помогают.
Но давайте подумаем — уже в тот момент, когда программируемые шейдеры появились. У меня есть программируемые шейдеры, они работают так, как мы примерно обсудили: треугольники натянуть на экран, дальше внутри найти пиксели, в каждом пикселе что-то посчитать. А я сумасшедший учёный, я сижу в бункере, у меня есть вот эта видеокарта, может быть, даже сто. И я хочу посчитать симуляцию какой-нибудь теплопроводности или того, как будет распространяться эхо по стенам этого мраморного зала. Слайд ставит этот вопрос прямо: «Как посчитать какую-нибудь численную схему распространения тепла?»
Что мне делать? Процессор не справляется, я хочу быстрее. Я знаю, что когда я играю в Doom вечером, он работает быстро. Как мне это заэксплуатировать? Как мне заставить Doom рассчитывать теплопроводность?
— Написать свою программу как шейдер.
Да, написать свою программу как шейдер. Получается, нам нужно в эту механику как-то натянуть мою задачку. А моя задачка в случае теплопроводности на самом деле очень похожа на эту структуру: у меня уже есть регулярная решётка, где в каждой ячейке мне нужно сделать предопределённый набор численных операций, как в фрактале Мандельброта.
— Это получается, нам нужно… каким свойством должна обладать задача, чтобы её можно было посчитать?
О, это очень круто, вы прямо смотрите в глубинное зерно нашего курса. Что нас интересует? Нас интересует, чтобы задача могла быть, например, представлена в виде регулярной решётки, потому что тогда мы в каждом пикселе можем одновременно что-то посчитать. То есть должен быть — я это предпочитаю формулировать так — массовый параллелизм. SIMD-инструкции выигрывают [глагол восстановлен по смыслу: в записи на его месте неразборчивое слово], когда есть просто параллелизм; видеокарты выигрывают, когда есть массовый параллелизм, когда это десятки тысяч одновременно считаемых штук. Потому что в видеокарте этих потоков десятки тысяч.
— Какая сложность самих маленьких задач в каждой ячейке? Есть какие-то отличия?
Есть, в том смысле, что если там совсем что-то сложное делается и, например, доступ к памяти супер случайный… Например, таким образом какие-нибудь криптовалютчики в своих протоколах и алгоритмах добычи блоков закладывали детали, из-за которых вам нужна была не видеопамять, а обычная память — чтобы геймеров пощадить, чтобы перестали скупать все видеокарты. Обычно это всё равно не справлялось и не срабатывало, но тем не менее: если у вас паттерн доступа к памяти супер-пупер хаотичный, то, возможно, вы как минимум не достигнете той тысячи гигабайт в секунду, что была написана раньше (это полка GPU на графике пропускной способности памяти). Но почему это происходит, мы обсудим на следующей лекции.
В любом случае, я хочу рассчитывать свою теплопроводность. Я пишу бинарник doom.exe, чтобы драйвер ничего не заподозрил. Говорю, что у меня есть четыре вершины — A, B, C, D — и два треугольника. Он меня спрашивает: а куда проецировать в экран? Я говорю: A — это верхний левый угол экрана, B — верхний правый, и так далее; вот эти два треугольника всегда видны в камере вот так вот. Он говорит: ну да-да, я поверил. На слайде это и нарисовано: пунктирный квад с вершинами A (слева вверху), B (справа вверху), D (слева внизу), C (справа внизу) и диагональю A–C, которая и режет его на два треугольника.
И всё. Мы просто идём в растеризацию, получаем каждый пиксель экрана — это всё, что мы хотели от ABCD, их жизнь проста. А теперь в каждом пикселе мы можем посчитать тени, свет, что угодно. А чем это отличается от какой-то формулы теплопроводности? Да ничем: мы берём старый цвет, рассчитываем новый, кладём. А цвет — это число, а число — это, например, температура. На слайде рядом с квадом подписана стрелка rasterization от сетки пикселей к этому квадрату.
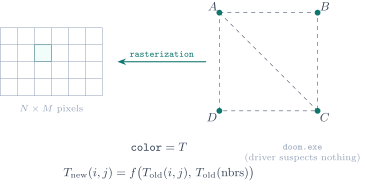
Всё это очевидно подтолкнуло к тому, чтобы позволить делать такие расчёты, не сводя всё к треугольникам и фрагментным шейдерам, а специально использовать языки, в которых что-нибудь поудобнее подготовлено для всего этого. Например, потому что — я сейчас могу ошибаться в фактах, но если я правильно помню — там чуть ли не отсутствовали массивы, не было интов, и дальше у вас только текстуры и флоты. Иногда это неудобно. Понятно, что человек, которого заперли в бункере, он всё что угодно придумает и сможет сделать любые крутые результаты. Но если хочется жить комфортно, то часто этот же человек дальше придумает язык, который будет транслировать приятный для вас синтаксис в весь этот ужас и кошмар.
Появляется Compute Graphics, наверное, Language [так в записи; на слайде напечатано только «Cg (NVIDIA)», аббревиатура расшифровывается как C for Graphics] и Brook, и начинают зарождаться вычисления на видеокартах общего назначения — соответственно, с более широким и простым синтаксисом, GPGPU; курс поэтому в честь этого и назван. Слайд даёт и датировку, и расшифровку: «2002-2004 — Cg (NVIDIA) и Brook (Stanford) — зарождение GPGPU», «GPGPU — General-Purpose computing on Graphics Processing Units».
Появляются у AMD Close-to-Metal API, у NVIDIA CUDA, являющаяся развитием их языка Cg, у Khronos — стандарт OpenCL. Слайд перечисляет это одной строкой: «2006-2008 — Close-to-Metal (ATI/AMD), CUDA (NVIDIA), OpenCL (Khronos)» — обратите внимание, Close-to-Metal записан через дефисы и приписан ATI/AMD, а не одной AMD. Если я правильно помню — я уже всё забыл, — OpenCL тоже растёт из Brook, на самом деле. Но это не очень важно; важно то, что они появились и стало легче жить: писать такие программы стало гораздо проще, быстрее, эффективнее.
Начал появляться вокруг тулинг: профилировщики, отладчики и прочие полезности, библиотеки в том числе. Их на самом деле не стоит недооценивать. Если бы я сейчас собирал себе компьютер для работы, я бы купил туда NVIDIA и Intel — по той простой причине, что у NVIDIA есть CUDA, в которой есть профилировщики, а у Intel есть Intel Profiler, VTune Amplifier [в записи названы как два продукта; на деле это один — Intel VTune Amplifier, с 2020 года Intel VTune Profiler], который, кстати, сделали наши люди и который очень хорошо работает. Это лучший профайлер, который я видел в жизни, и скорее всего так ещё будет очень долго. Поэтому тулинг важен. Слайд на этом месте добавляет к хронологии только строку «2012 — Compute Shaders в OpenGL».
Позже появился Vulkan («2016 — Vulkan» на слайде). Vulkan — это, читается между строк, способ обмануть NVIDIA, которая, естественно, OpenCL в какой-то момент перестала поддерживать, потому что что-то заподозрила; но в этот раз она не успела среагировать, и Vulkan поддержала достаточно хорошо, и там есть почти всё. Поэтому открытые стандарты — наш путь, можно жить спокойно и хорошо ещё какое-то время, пока NVIDIA это не заподозрит. Есть мнение, что Vulkan почти сознательно вобрал в себя функционал OpenCL. В целом там есть вычислительные шейдеры, как было и в OpenGL, они достаточно функциональны, и там можно довольно хорошо себя чувствовать.
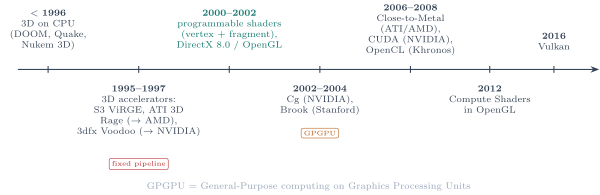
— Vulkan — это не NVIDIA?
Вот, видите, Vulkan вам промыло мозг. Это очень трагично, но Vulkan является стандартом, который делается в рамках Khronos-консорциума, в который входят в том числе NVIDIA — очевидно, пытаясь мешать — и другие компании, включая Intel, AMD, какой-нибудь Qualcomm и так далее, много всего. А зачем они заинтересованы? Вы, возможно, не знали, но это коммерческая компания, у которой в уставе написано «извлекать прибыль», которую они могут извлекать тем эффективнее, чем чаще покупают их продукт. Их продукт покупают, если у них есть CUDA-технология, которая, например, неизбежно используется.
У нас, например, у многих программных решений в области фотограмметрии, обработки компьютерного зрения и так далее почти у всего софта написано в требованиях CUDA. И все пользователи, которые используют этот софт, неизбежно при выборе предпочтут NVIDIA, потому что на другом железе у них просто программа не запустится. И это, очевидно, хорошо работает. Более того, AMD тоже пытается что-то с этим сделать и очень долго не может: исторически у них как-то плохо получалось с софтом. Оказывается, что это тоже важно.
Мне кажется, первое открытие, что это важно, сделал Intel, когда сделал очень крутой профилировщик и крутой Intel-компилятор, который действительно очень большой тогда давал буст перформанса за бесплатно — естественно, только под Intel-овский процессор, но это так запало. Сейчас у вас такая ситуация, что у AMD есть профилировщики, их было даже несколько. Но это, очевидно, проблема: если у вас есть профилировщик, а потом его поддержку дропают и начинают делать новый, то что-то в этой системе не так.
Тенденция в том, что видеокарты очень сильно ускорялись, гораздо быстрее, чем процессоры, потому что архитектура за счёт своей примитивности, с одной стороны, хорошо решает классы задач с массовым параллелизмом. Что это такое — ну вот, например, регулярная решётка; мы подробнее потом поговорим. Но за счёт этого она как бы ограничила себя и хорошо решает конкретный класс задач.
Независимого тулинга на стандарте почти не может быть, потому что вам нужно, чтобы вы могли сэмплировать. Вот, например, как работает любой профилировщик процессора. Давайте прямо сейчас сделаем профилировщик под любой процессор: запускаем под отладчиком, жмём паузу, в блокнотик записываем номер строчки, жмём продолжить, жмём паузу, записываем номер строчки. Мы только что придумали профилировщик, потому что если в восьми случаях из десяти мы окажемся в этом цикле, то статистически тормозит как раз он.
Но, очевидно, мы теперь хотим, чтобы это работало быстро, без такого оверхеда, потому что я пишу бумажку медленно. Значит, мы берём и у процессора регулярно опрашиваем, где он сейчас находится. Если это будет через механику отладки, это будет долго; если это будет нативно интегрировано, это будет быстро. Кроме того, если оно нативно интегрировано, оно может делать это как-то по-хитрому, ещё может спросить нагрузку на кэши, какая пропускная способность достигнута, и прочее, и прочее. А всё это вы очень хотите видеть.
— Но конечному пользователю всё равно.
Да, конечному пользователю не важно. То есть тулинг нужен для разработчика. Но когда у вас разработчик использует NVIDIA, под NVIDIA продукт будет более полированный — и в смысле, например, корректности работы, и в смысле скорости. Поэтому если бы я теперь как умный игрок предпочёл выбрать видеокарту, я реально куплю NVIDIA, просто потому что я знаю, что под неё больше шансов, что всё протестировано. Но дальше вопрос в том, сколько стоит NVIDIA. Я за открытые стандарты, поэтому…
— Слушайте, я слышал, вроде там есть аналог CUDA… (дальше неразборчиво)
Не, ну аналогов миллиард. То, что их миллиард, как бы намекает, что с этим всем есть проблемы. Самое впечатляющее, что я видел, — это CUDA-Z [так в записи; речь, по-видимому, о ZLUDA], который почти без… он даже не требует изменения бинарника программы. Потому что всё, что требует изменения исходников программы, очевидно, обречено: вам нужно, чтобы разработчики это поддержали, а никто обычно не поддерживает. Плюс дальше окажется, что есть куча функциональности, и её так много, что портировать всё это — сумасшествие.
Я во всё это не очень верю, а главное — у вас не будет нативной коммуникации с железкой, у вас не будет профилировщика, и меня, например, такой вариант не устраивает. Разрабатывать серьёзный продукт без возможности запустить под профилировщиком или отладчиком я не готов. Отладчика и у NVIDIA нет, короче. (Утверждение лектора: для CUDA отладчики есть — cuda-gdb, Nsight; оно защитимо только применительно к отладке OpenCL.)
Ну, в Huawei — на чём? На их железе. А их железо даже не купить так просто, кроме как через параллельный импорт или что-то такое. Грубо говоря, Huawei преследует свои интересы, и это нормально, и вас как потребителя или как разработчика это интересовать должно мало — если вас не интересует карьера в Huawei. Или, собственно, всё, наверное, только карьера в Huawei: я не могу придумать другого случая. Ну, или в какой-то азиатской компании — да, естественно, то есть если вы, например, хотите туда поехать, за рубеж, то да.
В общем, разница в гигафлопсах и памяти впечатляет: в гигафлопсах она в пятьдесят раз в какой-то воображаемый момент, в пропускной способности памяти — в двадцать раз в какой-то воображаемый момент. И это то, что мы хотим заэксплуатировать, до чего мы хотим дотянуться — желательно через более приятные API, чем фрагментные шейдеры. Оба числа напечатаны на слайдах как и : первый график — «CPU vs GPU FP32 Peak», логарифмическая ось , скобка на 2025 году между GeForce RTX 5090 ( GFLOPS) и Ryzen 9 9950X3D (); второй — «CPU vs GPU Memory Bandwidth», скобка между RTX 5090 ( ГБ/с) и Core Ultra 9 285K ( ГБ/с). Сами точки на обоих графиках подписаны поимённо — от Pentium 4 2.0 Willamette и GeForce 256 до Core Ultra 9 285K и RTX 5090, — но вслух не названо ни одно из этих устройств. Сейчас оно уже всё очень сильно устоялось, там достаточно приятные вещи, и вот их мы будем использовать.
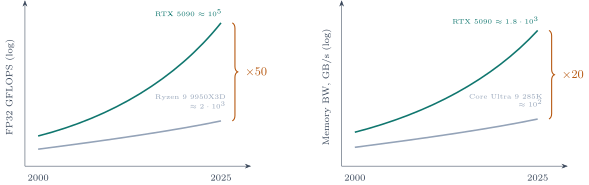
Дальше идёт разделитель главы: «Глава 3: OpenCL API — это красиво, это открыто, это стандарт».
OpenCL API. Супер коротко — то, что нам потребуется в первом домашнем задании. Это открытый стандарт, он работает везде. Любопытно, как он организован — это просто такие инженерные приколы, любопытно, как архитектурно поддержать разные видеокарты. Договорённость такая, что, например, на Linux в папке /etc/OpenCL/vendors/ лежат ICD-файлы. ICD расшифровывается как «устанавливаемый драйвер у клиента» — на слайде напечатано icd = Installable Client Driver. Если я установил какой-то драйвер, обычно он положит сюда файлик, который описывает и подсказывает, где подключить .so-библиотечку, которая позволит использовать этот видеодрайвер или кого-то ещё.
Содержимое этих файликов на слайде выписано целиком, хотя вслух оно не читается: intel64.icd указывает на /opt/intel/oneapi/redist/lib/libintelocl.so, nvidia.icd — на libnvidia-opencl.so.1, и так далее.
Если я вызову программу, например clinfo (на слайде — clinfo -l), которая просто скажет все OpenCL-устройства на этой программе [оговорка лектора: «на этой машине»], то что произойдёт? Она пойдёт по этому пути, в эту папку, увидит там файлы и для каждого файла попытается подгрузить вот эти .so-библиотеки. И у каждой .so-библиотеки вызвать функции, описанные в стандарте OpenCL API. Эти функции выглядят как «расскажи мне, сколько видеокарт», «расскажи, как зовут видеокарту номер один», «как зовут видеокарту номер два» и так далее.
И такая модель позволяет мне одновременно узнать про видеокарту от NVIDIA и про… Как вам кажется, здесь есть что-то сомнительное и подозрительное? Сам вывод на слайде не зачитывается, а в нём вся соль:
$ clinfo -l
Platform #0: NVIDIA CUDA
 `-- Device #0: NVIDIA GeForce RTX 5070 Ti
Platform #1: Intel(R) OpenCL
 `-- Device #0: AMD Ryzen 9 9950X3D 16-Core Processor
Платформа Intel перечисляет процессор AMD. Интересно, что у AMD с софтом, например, какие есть проблемы. У них был драйвер, можно было его установить, и у вас AMD-шный процессор виден как OpenCL-устройство. Естественно, они этот драйвер задепрекейтили [слово в записи неразборчиво; восстановлено по смыслу и по продолжению «и выкинули»] и выкинули — ну кому это надо? Поэтому: даже когда он существовал, Intel-овский драйвер работал быстрее на AMD-шных процессорах, а после того, как они выкинули свой драйвер, выбора даже просто не осталось. Это интересно: должен найтись какой-то человек в AMD, который узнает о том, что есть проблема… Скорее всего, там всё сложнее; я понимаю, что это всё очень сложно, но выглядит прямо анекдотично.
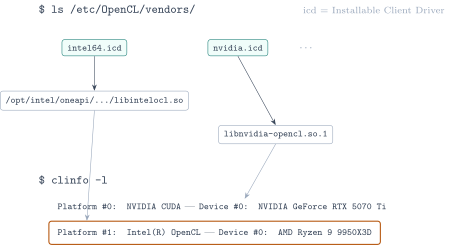
Итого, мы можем поставить, например, NVIDIA-драйвер, AMD-шный драйвер, Intel-ский драйвер. Вы можете воткнуть несколько видеокарт — одну AMD-шную, другую NVIDIA, третью Intel, — главное, чтобы у вас PCI-E слотов хватило, чтобы они не толкались. Это сейчас видеокарты такие, что они в блок питания вообще [неразборчиво]. Но и дальше драйвера за счёт этой конвенции спокойно будут сосуществовать, потому что они не занимают какое-то одиночное уникальное место — «я видеодрайвер, работайте со мной». Каждый из них сказал, что я существую, и теперь мы можем узнать обо всех устройствах, что себя задекларировали в соответствии со стандартом.
Есть ещё разные эзотерические вещи типа FPGA и так далее. Если вы не занимаетесь каким-то там высокочастотным трейдингом и так далее или не делаете проектирование плат, то навряд ли вам это интересно. Но в некоторых крутых университетах есть крутые курсы про программирование FPGA на Verilog, и там люди за счёт этого становятся умнее — повезло, что я могу сказать. На слайде эти платформы показаны только логотипами, вслух они не названы: рядом с intel, NVIDIA и AMD в строке «OpenCL платформы» стоят ALTERA и XILINX.
В любом случае, процессоры, видеокарты — это то, что более повседневно встречающееся и что нас будет интересовать. Целиться мы будем, тем не менее, в видеокарты, но процессор позволит вам тестировать, например, корректность. Есть ещё что-то такое промежуточное — это интегрированная графика. Она отличается от видеокарты тем, что у неё медленная память, такая же медленная, как у процессора, очевидно, но там часто больше вычислительных железок, чем у процессора, просто они специализированы. Поэтому в теории вы через эту штуку можете что-то извлечь, но, очевидно, далеко не в том масштабе, что у дискретной видеокарты.
И вот, как мы обсудили, где-нибудь на eBay до сих пор можно найти остатки интеловского прорыва-бриллианта Intel Xeon Phi, который называется, если что, Knights Landing — типа рыцарский остров [так в записи; Knights Landing «островом» не является, обыгрывается King’s Landing — Королевская Гавань], ну, то есть сразу захотелось купить. В строке «OpenCL устройства» слайд к этому моменту набрал CPU, GPU, iGPU, карту Xeon Phi и, наконец, блок FPGA. Итого, всё это может втыкаться в один компьютер и использоваться.
Два вопроса на этих слайдах напечатаны красным и ни разу не заданы вслух — они и есть формулировка отношения «многие-ко-многим» между платформами и устройствами:
Может ли в одной платформе быть два устройства?
Может ли одно и то же hardware-устройство быть видно из двух платформ?
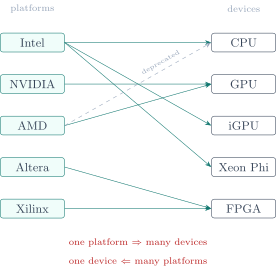
На GitHub-репозитории уже выложено первое задание, и там рассказано, как установить OpenCL-драйвер для процессора, если вам это нужно, как это всё скачать. Что-то там даже на Яндекс.Диск залито — это заливал я лично, поэтому, если вы предполагаете, что мне доверяете, я не клал туда вирусов. Если вы сможете скачать через VPN, то прекрасно; просто напрямую не скачивается. Сам рецепт он не зачитывает, а на слайде он есть целиком: задания лежат на github.com/GPGPUCourse («В этом репозитории предложены задания для курса по вычислениям на видеокартах 2025»), раздел «Задание 0. Вводное.» с бейджем CMake passing, далее «Установка OpenCL-драйвера для процессора» с пояснением «Установить OpenCL-драйвер для процессора полезно, даже если у вас есть видеокарта, т.к. на нём удобно тестировать приложение (драйвер видеокарты гораздо чаще может повиснуть вместе с ОС)». Для Windows: открыть https://software.intel.com/content/www/us/en/develop/tools/opencl-cpu-runtime.html For Intel CPUs (для AMD тоже работает), скачать (если нет прокси — с зеркала файл w_opencl_runtime_p_2025.2.0.768.exe), установить. Для Linux (рекомендуется Ubuntu 24.04): выполнить скрипт install_intel_opencl.sh.
Домашнее задание — делать форк, выполнять TODO-задания в коде. Сейчас мы, по сути, хотим ознакомиться с тем, как работает коммуникация с OpenCL API на уровне «перечисли мне все видеокарты, что у меня есть, расскажи мне про какие-то их свойства». И это последний раз, когда мы контактируем с API напрямую: дальше предлагаться будет библиотека, чтобы не тратить время на машинерию и на boilerplate-код.
Дедлайн — две недели, на все задания всегда. Две недели отсчитываются с дня лекции. (На слайде в строке «Дедлайн: 23:59 … сентября» число просто не напечатано, так что действует произнесённое правило.)
И вот пример, как это выглядит. Есть API-вызов, он работает по какому-то адресу, куда нужно записать число платформ — то есть число этих, по сути, файликов. И вот это, мне кажется, всё ещё полезная точка роста, полезный навык — научиться читать документацию и спецификацию. OpenCL — это место, где, на мой взгляд… ну вот я, например, наверное, с OpenCL научился читать спецификацию и документацию, потому что она реально хорошо написана. Вы её открываете, и там всё рассказано, в том числе все ошибки, которые может эта функция вернуть: прямо расписано — это ошибка, если то, это ошибка, если то, и всё пояснено. И с этим реально можно приятно жить.
Стартовый код слайды показывают целиком, вслух же он сведён к одной фразе про «API-вызов по какому-то адресу»:
#define OCL_SAFE_CALL(expr) reportError(expr, __FILE__, __LINE__)

int main()
{
    // Пытаемся слинковаться с символами OpenCL API в runtime (через библиотеку libs/clew)
    if(!ocl_init())
        throw std::runtime_error("Can't init OpenCL driver!");

    // Откройте
    // https://www.khronos.org/registry/OpenCL/sdk/1.2/docs/man/xhtml/
    // Нажмите слева: "OpenCL Runtime" -> "Query Platform Info" -> "clGetPlatformIDs"
    // Прочитайте документацию clGetPlatformIDs и убедитесь, что этот способ узнать,
    // сколько есть платформ, соответствует документации:
    cl_uint platformsCount = 0;
    OCL_SAFE_CALL(clGetPlatformIDs(/*num_entries=*/0, /*platforms=*/nullptr, /*num_platforms=*/&platformsCount));
    std::cout << "Number of OpenCL platforms: " << platformsCount << std::endl;

    // Тот же метод используется для того, чтобы получить идентификаторы всех платформ —
    // сверьтесь с документацией, что это сделано верно:
    std::vector<cl_platform_id> platforms(/*Count=*/platformsCount);
    OCL_SAFE_CALL(clGetPlatformIDs(/*num_entries=*/platformsCount, /*platforms=*/platforms.data(), /*num_platforms=*/nullptr));

    for(int platformIndex = 0; platformIndex < platformsCount; ++platformIndex)
    {
        std::cout << "Platform #" << (platformIndex + 1) << "/" << platformsCount << std::endl;
        cl_platform_id platform = platforms[platformIndex];
В этом задании понятно, что когда речь про то, чтобы вернуть несколько элементов, тут возникает работа с арифметикой указателей: мы должны указать адрес начала этого массива, указатель на первый элемент, и он тогда запишет туда наши элементы. Поэтому возникает немножко неприятная ситуация: мы сначала спросили про платформы, сколько их, аллоцировали места для записи и ещё раз попросили — теперь уже перечислить все эти элементы в место, которое я аллоцировал. Понятно, вы можете заточиться, что их не больше чем 1024, и сделать это один раз, и дальше как-то это обработать корректно, но просто не очень симпатично. Ну и, наконец, с каждой платформой мы что-то делаем.
Если какие-то вопросы, как будет проходить сдача домашних заданий: вы отправляете pull-request на GitHub, там есть достаточно подробная и сложная инструкция, где рассказано, как его оформить, что от вас ожидается, и так далее. Инструкция на слайде расписана по пунктам: сделать fork проекта; прочитать все комментарии подряд и выполнить все TODO в файле src/main.cpp (для разработки под Linux рекомендуется CLion, под Windows — CLion+MSVC, также можно Visual Studio Community); отправить Pull-request с названием Task00 <Имя> <Фамилия> <Аффиляция>, где аффиляция — SPbU/HSE/ITMO; в тексте PR указать вывод программы при исполнении на сервере Github CI (Github Actions) и на вашем компьютере, в pre-тэгах, чтобы сохранить форматирование, а ваш бранч должен называться так же, как и у меня, — task00; убедиться, что Github CI смог скомпилировать ваш код и что всё хорошо (при отправке первого задания CI может не запуститься, пока я вручную не нажму Approve — если я этого не сделал в течение суток, напомните мне, пожалуйста, в чате курса); ждать комментарии проверки.
Дальше с шансами 99% я организую какой-то continuous integration, который не только проверяет, что это компилируется, но и запускает на одной и той же видеокарте все задания, чтобы из любопытства можно было сравнить всё это, даже если у вас нет какой-то дискретной видеокарты. И он напишет автоматический комментарий с тем, какого перформанса вы добились. Это не так важно в первых заданиях, но это интересно дальше, где алгоритмы можно писать уже достаточно интересные. И потом вы за это получаете баллы.
За курс в целом оценка идёт в первую очередь не на основании домашнего задания, а на основании экзамена. В первую очередь экзамен формирует вашу оценку. Экзамен обязателен. Если вы хотите просто курс зачесть, то вы приходите на экзамен, а условная оценка вас не интересует, она ни на что не влияет; но зачёт-незачёт тоже определяется на основании экзамена. А домашнее задание даёт допуск к экзамену.
На лекции ноутбуки не нужны — только если вы там ведёте записи, только если вам это удобно. Практических занятий не будет почти наверняка, потому что это сложно организовать. Все видеозаписи будут доступны на YouTube в первую очередь. Убедитесь, что вы находитесь в Telegram-чате: там, если что, вы можете спросить, и там я есть — мне в личку можно, в чате спросить, вам подскажут либо однокурсники, либо я. Слайды будут публиковаться на GitHub, домашнее задание — на GitHub; GitHub будет публичным всегда, поэтому домашнее задание, и видеозаписи, и слайды будут доступны также всегда, в том числе для тех, кто не записан на курс.