Зачем знать ассемблер и простейшая модель компьютера
Меня зовут Сорокин Иван Владимирович, я буду читать лекции на курсе C++. Курс рассчитан на один год, то есть на два семестра: в первом семестре обычно рассказываются более базовые, более низкоуровневые вещи, во втором — более продвинутые и высокоуровневые. Занятия проходят по субботам, по две пары лекций. В некоторые недели вместо лекции проводятся практики: после пройденной темы студентам даётся небольшое задание именно на эту тему, и предполагается, что они сделают и сдадут его во время самой практики или в короткое время после неё.
Кроме практик есть более объёмные самостоятельные задания — домашки; с ними нужно посидеть и подумать подольше. В конце семестра будет экзамен из двух частей. Практическая часть — написать программу, примерно соответствующую тому, что делается на практиках, так что практики можно воспринимать как тренировку перед экзаменом. Теоретическая часть — вопросы и ответы: экзаменатор задаёт вопросы по темам семестра, вы на них отвечаете. Ответы на типовые организационные вопросы есть на страничке курса, ссылки скидывались в Telegram; если остались вопросы по организационной части, их лучше задавать там — в Telegram сразу ответят.
Перейдём к содержательной части. Сегодня первая тема, она называется «Введение в x86», или «Знакомство с x86». Хотя курс посвящён C++, я традиционно отдаю примерно три занятия на рассказ про ассемблер. Может возникнуть вопрос: зачем это нужно, зачем тратить на это время? Причин несколько.
Причина номер один, самая главная. Я мог бы рассказывать C++ чисто формально: есть такая-то языковая конструкция, она работает таким-то образом. Но у такого изложения есть проблема: языковые конструкции часто определяются не произвольно, а специально так, чтобы их можно было эффективно реализовать на конкретной железке. Например, static_cast: если есть виртуальный базовый класс и мы хотим привести его к производному классу, static_cast этого не умеет. Не зная, как всё устроено внутри, мы можем лишь сказать: почему-то нельзя, какое-то исключение, откуда-то взявшееся. Но для человека, который понимает внутреннее устройство, это не исключение и не специальный кейс — сразу встаёт вопрос «а как это вообще могло бы работать?», и запрет оказывается совершенно естественным поведением static_cast.
Похожий пример — анонимные функции, лямбды: лямбда, которая ничего не захватывает, конвертируется в указатель на функцию, а лямбда, которая что-то захватывает, — не конвертируется. Откуда это берётся? Без знания внутреннего устройства это опять выглядит как исключение: почему-то иногда так, иногда эдак; со знанием — как совершенно естественное поведение. Вообще, одну фичу иногда удобнее рассказать по внешнему проявлению, по тому, как она себя ведёт, а другую — просто описать, как она устроена внутри, и всё множество различных поведений будет из этого следовать. Этим способом рассказа я на курсе тоже буду пользоваться.
Вторая причина: ассемблер может пригодиться для оптимизации. Не обязательно писать код на ассемблере — достаточно уметь читать код, который выдаёт компилятор. Допустим, мы оптимизируем программу. Какие-то оптимизации делаются из общих соображений: здесь одно и то же пересчитывается несколько раз, там выполняется лишняя работа — для таких высокоуровневых вещей знать внутренности не обязательно. Но в какой-то момент мы можем дойти до состояния, когда есть две похожие функции, отличающиеся незначительными деталями, при этом одна работает сильно дольше другой. Чтобы объяснить, почему так, хорошо бы иметь в голове модель того, что происходит под капотом. Позже мы познакомимся и с тем, что очень многое в программах зависит просто от layout’а данных в памяти: положить одни и те же данные в память немного по-разному — это не просто влияет на время работы, а чуть ли не самый важный влияющий фактор. Зная это, можно, не программируя на ассемблере, размещать данные так, чтобы процессор работал эффективнее.
Третья причина — отладка. Пока программа работает так, как мы ожидаем, нас действительно не особо интересует, что происходит под капотом. Но когда она работает не так, возникает вопрос: что конкретно пошло не так? Скажем, в этой строчке — segmentation fault, а что именно случилось? Надо понимать, что компьютер исполняет не вашу программу на C++ — процессор не умеет исполнять текст. Процессор исполняет программу, которую компилятор создал на основе вашего текста, и в некорректных кейсах она может вести себя иначе. Чтобы разобраться, что случилось, полезно представлять, как работает процессор и какие у него инструкции.
Наконец, четвёртая причина — философская, и она даже не связана с ассемблером напрямую. Если вы пользуетесь библиотекой, инструментом или чем-то ещё, полезно знать, как это устроено и как работает, — тогда вы сможете использовать его корректнее и эффективнее. Мне доводилось сталкиваться на практике с ситуациями, когда люди используют библиотеку, в которой нужная возможность уже реализована, но не знают об этом или не до конца понимают — и городят снаружи собственные костыли, полуправильные и полуэффективные, хотя всё уже есть из коробки. В нашем случае нижележащий механизм для C++ — это, по сути, работа процессора, поэтому мы знакомимся с ассемблером; пригодятся и сведения о том, какие преобразования делает компилятор, и что-то из стандартной библиотеки. Но чем бы вы ни занимались, даже не C++, полезно хотя бы на базовом уровне знать, как работают используемые библиотеки и инструменты.
Это была мотивационная часть — зачем мы с этим знакомимся. Теперь посмотрим более конкретно. Если по ходу рассказа возникают вопросы, сразу пишите их в чат: я периодически туда поглядываю и буду отвечать, не держите вопросы до самого конца.
Мы начинаем говорить про x86, и сразу важный момент: реальные процессоры — суперсложно устроенные штуки. Официальная интеловская документация содержит тысячи страниц, причём она описывает только внешнее поведение процессора; сколько внутри вещей, которые Intel считает своими секретами, — эта документация лишь вершина айсберга. Изучить всё это на сто процентов невозможно: даже отдельного курса не хватило бы. Но нам это и не нужно: чтобы составить представление и получить базовые знания, достаточно упрощённой модели того, как работает процессор и компьютер. Более того, все эти тонкости только усложняли бы понимание. Поэтому мы начнём с чего-то очень простого, но имейте в виду: это именно упрощённая модель, и практически про каждое утверждение в этой лекции можно сказать, что на самом деле всё немножко тоньше.
— А будут ли доступны записи лекций?
— Да, записи будут доступны: по мере того как лекция прошла, я буду стараться выкладывать её на YouTube.
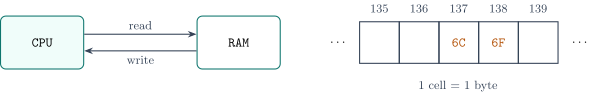
Итак, самая простая модель: в компьютере есть процессор (CPU) и память (RAM), они соединены между собой и умеют общаться; есть две операции — прочитать память (read) и записать память (write). Что такое память? В нашем простом понимании это пронумерованный набор ячеек, каждая ячейка — один байт. Например, в ячейке с номером 137 хранится значение 0x6C, а в ячейке с номером 138 — 0x6F. Можете думать об этом как о массиве. Ячеек столько, сколько у компьютера памяти: если памяти 64 гигабайта, то и ячеек 64 миллиарда. Операция чтения устроена так: я называю номер ячейки — например, хочу прочитать ячейку 137, — а память возвращает мне её содержимое.
Стоит сразу оговориться, что побайтовая адресация — часть именно модели. Реальная память не передаёт данные по одному байту: обмен с ней идёт блоками по 64 байта — кэш-линиями. Байтовая адресуемость, которой мы пользуемся, — это иллюзия, которую поддерживает для нас процессор.
Цикл работы процессора, регистры и инструкция MOV
Каждая ячейка памяти поддерживает две операции. Операция чтения: мы называем номер ячейки и получаем то, что в ней сейчас записано. Операция записи работает в обратную сторону: мы говорим, что в ячейку с таким-то номером хотим записать такое-то значение; оно туда записывается, и последующие чтения будут выдавать уже его. Введём важное определение, которым я буду пользоваться: номер ячейки я буду называть адресом. Например, вот это — ячейка с адресом 137, а эта — с адресом 138.
Обратите внимание: операций «поменять отдельный бит», «установить бит», «сбросить бит» не существует. Если мы хотим поменять отдельный бит, нужно прочитать ячейку целиком, изменить её как нам нужно и записать обратно. Читать и писать можно только ячейку целиком. Какого типового размера эти ячейки? В нашей упрощённой модели будем считать, что один байт. В действительности это, конечно, неправда: в реальном мире никто память по одному байту не читает — процессоры читают память большими блоками, которые называются строками, или линиями (line); можете считать, что их размер 64 байта, хотя в зависимости от модели процессора бывает по-разному. Но для нас на сегодня точно достаточно думать, что память — это просто массив байтов.
— Байт — минимально адресуемая ячейка памяти; кажется, что один байт может быть и не 8 бит?
— В теории можно придумать всё что угодно, но мы люди простые и говорим про конкретную железку: для нас байт — это 8 бит. Хотя в истории действительно существовали архитектуры, у которых минимальная адресуемая ячейка была больше байта. Для нас это не важно.
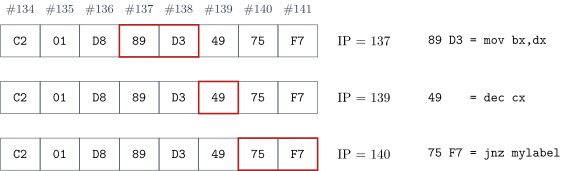
Про память сказали; теперь — что делает процессор. Процессор исполняет команды, инструкции. Что это означает? Внутри процессора хранится специальное число — регистр IP. IP расшифровывается как instruction pointer, указатель на инструкцию: в этом регистре хранится адрес следующей инструкции, то есть номер ячейки памяти, где следующая инструкция должна располагаться. На каждом шаге своей работы процессор читает память по адресу IP и смотрит, что там записано. Инструкция не обязательно состоит из одного байта: процессор может прочитать не только байт по адресу IP, но и следующие — IP плюс один, IP плюс два и так далее. Прочитанное он интерпретирует как некоторую операцию, применяет её эффект и переходит к следующей инструкции, увеличивая IP на длину исполненной.
Вообразите, что на первом шаге в регистре IP хранилось число 137. Процессор полез в память, увидел там 89 и решил, что надо прочитать ещё один байт; он прочитал два байта 89 D3, распознал их как некоторую инструкцию (мы пока не знаем какую), применил её эффект — и IP стал 139. Дальше он повторил шаг: по адресу 139 лежит 49, это уже однобайтовая инструкция; он её прочитал, применил эффект, перешёл к следующей и так далее. Этот процесс повторяется огромное число раз в секунду — до 12 миллиардов инструкций в секунду; это и называется «у нас программа работает».
Байты вроде 89 D3 — это то, что видит процессор, видит железка, но для человека это совершенно незапоминаемые, непонимаемые числа. Поэтому люди договорились записывать их в более человекочитаемой форме — мнемониками: вместо 89 D3 будем писать mov bx, dx, что бы это ни означало, вместо 49 — dec cx. Язык таких мнемоник называется языком ассемблера, а сами числа — машинными кодами. Вот соответствие со слайда:
89 C2    mov dx, ax
01 D8    add ax, bx
89 D3    mov bx, dx
49       dec cx
75 F7    jnz mylabel
Между машинными кодами и ассемблерными инструкциями взаимно однозначное соответствие: одно в другое можно спокойно переводить. Перевод из текста в машинные коды называется ассемблированием, его делает программа-ассемблер; перевод в обратную сторону, из кодов в мнемоники, — дизассемблированием, его делает дизассемблер. Дальше я уже не буду акцентировать внимание на машинных кодах и буду говорить только про мнемоники.
Чтобы познакомиться с командами x86, прежде чем говорить про сами инструкции, нужно ввести ещё одно понятие — регистры общего назначения. Кроме специального регистра IP, в процессоре есть восемь так называемых регистров общего назначения; вот их имена: AX, CX, DX, BX, SP, BP, SI, DI. Что такое вообще регистр? Регистр — это память, которая живёт внутри процессора, и к ней можно быстро обращаться. Регистры общего назначения обычно используются, чтобы хранить промежуточные вычисления: пока программа что-то считает, промежуточные значения не обязательно держать в памяти — их можно держать в регистрах.
Расшифровки имён нам не особенно важны, хотя каждая комбинация букв её имеет: аккумулятор, счётчик, данные, база, stack pointer, base pointer, source index, destination index. Пользоваться ими мы будем практически взаимозаменяемо — может быть, кроме SP. Можете думать, что у вас просто есть восемь переменных. Такие специальные имена — особенность x86: если посмотреть, как сделано на каких-нибудь ARM, там регистры просто пронумерованы — R0, R1, R2 и так далее.
Обратите внимание, что эти регистры 16-битные. Может возникнуть вопрос: как так, почему? Дело в том, что написанное на слайде соответствует первой модели x86 — процессору Intel 8086 1978 года. Нет ли чего поновее? Есть: существуют 32-битное и 64-битное расширения, там появились регистры большего размера, там всего больше — но в каком-то смысле оно и запутаннее. Поэтому сначала мы разберём самый простой, базовый 16-битный вариант, а потом будет несколько слайдов о том, что поменялось в 32 битах и что поменялось в 64 битах. Все самые базовые вещи посмотрим на примерах 16-битных регистров.
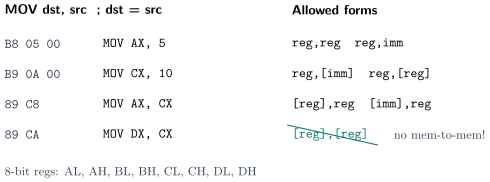
Самая простая инструкция, которую только можно себе представить, — это mov. Запись у неё двухоперандная: mov dst, src. Она делает то, что в C++ делается присваиванием: читает из src и записывает в dst, перетирая то, что там до этого было записано. Например, mov ax, 5 — это то же самое, что записать в AX число 5; mov ax, cx — прочитать значение, которое хранится в регистре CX, и записать его в AX. Справа на слайде написано, в какие машинные коды это транслируется:
mov ax, 5     ; B8 05 00
mov cx, 10    ; B9 0A 00
mov ax, cx    ; 89 C8
mov ax, dx    ; 89 D0
mov dx, cx    ; 89 CA
Запоминать и знать эти коды не нужно — они приведены только чтобы продемонстрировать, что это реальные инструкции, которые исполняет реальный процессор, что они существуют. Самое главное для нас — мнемоники.
Та же инструкция mov используется, чтобы читать и писать память. Чтобы указать, что аргумент — это память, его нужно взять в квадратные скобки. mov ax, [10] означает: возьми десятую ячейку памяти и запиши её в AX — это реально чтение из памяти, чтение десятой ячейки с записью в AX. В квадратных скобках может стоять не число, а регистр, например mov ax, [bx]: в регистре BX записан номер какой-то ячейки памяти — прочитай ячейку с этим номером и запиши её в AX. Аналогично, если квадратные скобки стоят у операнда-приёмника, это запись в память.
— Память — это оперативная память?
— Да, память — это оперативная память.
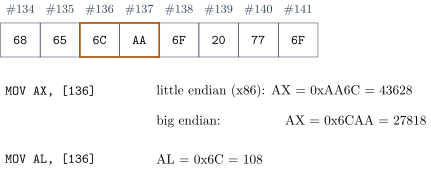
Здесь может возникнуть вопрос. Я сказал, что регистр AX 16-битный, а ячейки памяти — байты, то есть 8-битные. Что вообще означает прочитать ячейку памяти в регистр AX? На самом деле инструкция mov ax, [136] читает не одну ячейку памяти, а две: ячейки 136 и 137 — и из этих двух байтов составляет 16-битное число. Вы, наверное, сталкивались: составить из двух байтов 16-битное число можно двумя способами, расположив их в одном порядке или в другом. То, в каком порядке мы их комбинируем, называется endianness: бывает little endian и big endian. Для нас важно, что x86 — little endian: старший байт лежит по старшему адресу, младший — по младшему. Если по адресам 136 и 137 в памяти записаны байты 6C AA, то после mov ax, [136] в AX попадёт число 0xAA6C = 43628; на big-endian машине получилось бы 0x6CAA = 27818.
Итак, мы поняли, как прочитать из памяти пару байтов. Вопрос: а если два не нужно — можем ли мы прочитать из памяти только один байт? Ответ: да, можем. Для этого существует специальный комплект 8-битных регистров; называются они так: AL, AH, BL, BH, CL, CH, DL, DH. При чтении памяти через них читается ровно один байт: mov al, [136] запишет в AL байт 0x6C = 108.
На слайде нарисовано, как 16-битные регистры пересекаются с 8-битными. В x86 AL и AH — это на самом деле младший и старший байты регистра AX. Когда вы меняете AX, у вас одновременно меняются AL и AH; меняете AL — меняется AX; меняете AH — тоже меняется AX. То есть, меняя один из этих регистров, вы влияете на другие. Точно так же себя ведут BX, CX и DX. А вот регистры SP, BP, SI, DI на составные части не разделены, поэтому обратиться к их младшему байту нельзя — можно, конечно, скопировать значение в AX и обратиться уже там, но напрямую никак.
Я сказал: чтобы обратиться к памяти, операнд берётся в квадратные скобки. Кто-то мог бы подумать: раз так, то, чтобы скопировать из одной ячейки памяти в другую, напишу mov [ax], [bx] — прочитали память по адресу BX, записали память по адресу AX, казалось бы. Но если попробовать это сассемблировать, получим ошибку: nasm: error: invalid combination of opcode and operands. Причина в том, что, хотя синтаксически такую мнемонику написать можно, в процессоре не существует последовательности байтов, которая составила бы одну инструкцию с таким эффектом — инструкции «память в память» просто нет, поэтому и сассемблировать это нельзя. Если мы хотим скопировать из одной ячейки памяти в другую, нужно сначала прочитать [bx] в какой-нибудь регистр, например CX, а потом записать его в память.
Арифметические инструкции, умножение и деление
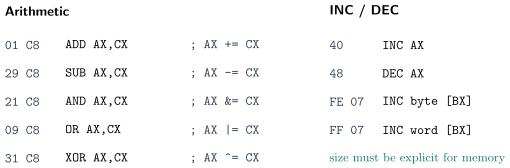
— То есть AX, AL и AH — это одно и то же?
Да, в некотором смысле можно так думать: по крайней мере на старых процессорах внутри это был один регистр, к которому просто можно было обращаться по-разному.
— Почему нет инструкции, которая копирует из одной ячейки памяти в другую?
Сложно сказать — однозначно на этот вопрос могут ответить только дизайнеры процессоров. Но это распространённое явление, и не только на x86: практически на любой архитектуре, хоть на ARM, обычно инструкция либо только читает память, либо только пишет. Хотелось бы накидать аргументов, но они разбиваются о то, что в x86 на самом деле есть инструкции, которые одновременно и читают, и пишут память. Поэтому сказать, что это невозможно или дорого, было бы некорректно — на практике такое существует. Наверное, правильный ответ: неизвестно.
— Если сделать такую инструкцию, как понять, сколько байт читать и записывать?
В этом нет проблемы — можно просто договориться. Далеко ходить не надо: есть семейство инструкций MOVS. Инструкция MOVSB буквально делает следующее: читает байт по адресу, лежащему в SI, и записывает его по адресу, лежащему в DI (DS:SI → ES:DI). Есть аналогичные варианты для величин разного размера: MOVSB — для байта, MOVSW — для двухбайтовой величины, MOVSD — для четырёхбайтовой, MOVSQ — для восьмибайтовой. То есть инструкция, которая одновременно и читает, и пишет память, существует, и ответ на вопрос «сколько байт» простой: разным размерам дали разные названия.
— Это точно именно инструкция?
Да, видно даже, как они кодируются: MOVSB — это A4, MOVSW — A5, а MOVSD отличается префиксом. Не будем сейчас вдаваться в детали кодирования; для нашего 16-битного случая достаточно запомнить: A4 — для байтов, A5 — для двухбайтовых величин.
Итак, разновидности MOV, которая позволяет одновременно прочитать и записать память, у нас нет. Единственные валидные формы MOV — вот такие: reg, reg; reg, imm; reg, [imm]; reg, [reg]; [reg], reg; [reg], imm; [imm], reg; [imm], imm. Здесь imm — это непосредственное число (immediate), непосредственный аргумент, а reg — регистр; по сути, операнды бывают только двух видов: регистры и числа.
— Насколько я помню, копирование в ассемблере происходит побайтово — именно поэтому все операции с памятью такие дорогие на уровне процессора?
Конкретно про MOVSB, MOVSW и так далее: это очень сильно зависит от модели процессора — было несколько итераций того, как их оптимизировали.
— SI и DI — это какие-то специальные регистры?
Посмотрим на картинку: все восемь этих регистров — регистры общего назначения. Для MOV и кучи других инструкций они абсолютно взаимозаменяемы. Есть отдельные инструкции, которые работают только с конкретными из них, но для нас сейчас можно считать, что все они взаимозаменяемы.
Что важно запомнить про MOV: формы «память–память» не существует, а существуют ровно те варианты, которые перечислены выше. Следующие по простоте после MOV — арифметические и логические инструкции: ADD, SUB, AND, OR, XOR. Они делают ровно то, что говорит их название: ADD — примерно то, что в C++ делает оператор +=, SUB — -=, AND — &=, OR — |=, XOR — ^=. Каждая принимает два аргумента, выполняет соответствующую операцию и записывает результат в destination.
Какие у них бывают формы? Ровно те же самые, что я перечислял для MOV, — они существуют и для ADD, и для SUB, и для AND, и для OR, и для XOR. На слайде это видно по кодировкам: 01 C8 — ADD AX, CX, 29 C8 — SUB AX, CX, 21 C8 — AND AX, CX, 09 C8 — OR AX, CX, 31 C8 — XOR AX, CX. Можно, например, работать регистр с регистром, а можно прочитать память и выполнить AND прочитанного с AX. А есть и такая форма, как в последней строчке слайда: AND [BX], AX (кодируется 21 07) — мы читаем память, выполняем AND с AX и записываем результат назад в память. То есть эта последняя строчка — чтение, модификация и запись в одной инструкции.
— Когда пишут AND AX, [BX] (23 07), это значит прочитать память по адресу, который лежит в BX?
Да. Мы смотрим на то, что записано в BX, считаем это номером ячейки в памяти, читаем значение по этому адресу и затем выполняем AND с ним.
Теперь инкременты. Из унарных операций для нас интересны инкремент и декремент: INC прибавляет единицу, DEC вычитает (например, 40 — INC AX, 48 — DEC AX). Единственная интересная вещь с ними возникает, когда мы инкрементируем память: написав INC [BX], мы не говорим, хотим ли мы инкремент байта или двухбайтовой величины — 8-битной или 16-битной. Такая запись неоднозначна, поэтому перед квадратными скобками пишут размер того, что инкрементируется: byte означает 8-битное, word — 16-битное. Соответственно, INC byte [BX] кодируется как FE 07, а INC word [BX] — как FF 07.
Здесь важный момент: весь синтаксис, который я пишу, соответствует ассемблеру NASM — Netwide Assembler, одному из существующих ассемблеров. В мире ассемблеров нет единого стандарта, как в C++, где все компиляторы понимают один и тот же язык: у каждого ассемблера могут быть свои синтаксические особенности. Если какая-то другая программа выдаст вам немного другую запись — не пугайтесь. Очень часто пишут не byte, а byte ptr, не word, а word ptr; если увидите byte ptr [BX] вместо byte [BX], смысл тот же самый, просто другой диалект.
Так же, как INC и DEC, устроены NEG и NOT: NEG — это унарный минус, а NOT — побитовое отрицание, тильда в C++. Те же унарные операции, ничего интересного — думаю, вы с такими вещами знакомы.
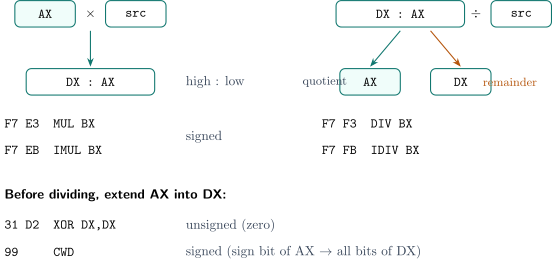
Теперь чуть более интересная штука — как делаются умножение и деление. Первое, что надо сказать: синтаксис команды умножения, традиционно существовавший в x86, такой — мы просто пишем MUL src, как будто это унарная операция. Но мы-то знаем, что умножение бинарно. Дело в том, что вторым множителем у MUL всегда выступает AX: когда вы пишете MUL BX (F7 E3), это означает, что BX умножается на AX. Куда записывается результат? Если перемножить два 16-битных числа, результат, вообще говоря, 32-битный, и инструкция MUL позволяет сохранить его полностью — и старшую, и младшую часть. Результат попадает в пару регистров DX:AX — в DX старшие 16 бит, в AX младшие:
MUL src ; DX:AX = AX * srcВ отличие от сложения и вычитания, у умножения есть разные формы для знакового и беззнакового случая: беззнаково умножает MUL, а знаково — инструкция IMUL (F7 EB). Ещё раз повторю: мы пишем только один множитель, второй — всегда AX, и результат всегда в DX:AX. Почему умножение сделано именно так? Подскажу: чтобы можно было эффективно делать длинную арифметику — старшая часть результата выдаётся, чтобы её можно было переиспользовать в последующих операциях.
Деление синтаксически выглядит точно так же: инструкции передаётся один аргумент src, и это делитель.
— В эмуляторе emu8086 числа представляются в дополнительном коде, или у каждой архитектуры своё представление чисел?
Мы сейчас говорим только про x86, ни про какие другие архитектуры. Здесь числа представляются только в дополнительном коде (two’s complement).
Итак, умножение перемножает 16 бит на 16 бит и выдаёт 32 бита; деление, наоборот, берёт 32-битное делимое и 16-битный делитель, и частное у него тоже 16-битное. Эффект от операции такой: берётся пара DX:AX, делится на указанный src, частное записывается в AX, а в DX записывается остаток:
DIV src    ; AX = DX:AX / src
           ; DX = DX:AX % src
То есть одной инструкцией DIV (F7 F3) мы получаем и частное, и остаток. Почему DIV определён именно так? Опять же для длинной арифметики: если мы хотим, например, разделить длинное число на короткое, мы выполняем пачку таких DIV, сразу получая и частное, и остаток. Точно так же, как с умножением, есть беззнаковый вариант DIV и знаковый IDIV (F7 FB).
С делением связаны вспомогательные операции. Процессор всегда делит 32-битное на 16-битное, а когда мы пишем программу на C++, мы обычно делим числа одинаковой битности — скажем, 16-битное на 16-битное. Значит, из 16-битного делимого нужно как-то сделать 32-битное — расширить делимое. Если мы делим беззнаково, достаточно инструкции XOR DX, DX (31 D2): DX «ксорится» сам с собой, результат всегда ноль, и он попадает в DX.
Здесь часто спрашивают: почему используется XOR, а не какой-нибудь MOV? XOR — это рекомендованный Intel способ занулять регистр: если хотите получить ноль, просто выполните XOR регистра с самим собой. Intel в своих процессорах специально обрабатывает такой XOR как частный случай, чтобы он работал эффективно. Поэтому, если посмотрите, какой код компилятор сгенерировал для деления, перед DIV вы вполне можете встретить такой XOR — он зануляет старшую часть делимого.
Проблема возникает со знаковым делением. (Что при этом с делением на ноль — у меня будет отдельный слайд, сейчас поговорим.) Со знаковым делением нам нужно из 16-битного знакового числа сделать 32-битное знаковое число с тем же значением. Для этого есть специальная инструкция CWD (кодируется 99): она копирует старший, знаковый бит AX во все биты DX. После неё пара DX:AX содержит знаково расширенное делимое, и можно выполнять IDIV.
Сдвиги, ошибки деления и эволюция регистров
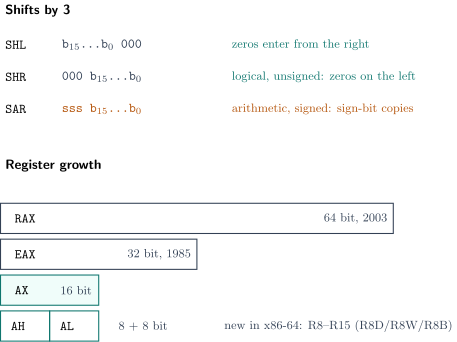
Что, по сути, нужно сделать перед делением? Нужно правильно заполнить старшие 16 битов. Посмотрим на пример со слайда: пусть у нас есть число −1984. Как 16-битное оно записывается шестнадцатеричным F840. Если мы хотим получить 32-битное число с тем же значением, то шестнадцатеричная запись «добивается» FF-ами: FFFFF840. В бинарном представлении это выглядит так, будто мы взяли старший бит — единицу — и размножили её на все добавленные 16 битов. Такая операция называется знаковым расширением (sign extension): если бы старшим битом был ноль, мы размножали бы ноль; раз там единица — размножаем единицу.
И вы, может быть, удивитесь, а может быть, нет, но в x86 специально для этого есть отдельная инструкция — cwd. Она берёт значение, которое хранится в регистре AX, достаёт из него старший бит и размножает этот бит во все биты DX. Возможно, вам где-нибудь встречалось противопоставление RISC и CISC — по-моему, это очень хороший пример чисто CISC-овской инструкции: взять старший бит одного конкретного регистра и размножить его в другой конкретный регистр. Встречать cwd вы будете как раз перед idiv: она ставится перед делением просто для того, чтобы деление правильно работало. В 32-битном коде ту же роль играет её аналог cdq — именно его компилятор вставляет перед idiv, если собрать знаковое деление без оптимизации.
— CWD — это convert word to doubleword? — Да, именно так: она расширяет 16-битное слово до 32-битного.
В чате спрашивают: а что с делением на ноль? Первый момент: если вы попробуете поделить на ноль, инструкция деления остановит исполнение вашей программы и передаст управление операционной системе. Дальше уже операционная система решает, что делать: она может аварийно завершить программу, а может как-то сообщить ей, что случилось деление на ноль. Как именно эта информация передаётся — зависит от операционной системы: Windows сообщит её одним образом, Linux — другим. Но с точки зрения самой инструкции, с точки зрения процессора, при попытке деления на ноль возникает ошибка, управление уходит в операционную систему, и дальше она вправе аварийно завершить программу.
Давайте быстро это изобразим — добавим Executor в Compiler Explorer и запустим программу, которая вызывает foo(42, 0). Пожалуйста: Program returned 136, сигнал SIGFPE — это тот сигнал, который ядро Linux отправляет программе, когда случается деление на ноль.
Теперь смотрите, какой момент. Для беззнаковых чисел это единственный случай, когда такая ошибка может возникнуть: вы действительно делите на ноль. И если вы захотите, скажем, проверить перед делением, что b не равно нулю, имейте в виду: для знаковых чисел есть ещё один кейс, который фейлится ровно с той же ошибкой, — деление минимального целого на −1. Пожалуйста: вызываем foo(std::numeric_limits<int32_t>::min(), -1) — и получаем тот же SIGFPE.
Что на самом деле происходит внутри процессора? Операция деления делит 32-битное число на 16-битное, и если результат — частное — не помещается в выходной регистр, инструкция генерирует ту же самую ошибку, что и при делении на ноль. То есть ошибка, которую выдаёт div, хоть и называется «деление на ноль», на самом деле означает просто «моё частное не поместилось в 16-битный результат». Понятно, что если мы делим 16-битное (знаково расширенное) число на 16-битное, то частное может не поместиться только в двух случаях: либо мы делим на ноль, либо делим минимальное число на −1. Поэтому если вы захотите у себя в программе проверить, зафейлит ли данный input деление, проверять нужно не только ноль, но и эту комбинацию тоже.
— SIGFPE — это floating point exception. При чём здесь вообще floating point? — Это такой курьёз Linux: сигнал при целочисленном делении на ноль тот же самый, что и при ошибках с числами с плавающей точкой. Тут я вам ничего не могу сказать.
— Куда происходит округление при делении? — Округление при делении происходит в сторону нуля. А остаток консистентен с результатом округления: если частное положительное, остаток положительный, если частное отрицательное — остаток отрицательный.
Кроме деления есть ещё операции сдвига. Сдвигов на самом деле много сортов, но нам достаточно знать три: shl, shr и sar. shl — это сдвиг влево, младшие биты заполняются нулями. shr и sar — сдвиги вправо, и кто-то из вас, может быть, знает, почему сдвигов вправо два. shl и shr называются логическими сдвигами, sar — арифметическим; но это научный термин, а по-простому, по-человечески: shr — беззнаковый сдвиг, sar — знаковый. Если вы сдвигаете беззнаковые числа, старшие биты забиваются нулями (shr); если знаковые, то sar заполняет старшие биты копией знакового бита. Бранчи мы сейчас пропускаем — поговорим про них в следующий раз, а следующий раз у нас завтра.
— А если вместо CWD сделать сдвиг — будет то же самое?
— Да, смотрите: CWD можно было бы заменить на такую пару. Сначала mov dx, ax — просто скопировать число, а потом sar dx, 15 — сдвинуть на 15 битов, чтобы знаковый бит раскопировался на весь регистр. То есть mov dx, ax плюс sar dx, 15 дали бы, в принципе, тот же эффект, что CWD.
— Есть ещё циклические сдвиги ROL и ROR.
— Да, есть rol и ror, причём бывают ещё варианты этих роллов через carry flag — rcl и rcr. Есть всякие двойные сдвиги shld, shrd и тому подобное — их много. В коде, который выдаёт компилятор, вы их не так уж часто будете видеть, поэтому для первого знакомства на полтора часа я про них умолчу. Но надо понимать, что инструкций в x86 хватает.
Итак, что поменялось, когда появились 32-битные процессоры? Это 1985 год. Старые регистры остались, как мы их знаем, но появились новые: если был регистр AX, то появился регистр EAX — расширенный AX, уже 32-битный. У всех наших 16-битных регистров появилась 32-битная разновидность. При этом у тех регистров, у которых были две 8-битные половинки, они и остались, а у SP, BP и прочих как не было половинок, так и не появилось — картинка стала соответствующей.
Дальше, примерно 2003 год: появляется 64-битное расширение x86. К 32-битным регистрам в комплект сделали RAX — что означает буква R, не спрашивайте меня. Картинка стала такой: есть большой 64-битный регистр RAX, его младшие 32 бита — это EAX, младшие 16 битов — AX, который разбит на два кусочка AH и AL. С появлением 64-битных регистров случилось ещё несколько вещей, и главная — число регистров удвоилось. AMD не стали заморачиваться с именованием: если первые восемь регистров имели названия AX, BX, CX и так далее, то следующие восемь просто пронумеровали: R8, R9, R10 и далее. Их младшие 32-битные части называются R8D, 16-битные — R8W, и, обратите внимание, у них появились ещё 8-битные кусочки — R8B. Кстати, у SP, BP, SI, DI тоже появились 8-битные части: SPL, BPL, SIL, DIL. Вот такая базовая картинка.
— Чем регистр отличается от кэша процессора, и можно ли обращаться к L1, L3?
— Смотрите, для нас важна следующая вещь. Когда я пишу инструкцию, например mov, одним из аргументов — левым или правым — обязательно должен быть какой-то регистр: я либо читаю из памяти в регистр, либо записываю регистр в память. То есть я вынужден работать через регистры — можете думать о них как о восьми локальных переменных, через которые идёт вся работа. А кэши процессора явно не адресуются: обращение к памяти вы записываете квадратными скобками, и если эти данные уже закэшированы, процессор сам, неявно, возьмёт их из кэша. Если вы многократно обращаетесь к одной и той же памяти — да, она будет браться из кэша. Но в инструкциях вы обращаетесь либо напрямую к регистру, либо к памяти через квадратные скобки.
Теперь, пока есть немного времени, покажу несколько примеров. Я привёл вам кучу разных инструкций и регистров — давайте посмотрим на них вживую. Это, понятно, сайт, но всё, что он делает: берёт input — текст, который подаётся на вход компилятору, — запускает компилятор, условно говоря, с ключиком -S, и то, что компилятор выдал, немножко раскрашивает и показывает справа. Так что это реальный output компилятора, GCC 13.2. Слева я написал функцию f, которая принимает два 32-битных аргумента, возвращает 32-битное значение и делает вычитание. Я говорил, что минус делается инструкцией sub, — и мы действительно видим в коде инструкцию sub. Компилируем с -O2:
f(int, int):
        mov     eax, edi
        sub     eax, esi
        ret
Видно, что компилятор сначала зачем-то делает mov, потом sub, потом ret. Про ret мы не говорили — это конец функции: «функция закончилась, вернись туда, откуда тебя вызывали». А mov объясняется соглашением о том, как компилятор генерирует код: результат функции возвращается в регистре EAX, первый аргумент принимается в регистре EDI, второй — в регистре ESI. Если посмотреть, что здесь происходит, вы согласитесь, что этот ассемблерный код эквивалентен исходному.
Теперь, если я вместо вычитания напишу оператор &, — опа, действительно генерируется инструкция and. Для побитового И используется and, для палки, пожалуйста, — or, и для крышечки — xor. То есть ровно то, что я вам рассказывал, можно увидеть прямо в выводе компилятора. Здесь я использую 32-битные регистры, но на самом деле можно использовать и 64-битные — давайте напишу то же самое с беззнаковым 64-битным типом.
Режимы адресации, lea и оптимизация деления
Посмотрим, что поменялось при переходе к 64-битному коду. Во-первых, если раньше использовались 32-битные регистры eax, ebx, edx, esi, то теперь используются 64-битные. Соглашение о вызовах здесь такое: результат возвращается в rax, первый аргумент приходит в rdi, второй — в rsi. Всё то, о чём я говорил раньше, здесь можно увидеть напрямую. С минусом, and’ом, or’ом, xor’ом всё хорошо, а вот с плюсом — первая несостыковка: для функции uint64_t foo(uint64_t a, uint64_t b) { return a + b; } при -O2 компилятор генерирует не add, а lea rax, [rdi+rsi]; ret. Вопрос: как так получается? Вроде бы должен делаться add, а тут какая-то lea, про которую мы ничего не говорили.
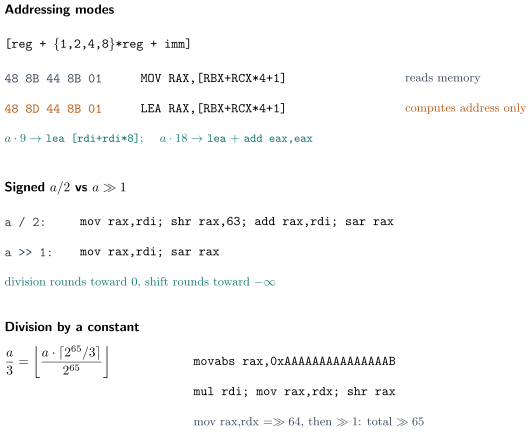
Понятно, что в таком введении в x86 я мог рассказать только самые базовые инструкции, а в реальности их гораздо больше: если вы будете смотреть на программы с floating point, там встретятся и другие незнакомые инструкции. Но про lea стоит сказать отдельно, потому что она встречается очень часто — компиляторы её любят вставлять. Когда я говорил, что в квадратных скобках можно написать либо число — адрес ячейки памяти, либо регистр, я упрощал. На самом деле в x86 в квадратных скобках можно написать гораздо более сложное выражение вида [reg + {1,2,4,8}*reg + imm]: регистр, плюс один из четырёх множителей 1, 2, 4 или 8, умноженный на другой регистр, плюс ещё некоторая константа. Например, mov rax, [rbx + rcx*4 + 1] — валидная инструкция. Понятно, для чего это сделано: это, условно говоря, обращение к элементу массива — первый регистр хранит начало массива, второй — индекс, множитель — размер элемента, а константа — возможное дополнительное смещение.
Так работает mov. Теперь — как работает lea. Синтаксически она повторяет форму mov, читающего из памяти, но расшифровывается как load effective address: она вычисляет адрес, записанный в квадратных скобках, однако не обращается к памяти, а просто записывает посчитанное число в регистр-результат. Поэтому на практике lea используется для арифметических операций: если операция, которую мы хотим сделать, подходит под эту форму, компилятор вставляет lea. Кстати, инструкции MOV RAX, [RBX+RCX*4+1] и LEA RAX, [RBX+RCX*4+1] кодируются почти одинаково — 48 8B 44 8B 01 и 48 8D 44 8B 01 — и отличаются одним байтом опкода.
Приведу примеры. Если написать a + b*8 + 11, компилятор упихивает всё в одну инструкцию lea. Если я скажу a * 9, он сообразит, что это rdi плюс rdi на 8, то есть lea [rdi + rdi*8]. Но если я захочу a * 7, то извините: тут пришлось бы сначала умножить на 8 и потом вычесть единичку, под форму lea это не подходит. А вот a * 18 — пожалуйста: он умножил на 9 через lea, а потом сложил результат сам с собой инструкцией add eax, eax.
— Почему с 16-битными числами использовался не lea, а add?
— С 32-битными числами тоже будет использоваться lea. Вот a + b для 32-битных: компилятор всегда использует форму, где адрес 64-битный, но результат отсекается до 32 битов. Арифметика делается как бы в 64 бита, а потом усекается. А add в тех примерах не использовался — я показывал примеры с минусом и с and’ом, для них такой формы нет.
— Это пример оптимизации компилятора?
— В некотором смысле да. Компилятор умеет паттерн-матчить такие выражения и видит: вот эту форму можно сделать одной инструкцией, а вот a * 18 можно сделать без умножения — через lea и add.
— Если число будет отрицательным, он не отсечёт минус?
— Нет, не отсечёт. Можете считать, что все операции делаются по модулю .
Теперь несколько вещей про деление; для простоты возьмём 64-битные типы. Все знают, что умножение и деление на степень двойки можно заменить сдвигами — это ни для кого не сюрприз. Проверим: пусть функция foo делит на двойку, а функция bar делает то же через сдвиг. Для беззнаковых чисел компилятор сгенерировал абсолютно одинаковые функции: что я пишу деление на два, что сдвиг — одно и то же. Этим примером я хочу показать: иногда сталкиваешься с мнением, что сдвиг якобы дешевле деления. Нет, нифига: генерируется абсолютно одинаковый код, никакой разницы.
Получается, можно всегда писать просто деление? Есть один момент. Я сталкивался и с другим явлением: люди говорят «я могу всегда писать деление, компилятор автоматически сделает сдвиг». Но для знакового типа эти две функции уже компилируются по-разному. Первый вопрос: в чём разница, почему компилятор не смог соптимизировать это деление в сдвиг? Даже замена двойки на другую константу не помогает.
— Знаковость.
— Да, но как знаковость влияет? Подскажу: эти функции просто выдают разные результаты для некоторых входов. Для каких?
— Для нуля.
— Нет, для нуля обе выдают ноль.
— Для минус единицы.
— Да, для минус единицы результаты разные. Вообще они различаются на отрицательных нечётных числах.
Дело в том, что деление на степень двойки и сдвиг — это, можно сказать, одна и та же операция, но они по-разному округляют результат: деление округляет в сторону нуля, а сдвиг — в сторону минус бесконечности. Для положительных чисел разницы нет, а для отрицательных, которые не делятся нацело, одно округляет в большую сторону, другое — в меньшую. Поэтому компилятор и не может оптимизировать деление до сдвига: функции неэквивалентны. Этот пример я показываю вот зачем: люди часто говорят «напиши так, компилятор соптимизирует», забывая, что написанный ими код и код, который они ожидают от компилятора, неэквивалентны. Компилятор не имеет права преобразовать программу в неэквивалентную. Если вы чего-то ожидаете от компилятора, пишите код, который он действительно имеет право так преобразовать.
Посмотрим, что компилятор делает на самом деле для знакового a / 2:
mov  rax, rdi
shr  rax, 63
add  rax, rdi
sar  rax
Финальный sar — это тот же сдвиг, что и в версии с a >> 1. Но перед ним компилятор делает shr rax, 63: берёт знаковый бит, самый старший, и сдвигает его в нулевую позицию, а затем прибавляет к аргументу. Для положительного числа прибавляется ноль и ничего не меняется, а для отрицательного прибавляется единичка. То есть по сути компилятор делает эквивалент if (a < 0) ++a; return a >> 1;. Почему он делает это именно так? Он не хочет лишних бранчей — бранчи для процессора дороги, поэтому всё считается без бранчей. Вывод: если хотите, чтобы компилятор оптимизировал ваш код, пишите эквивалентный код.
Ещё один пример. Деление на два — сдвиг, деление на четыре — сдвиг на два, деление на 32 — сдвиг на пять; этим никого не удивишь. Давайте напишем не степень двойки, а тройку. Наивно можно было бы ожидать, что компилятор сделает div. Но он не делает div, а вместо этого генерирует огромную константу movabs rax, -6148914691236517205 и ещё какие-то операции. При делении на пять — другая магическая константа и другие операции. Про movabs думайте, что это просто mov. Вопрос: что здесь происходит, что за фигню мне сгенерировал компилятор?
— Деление заменяется на всякие mov’ы и mul’ы, алгоритмические трюки.
— Давайте разберёмся, что происходит. Я рядом напишу аналогичную функцию руками.
Сначала про константу. Если навести мышкой, видно, что в шестнадцатеричной записи это 0xAAAAAAAAAAAAAAAB — A много раз, потом B; в двоичном виде это 101010…1011. Эту константу мы записываем в rax через movabs. Дальше мы умножаем её на наше число, пришедшее в качестве аргумента, причём умножение 128-битное: при умножении 64-битного на 64-битное получается 128 бит, старшие 64 бита записываются в rdx, младшие — в rax. Затем идёт mov rax, rdx — я копирую rdx в rax, то есть беру старшие 64 бита произведения; фактически это сдвиг на 64. Потом shr сдвигает ещё на единичку (когда у shr не указан второй аргумент, это сдвиг на единицу) — суммарно получается сдвиг на 65. И если я нигде не ошибся, мой код руками и код компилятора генерируют одно и то же.
— В чате пишут: обратная по модулю.
— В некотором смысле да, можно так на это смотреть. Мы хотим посчитать . Домножим числитель и знаменатель на и перегруппируем: получится в числителе и в знаменателе, то есть деление на константу сводится к умножению на и сдвигу на .
В общем случае это, конечно, верно не для любого : мы считаем в целых числах, при делении что-то округляется, и для каких-то входов результат мог бы получиться другим. Но оказывается, что можно подобрать достаточно большое , при котором равенство выполняется для любого входа. Для деления на тройку нужно брать : именно поэтому a / 3 == (a * (2^65/3)) >> 65, и именно это компилятор и сгенерировал. Этот алгоритм встроен в компилятор, и работает он практически для любого делителя — хоть для семёрки, хоть для 31337: на a / 31337 компилятор выдаёт свою магическую константу и чуть более длинную последовательность:
movabs rax, 842368151689005597
mul    rdi
sub    rdi, rdx
shr    rdi
lea    rax, [rdi+rdx]
shr    rax, 14
— В чате пишут: «Алгоритмические трюки для программистов».
— Да, есть такая книжка: по-английски она называется Hacker’s Delight, по-русски — «Алгоритмические трюки для программистов». Она целиком посвящена подобным вещам: как достать знак числа, как проверить переполнение, как сделать тот или иной битовый хак, как считать целочисленный квадратный корень. И компиляторы знают много таких трюков. В частности, в этой книжке есть целая глава 10 — Integer division by constants, целочисленное деление на константу, — где рассказываются эти алгоритмы.
— Это сложно для начинающих.
— Я просто хочу сказать, что это хорошо известный человечеству приём, а не какой-то специфический хак конкретного компилятора: про него даже в книжках пишут.
Это был последний пример на сегодня; если есть вопросы — отвечу.
— Если умножить два 64-битных числа, результат 128-битный — как он помещается?
— Давайте покажу. В 64-битном режиме mul умножает свой аргумент на rax, а результат размещается в паре регистров rdx:rax: в rdx идут старшие 64 бита, в rax — младшие. То есть результат записывается в пару регистров. И деление устроено аналогично: делитель в современных процессорах умеет делить 128-битное на 64-битное. Беззнаковое div r/m64 делит пару rdx:rax на указанный операнд; частное записывается в rax, остаток — в rdx. Ровно та же техника, что и с 16-битными числами, просто обобщённая на 64 бита.
— Скиньте название книжки.
— Я написал в чате, как она называется; по-русски — «Алгоритмические трюки для программистов». PDF легко найти поиском.
— У нас ограниченное количество регистров. Как это решается для каких-нибудь больших функций?
— Об этом мы поговорим как раз в следующий раз. Но могу подсказать, что там происходит: компилятор часть данных записывает в память и держит в памяти. Если нужно хранить много промежуточных значений, приходится работать с памятью.