Асимптотические обозначения: определения, свойства и примеры
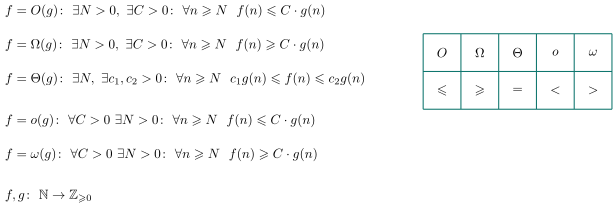
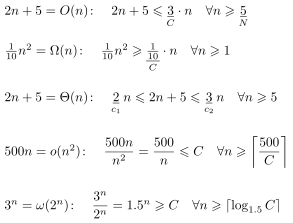
Сегодня мы начинаем осенний сезон курса: нас ждут асимптотика, мастер-теорема, теорема об экспоненциальных рекуррентных соотношениях и алгоритм Карацубы. Начнём с мотивирующего примера. Пусть есть код, который считает некоторую сумму в двух вложенных циклах длины :
s = 0
for i in range(n):
    for j in range(n):
        s += 1
Хочется понять, сколько времени этот код работает. Интуитивно цикл делает примерно итераций, и хочется сказать, что код работает «примерно за ». Однако точная формулировка окажется куда более неприятной: число действий программы может быть, например, , потому что одна итерация цикла способна занимать не одну операцию, а несколько. Оперировать такими громоздкими выражениями не хочется — хочется писать именно «примерно ». Но «примерно» — не очень конкретный значок, и мы сейчас познакомимся со специальной формалистикой, которая призвана этот «примерный квадрат» формализовать.
Перед этим ответим на вопрос: зачем вообще измерять, сколько времени работает программа? Ответ простой. Тактовая частота моего процессора составляет примерно ГГц, то есть в распоряжении есть около операций в секунду. Поставим задачу: при каком максимальном код, делающий примерно операций, успеет отработать за одну секунду? Нужно, чтобы , то есть . Это вполне практичное знание.
Здесь есть один неприятный нюанс: оценка верна, только если вы действительно успеваете выполнять такое число операций. Для быстрого языка вроде C++ подобные прикидки работают достаточно неплохо. Но если язык медленный — например, Python, — то стоит считать, что в секунду выполняется порядка операций. Тогда максимальное для квадратичного кода составит примерно .
Чтобы формально записывать «примерно », введём семейство обозначений. Пусть — функции из натуральных чисел в целые неотрицательные. Говорим, что , если существуют константа и момент , такие что для всех ; иначе говоря, начиная с некоторого момента ограничена сверху константой, умноженной на . Говорим, что , если существуют и , такие что для всех — теперь прижата к снизу с какой-то константой. Наконец, — комбинация этих двух обозначений: , если существуют константы и момент , такие что для всех , то есть зажата между с двух сторон с какими-то константами.
Приведём парочку примеров. Во-первых, : достаточно взять и , поскольку при всех . Во-вторых, : выберем , и тогда при всех . Рассмотрим и пример с : мы уже оценили сверху, оценим ещё и снизу. Это не более сложно: при всех , так что , , а , и значит .
Мы познакомились с -большим, -большим и . В некотором смысле это операторы сравнения функций: про , и стоит думать как про , и соответственно — с точностью до константы. Смотрите: вряд ли «больше», чем , — с точностью до константы они действительно совпадают; а — «хотя бы» в том формализме, что мы определили. Но коль скоро существуют нестрогие знаки сравнения, должны существовать и строгие: -маленькое и -маленькое, отвечающие знакам и . Итого соответствие такое: , , , , .
Определим строгие сравнения. Говорим, что , если для любой константы существует момент , такой что для всех . Аналогично , если для любой константы существует момент , такой что для всех . Обратите внимание на порядок кванторов: в отличие от и , здесь неравенство должно выполняться для любой константы, а не для какой-то одной.
Перед тем как двинуться дальше, переформулируем определение -маленького. Если переписать неравенство в виде частного, получится, что для любой константы с некоторого момента. Правда, стоит заметить одну маленькую вещь: в исходном определении функции и могут принимать нулевые значения, а переписанный вариант имеет смысл, только если никогда не обращается в ноль.
Как и в прошлый раз, посмотрим на парочку примеров. Пример первый: , то есть растёт существенно медленнее, чем . Докажем это через определение с частным: нужно, чтобы для любой константы с некоторого момента. Для любой это неравенство можно просто решить: оно верно при всех , а значит, по определению . Пример второй: , то есть растёт строго быстрее, чем . Действительно, частное должно быть хотя бы для любой константы с некоторого момента — и это выполнено при всех .
Зачем мы всё это вводим? Вспомните пример, где мы говорили, что функция работает «примерно за ». Теперь вместо расплывчатого «примерно» мы можем воспользоваться двумя точными утверждениями: сказать, что код работает не более чем за с точностью до константы, или что он работает в точности за с точностью до константы. То есть записать, что наш алгоритм работает за или даже за .
Сформулируем парочку свойств. Раз , , , и — это в некотором смысле операторы сравнения, для них должны выполняться естественные свойства, и они действительно выполняются. Свойство первое: тогда и только тогда, когда — действительно, « не больше » ровно когда « хотя бы »; аналогичный факт верен и для строгих знаков: тогда и только тогда, когда . Свойство второе — транзитивность: если и , то . Свойство третье: если , то . Свойство четвёртое: тогда и только тогда, когда одновременно и . И пятое свойство: умножение функции на положительную константу сохраняет асимптотику — если , то . По аналогии можно сформулировать ещё парочку свойств, но нам этого будет достаточно.
Для иллюстрации докажем одно свойство — мне нравится второе, но все остальные тоже очень простые и доказываются по определению. Пусть : это значит, что для всех . Пусть также : это значит, что для всех . Из этого можно сделать прекрасный вывод: для всех . Но это в точности определение -большого для утверждения — с константой и моментом .
Прежде чем двинуться дальше, ещё парочка примеров того, как может встретиться в жизни. Первый пример — сумма гармонического ряда: , где . Этот факт мы подробнее докажем на второй лекции, а пока поймём, что такая запись значит, — ведь напрямую вида «функция равна от чего-то» мы здесь не видим. Запись означает следующее: существует некоторая функция ошибки , которая равна , и подстановка её в выражение превращает его в верное равенство.
Пример второй называется формулой Стирлинга. Она утверждает, что — это примерно . Но слова «примерно» у нас нет, а точный факт формулируется так: .
Ещё в жизни вам часто может встретиться запись , причём в логарифме не указано основание. Когда основание не указано, обычно имеется в виду одно из двух: либо основание — двойка, либо основание не важно. В данном случае основание именно не важно, и вот почему. Факт: , поскольку — то есть, говоря по-человечески, все логарифмы отличаются друг от друга в константу раз. А так как -большое «съедает» все константы, то основание логарифма можно и не писать.
И ещё парочка свойств. Утверждение: если к функции добавить или вычесть -маленькое от , то асимптотика не изменится — результат останется . Докажем. Обозначим эту добавку через : я знаю, что , и хочу доказать, что . Подставим определение -маленького: для любой константы с некоторого момента — и выберем конкретное значение, мне нравится , то есть при всех . Что это даёт? Получается, что для всех . А это по определению и значит, что : функция зажата между снизу и сверху с некоторыми константами, начиная с какого-то момента.
Следующее утверждение — про многочлены. Пусть есть многочлен , причём старший коэффициент положителен: — так мы изучаем ситуацию, когда функция положительна. Утверждение: , то есть многочлен асимптотически ведёт себя как свой старший член. Жизненный пример применения: .
Почему же этот факт верен? Он прямо следует из предыдущего утверждения, если понять, что все мономы, кроме старшего, — это -маленькое от старшего. Докажем вспомогательную лемму: . По определению с частным: должно быть ограничено любой константой — и действительно, при всех ; частный случай этого утверждения мы уже проделывали, когда сравнивали и . Итак, коль скоро все мономы, кроме старшего, — -маленькое от старшего, их можно по предыдущему утверждению просто выкинуть, и асимптотика сохранится. Остаётся старший член , а мы уже обсуждали, что умножение на положительную константу сохраняет асимптотику: .
Теперь представим жизненный случай: вы написали программу и хотите понять, сколько времени она работает. Первый пример — ровно тот код, что мы обсуждали в начале пары: два вложенных цикла длины . Мы уже пришли к тому, что его можно оценить как , ну или сказать, что он — в принципе, и то, и другое верные утверждения.
Посмотрим на более сложный второй пример, где внутренний цикл зависит от внешнего:
for i in range(n):
    for j in range(i):
        s += 1
Сколько операций делает этот код? Он делает сумму по от нуля до примерно операций, грубо говоря, то есть всего примерно операций. Ну и опять-таки мы знаем, что это .
Третий код, в принципе, аналогичен второму, только вложенных циклов теперь пять. Опять-таки можем сказать, что это примерно операций, или . Разве что здесь хочется обратить внимание на константу: она выросла до , поэтому, когда вы пишете такой код, об этой константе стоит думать — оценка не совсем точна, и стоит помнить, что при ней есть константа.
Оценка вложенных циклов и мастер-теорема
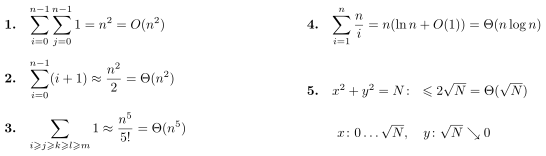
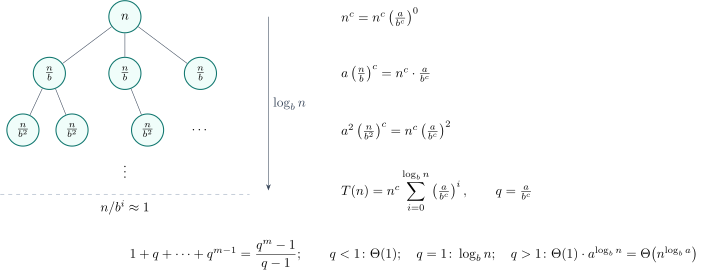
Пример ④. Внешний цикл перебирает от 1 до , а внутри стоит цикл for от нуля с шагом , пока индекс остаётся в диапазоне до :
for i = 1..n:
    for (j = 0; j < n; j += i):
        ...
Хочется сказать, что этот код работает примерно за операций — и это правда, но оценка слишком грубая, здесь можно получить лучше. При фиксированном внутренний цикл делает порядка итераций, поэтому весь код работает за операций. Этот ряд нам уже знаком: вынесем и получим гармоническую сумму. Мы формулировали без доказательства, что . Значит, ответ — : куда более быстрая величина, чем грубая оценка .
Пример ⑤, в котором нас тоже ждёт подвох. Задача: посчитать количество целых неотрицательных решений уравнения . Решать будем так: перебираем по возрастанию, а внутренним циклом уменьшаем до подходящего значения; если оказалось, что , выводим ответ . Стоит аккуратно заметить, что переиспользуется в каждой следующей итерации внешнего цикла, но это логично: когда увеличивается, наибольший подходящий , разумеется, только уменьшается.
Какая будет грубая оценка этого кода? Внешний цикл делает итераций, и внутренний цикл за один проход делает не более итераций, итого . Такая оценка верна, но, как и в предыдущем примере, она грубая; на самом деле можно доказать, что код работает за . Ключевое наблюдение: каждая итерация внутреннего цикла уменьшает на единицу, а между итерациями внешнего цикла не восстанавливается, поэтому суммарное количество итераций внутреннего цикла за всё время работы тоже не превосходит . Итого: итераций внешнего цикла и суммарно не более итераций внутреннего. Вся остальная работа ограничена суммарной работой циклов, поэтому достаточно посчитать именно её — и получается .
Пример ⑥ — небольшая модификация примера ④. Поставим такую задачу: для каждого числа от 1 до сохранить список его делителей. Например, у единицы делитель 1, у двойки — 1 и 2, у тройки — 1 и 3, у четвёрки — 1, 2 и 4. Как решать: как в коде примера ④, переберём делитель и пройдём по числам с шагом , для каждого такого числа запоминая делитель . По тем же соображениям, что и в примере ④, это работает за .
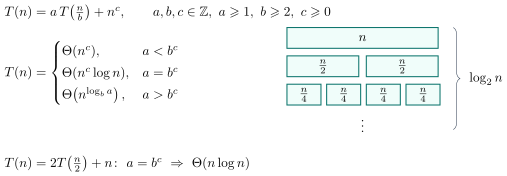
Следующее утверждение называется мастер-теоремой, или теоремой об основных рекуррентных соотношениях. Формулируется она так: пусть . Когда такая рекуррента встречается в жизни? Представьте, что у нас есть алгоритм, время работы которого мы хотим оценить, и этот алгоритм запускает сам себя рекурсивно, например, два раза на задачах размера , а на подготовку к запуску рекурсии тратит ещё, скажем, операций. Достаточно частый пример — время работы одного из алгоритмов сортировки: задача дважды запускается на половинном размере. Хочется понять, чему же в итоге равно , и мастер-теорема отвечает на этот вопрос.
Точную формулировку запишем чуть позже, а пока зафиксируем условия: — целые константы, причём осмысленно применять теорему, когда , когда (чтобы рекурсия не зацикливалась) и когда . В зависимости от нескольких случаев будет равно разным величинам, и сейчас мы разберёмся, каким именно.
Нарисуем дерево рекурсии нашего алгоритма. На самом верхнем уровне — одна задача размера . На следующем уровне рекурсии будет задач, каждая размера ; на втором уровне — задачи размера , и картинка продолжается до тех пор, пока частное не станет примерно константой. Когда размер задачи ограничен константой, алгоритм работает константное время — в листьях дерева лежат задачи константного размера, . Отсюда, кстати, можно оценить и размер дерева рекурсии: его глубина — .
Теперь просуммируем работу по этому дереву. Начнём с корня: в корне задача размера , то есть работа . На следующем уровне задач размера , то есть суммарно . Уровнем глубже задач уже , каждая размера , то есть . Можно продолжать расписывать всю сумму, но давайте её приведём: в каждом слагаемом есть множитель , вынесем его. Первая строчка — это , вторая — , третья — , и так далее по всем уровням. Получается чудесная сумма: .
Вынесем за знак суммы и посмотрим, как суммируется геометрическая прогрессия. Суммируется она просто: , или, что то же самое, . Всё, что происходит внутри скобки, очень зависит от того, какая у нас прогрессия со знаменателем : убывающая или возрастающая. И, как всегда, есть особый случай , когда формула неприменима, — с него и начнём.
Если , то есть , каждое из слагаемых равно . Значит, . Это первый случай: при получаем .
Теперь изучим, что происходит, когда , то есть . Известный факт: сумма геометрической прогрессии со знаменателем меньше единицы стремится к константе. Давайте напишем конкретную константу: это , ведь если в выражении перейти к пределу по при , то уходит в ноль. Раз сумма стремится к константе, она есть — тем более что она хотя бы единица. Для нас это значит: если , то в скобке стоит константа, и .
Перед последним случаем сделаем небольшое наблюдение. В случае геометрическая прогрессия, по сути, определена своим первым элементом: вся работа задаётся самым верхним уровнем дерева, а всё остальное оценивается константой относительно него. Во втором случае, когда , работа на каждом уровне была одинакова, поэтому итог — значение на одном уровне, умноженное на количество уровней. Если же , то сумма прогрессии есть её последнего члена: вся работа определяется самым нижним уровнем рекурсии. Иначе говоря, дерево разрастается настолько быстро, что уже не важно, какая функция стоит в вершине, — суммарное время работы определяется тем, насколько картинка разрослась вширь.
Поэтому в этом случае просуммируем только последний уровень. Мы договаривались, что на самом нижнем уровне всюду записано , примерно равное константе, значит, время работы в каждой вершине последнего уровня константное. Осталось понять, сколько там вершин: (число вершин на последнем уровне), а вершин там . Величина немножко неприятная — степень с логарифмом в показателе смотрится плоховато, давайте её перепишем. Заметим, что , поэтому . Итак, в третьем случае, при , получаем . На случай, если возник вопрос, почему здесь я не стал явно подставлять формулу суммы прогрессии, как в предыдущем случае: можно было и так, ответ получился бы тот же, просто формул было бы чуть больше.
Вернёмся к формулировке: теперь готовы все три случая, посмотрим на примере. Пусть : здесь , , , то есть и , и равны двум — мы попали в случай . Значит, решение этой рекурренты — .
В данном случае тот же ответ можно получить и более простым способом — нарисуем такую картину-башенку. На верхнем уровне задача размера , на втором — две задачи размера , на следующем — четыре задачи размера , и так далее. Итого получается этажей, каждый из которых суммарно имеет размер . Значит, суммарная работа по обработке этой башенки — . Но на самом деле это просто частный случай того рассуждения, которое мы только что проделали в общем виде.
Следующий наш герой — теорема об экспоненциальных рекуррентных соотношениях. Выглядит она так: пусть — тогда про это тоже можно кое-что сказать, и сейчас разберёмся, что именно. Так как нас интересуют случаи, когда — время работы какой-то программы, будем считать, что , с естественными ограничениями и — иначе размер задачи не уменьшится.
Где такое может встретиться? Представьте, что вы разработали алгоритм для какой-то сложной задачи с экспоненциальным временем работы, но умеете чуть-чуть уменьшать задачу, запускаясь рекурсивно несколько раз, — и вам интересно, за сколько он будет работать. Короткий спойлер: раз звучат слова «экспоненциальные», программа работает за экспоненту, но за какую именно — надо ещё разобраться. В простейшем случае это достаточно очевидно: если каждый раз разбивается на два , то строится полное бинарное дерево, и это явно . А что будет в общем случае, мы сейчас узнаем.
Предположим, что мы в идеальном мире и — ровно . На самом деле дальше мы и получим, что — экспоненциальная функция, но пока представим, что даже без всяких это в точности . Подставим это значение в рекурренту: слева получится , справа — . Возникает логичное желание сократить на — давайте так и сделаем. Получилось уравнение . Может показаться странным, но это, по сути, полином от : степени здесь отрицательные, но если мысленно домножить на подходящую степень , получится самый настоящий многочлен, который, кстати, называется характеристическим.
Что важно для нас: я утверждаю, что у этого уравнения существует корень больше нуля, причём единственный. Давайте поймём, почему он действительно ровно один. Слева записана константа. А справа: каждое — убывающая функция от , стремящаяся к нулю на бесконечности; сумма таких функций с положительными коэффициентами — снова строго монотонно убывающая функция, стремящаяся к нулю на бесконечности. Нас интересует значение единица: проведём горизонтальный уровень , и точка, в которой кривая его пересекает, — это и есть наш единственный положительный корень . И утверждение теоремы состоит в том, что если этот корень найти, то , где — решение характеристического уравнения.
Рассмотрим это дело на частном случае — рекурренте Фибоначчи . Подставляя , получаем , то есть , то есть . Это квадратное уравнение; решая его, получаем . Теорема говорит: раз мы такой корень нашли — а мы его нашли, — то .
Давайте доказывать. Я докажу с вами, что ; нижняя оценка доказывается аналогично, и мы её опустим. Что я хочу доказать: существует некоторая константа такая, что . Доказывать будем по индукции, а у индукции две части: база и переход. В базе нужно проверить неравенство для маленьких .
Экспоненциальные рекурренты и алгоритм Карацубы
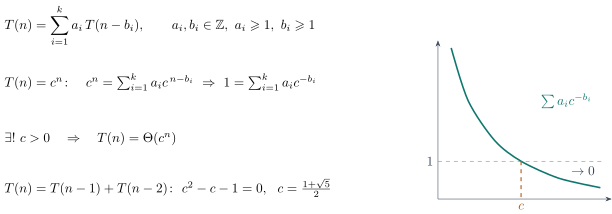
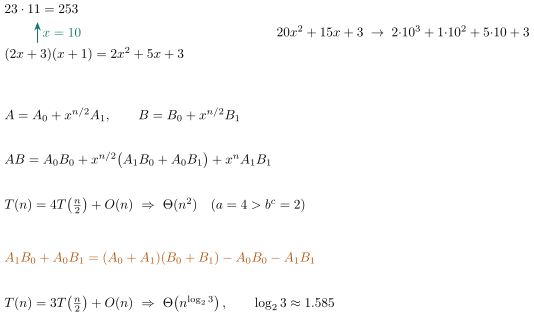
Докажем теорему о рекуррентах по индукции. Утверждение такое: существует , для которой . Почему вообще нужно аккуратно формулировать базу? Потому что при маленьких рекуррентная формула просто неверна: например, при подставлять в неё нечего. В таком случае мы считаем, что при — некоторые константы. Хочется, чтобы неравенство выполнялось и для них, но поскольку здесь записано лишь конечное число неравенств, можно просто подобрать достаточно большой, чтобы все они были верны.
Теперь переход индукции. Пусть для любого верно наше утверждение, то есть . Распишем по определению: . Во всех слагаемых аргумент уменьшился, значит, можно применить индукционное предположение и подставить оценку в каждое слагаемое: . Следующим действием выносится за скобку, поскольку она появилась везде, и остаётся . А теперь вспомним, что такое : это величина, которая является корнем уравнения . Поэтому последнее выражение превратилось ровно в , что и требовалось. Если резюмировать: в переходе вся хитрость в том, что выносится за сумму, а в базе такую иначе просто не зафиксируешь — её нужно взять достаточно большой.
Ещё пару слов про оценку снизу, то есть про . Соответствующие неравенства касаются главным образом базы, переход остаётся ровно таким же. Есть момент, когда база не сработает: если — нулевая функция, то ограничить её снизу не получится; там надо требовать, чтобы была хотя бы какой-то положительной константой. Если же всегда больше нуля, то и такая база, и такой переход остаются ровно теми же.
Последнее, что мы сегодня сделаем, — обсудим алгоритм Карацубы, который нужен, чтобы умножать многочлены и числа. Начнём с наблюдения. Если раскрыть скобки в произведении , получится . А теперь умножим числа: . Заметьте, что и здесь, и здесь получилось одно и то же — и это не просто так. Умножение чисел — это почти то же самое, что умножение многочленов: когда я пишу , на самом деле это . Поэтому число логично представить многочленом : умножаете ваши числа как многочлены, а в конце подстановкой превращаете многочлен обратно в число — из получается .
Есть, правда, нюанс: в конце можно получить многочлен вроде , а числа, у которого первая цифра , вторая , а последняя , не бывает. Но это несущественная трудность: вы просто получаете число и делаете все переносы. Что получится? В младшем разряде остаётся , дальше , а единица ушла в следующий разряд; там , снова оставляем единицу, и двойка уходит ещё выше: итого . Поэтому, чтобы умножить числа, вы умножаете многочлены, а в конце за линейное время делаете переносы. Значит, дальше с вами будем обсуждать только, как умножать многочлены.
Самое простое умножение многочленов пишется так:
for i = 0 .. |a| - 1:
    for j = 0 .. |b| - 1:
        c[i + j] += a[i] * b[j]
Здесь есть неприятный момент: количество коэффициентов многочлена и его степень — разные вещи. Когда я пишу , я имею в виду количество коэффициентов; например, у многочлена оно равно трём. Несложно видеть, что этот алгоритм работает за .
Давайте сделаем что-то более умное. Если вам сейчас будет некомфортно с делением пополам, считайте, что — это просто степень двойки. Разобьём коэффициенты каждого из многочленов и на две половинки: забирает себе младшую половину коэффициентов, , а — старшую, , причём заметьте, что здесь все показатели у уменьшены на эту половинку. Иначе говоря, я представляю ; многочлены и определяются аналогично.
Теперь распишем, что такое . Подставляем наши представления и раскрываем скобки: . Как это вычислить? Нам дали два многочлена, мы разбили их пополам, и внутри произошли рекурсивные вызовы: получилось четыре рекурсивных вызова на половинках, результаты которых мы по этой формуле склеиваем за линейное время. Значит, время работы алгоритма выглядит так: . Что нам говорит мастер-теорема по этому поводу? Надо сравнить и : здесь , а , то есть частное больше единицы, и мы попадаем в случай . Это достаточно грустно, потому что за мы и так умеем очень просто умножать.
И вот тут возникает трюк Карацубы. Давайте я величину немножко перепишу: . Что из этого следует? Что на самом деле нам нужно не четыре рекурсивных вызова, а три: первый — , второй — , третий — , а в формуле выше снова участвуют первый и второй. Вычислив эти три произведения, мы по той же формуле склеим ответ. Значит, в рекурренте надо писать не четыре, а три: , и по нашей теоремке получится .
На этом наша пара на сегодня заканчивается, и в конце я добавлю ещё парочку формулировок, потому что главная тема сегодня была асимптотика, а не само умножение. Формулировки такие: логарифм в любой степени — это о-малое от степени с любым положительным показателем, то есть для любых ; а степень с любым показателем — это о-малое от любой экспоненты, то есть для любого . Парочка примеров: — квадрат логарифма меньше даже вот такой микроскопической степени; и — огромная степень проигрывает даже такой, казалось бы, безобидной экспоненте.