Метод четырёх русских и основы длинной арифметики
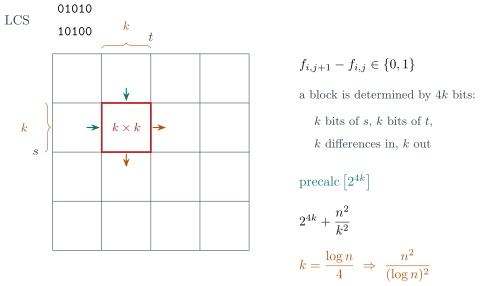
Наша основная тема сегодня — повтор: вам придётся вспомнить всякое из того, что вы уже узнали. Но сперва давайте разберём маленький кусочек того, что нужно было сделать и до чего мы ещё не успели дойти, — метод четырёх русских. В прошлый раз это было в умножении матриц, а сегодня потренируемся ускорять НОП. Пусть у нас есть две двоичные строки, например и ; наибольшую общую подпоследовательность мы умеем искать динамикой за время . Динамика выглядит как — наибольшая общая подпоследовательность префикса длины и префикса длины . А сейчас я напишу ту же самую динамику, но получу время .
Кто уже умеет так делать? Нужно смотреть на подматрицы размера , разрезать таблицу на такие подматрицы. Нужно уметь решать какие-то маленькие подзадачки — вот то направление, по которому мы пойдём; и нам повезло, что строчки состоят из ноликов и единичек. Давайте попробуем эту квадратную табличку разбить на кусочки размера — на такие клеточки. Что нам нужно, чтобы посчитать очередную клетку?
Чтобы посчитать вот эту клетку целиком, а она состоит из чисел, мне нужно знать значения динамики в начале строки, значения динамики в начале столбца и, видимо, ещё важно, какие символы выпали. У меня есть две строки: по одному направлению я отложу строку , по другому — строку . Значит, мне нужен кусок строки длины и кусок строки длины . Утверждение: всё это можно описать битами, если клеточка размера .
С двумя кусками строк всё понятно: тут бит, потому что ноликов и единичек, и тут тоже бит. А вот значения функции — это, вообще говоря, целые числа, это не биты. Как увидеть в них биты?
— Там не биты, там инты какие-то.
— Нет, там всё гораздо лучше устроено, потому что соседние клетки в динамике почти не отличаются. Соседние значения могут отличаться либо на , либо на : величина всегда принимает одно из двух значений, или . Поэтому нам действительно хватает даже не бит, а чуть меньше: здесь нужно бит и здесь бит. А то число, которое стоит в самом начале, на самом деле не нужно, потому что оно сдвигает всё на константу. Если я храню разности соседних в строке и разности соседних в столбце, то от того, что я забуду эту константу, все числа просто одновременно уменьшатся на одну и ту же величину, а на то, как динамика пересчитывается дальше, эта константа не влияет: пересчёт будет точно таким же.
Итого, после того как я всё это нарисовал, я говорю, что могу сделать себе предподсчёт по всем вариантам и для каждого сохранить результат. Что именно я хочу сохранить? Внутри клетки я считал динамику — долго и нудно, — но интересно только то, что окажется на выходе из клеточки, чтобы начать считать следующие клеточки. Причём здесь я сказал, что хочу работать с массивом разностей, а не с массивом : переходить туда-обратно очень глупо — хранить , в момент запуска динамики пересчитать разности, потом получить обратно , ещё раз посчитать разности и снова вернуться к разностям. Давайте просто везде таскать с собой разности соседних. Тогда динамика получила битовую маску разностей по строке, битовую маску разностей по столбцу и вернула две битовые маски — то есть подсчёт одной клеточки у меня теперь работает за . И естественно, так мы сделаем «количество клеток» раз.
Моё решение сейчас работает за время , где второе слагаемое — количество клеточек. Нужно ещё не забыть подобрать , но, видимо, логарифм, делённый на что-то, подойдёт, чтобы предподсчёт был порядка . Например, точно подойдёт.
— А можешь, пожалуйста, объяснить, откуда ? Почему предподсчёт за столько?
— Ой, не за , я глупость написал: я четвёрку не туда поставил. У нас бит, а значит, вариантов . Стало лучше?
— Да.
Тогда и возьмём не , а — точно с запасом. А то вдруг тут полезут ещё какие-нибудь логарифмы, про которые я забыл, и буду двоечник. Метод четырёх русских закрыли, переходим в мир длинной арифметики.
Длинную арифметику обычно никто из вас не пишет. Или вы писали, на плюсах? Писали. А что именно? Реально быстрое сложение, которое работает в системе счисления . Давайте сперва поговорим вообще о том, как работают простые операции. Сегодня мы с вами научимся делить и умножать за — всё научимся делать, — но сперва простые вещи: число надо считать, вывести, сложить, как-то хранить в памяти.
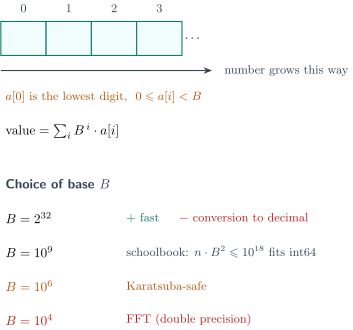
Как же работает длинная арифметика? Число обычно хранят в массиве. Число иногда растёт, становится всё больше и больше, и вектор растёт вместе с ним; чтобы числу было удобно расти, оно растёт в ту же сторону, что и вектор. Соответственно, младший разряд числа лежит в нулевой ячейке вектора, следующий — в первой, и так далее. Дальше нужно выбрать систему счисления: в каждой ячейке вектора содержатся цифры числа, то есть , где — основание системы счисления, которое я буду обозначать буквой .
Какую выбрать систему счисления? Если я, например, хочу хранить цифры в , первая идея — выбрать . У этого способа есть плюсы и минусы. Плюс: код будет работать максимально эффективно. Минус: с ним столкнулись ребята, которые писали на питоне. Python хранит числа в двоичной системе, а ввод и вывод у него десятичный, поэтому их нужно постоянно переводить — и кто-то умный этот перевод реализовал за квадрат. Итак: плюс — быстро, минус — надо переводить.
Какие ещё варианты, какую систему счисления выбрать? Какую степень десятки брать? Видимо, как раз влезает, но есть и вариант выбрать что-то поменьше. Когда вы говорите , вы предполагаете, что если потом эти числа предстоит умножать, то величина не переполнится — она влезает в , и мы сможем посчитать её в том же самом типе. Иногда выбирают систему счисления чуть-чуть меньше, чтобы не было проблем с переполнением: берут, например, . А когда мы будем писать длинную арифметику на основе быстрого преобразования Фурье, добавится ещё одна причина брать степень десятки поменьше: чтобы погрешность, которая набегает в вещественных числах, не оказалась слишком большой.
Давайте чуть-чуть поговорим про — один раз, а дальше везде буду считать, что система счисления — это просто степень десятки. Когда вы пишете на ассемблере — помните курс про ассемблер? — там есть замечательная операция сложения двух чисел. Когда вы складываете длинные числа, вы обычно складываете в столбик: сперва складываете первые цифры, может быть, произошёл перенос; если произошёл, его надо не забыть прибавить, когда складываете две следующие цифры. Так вот, в ассемблере есть операция «сложить два числа с учётом переноса от предыдущего сложения». Перенос там не нужно держать ни отдельным флагом, ни отдельной фичей — это базовая инструкция процессора, одна такая. Соответственно, сложение двух чисел в системе счисления — это ровно один такт на разряд, причём даже без учёта параллелизма. Поэтому её действительно очень любят.
Ускорение тут не «чуть-чуть». Казалось бы, система счисления поменялась незначительно: была степень десятки, стала , — а скорость работы изменилась в несколько раз за счёт того, что процессор под всё уже оптимизировал: if’а никакого нет. А в системе счисления — степени десятки будет лишний if и ещё лишнее прибавление потом. Писать в неудобно, потому что нужно постоянно переводить, так что мы с вами, простые люди, будем работать в системе счисления — степени десятки.
Итак, как писать простые операции? Сложение чисел — это один for, который прибавляет, а дальше нужно где-то делать перенос. Когда мы говорим про перенос, у нас всегда есть два варианта. Первый: попытаться запихнуть его в тот же цикл; тогда код, например, будет выглядеть так — если ячейка переполнилась, то из a[i] сразу вычесть B и увеличить следующий разряд.
// a += b
for (int i = 0; i < n; i++) {
    a[i] += b[i];
    if (a[i] >= B) { a[i] -= B; a[i + 1]++; }
}
Это у меня операция «плюс равно». Естественно, я могу сделать и операцию «плюс», просто создав копию . Вообще любая операция, которую я сейчас пишу, будет в форме «плюс равно», «минус равно», «умножить равно на короткое» — это те функции, которые работают за линейное время, просто потому что их так писать удобно: я одной функцией пишу как бы сразу две. Так вот, переносы можно делать в том же цикле, а можно делать в конце. С точки зрения производительности почти всегда оптимально делать их сразу, если есть такая возможность. С точки зрения удобства написания кода, чтобы не думать лишний раз, удобно разделять эти две части: один цикл for делает операцию, другой цикл for занимается переносом.
Например, когда-то давно мы с вами изучали алгоритм Карацубы. Если у вас есть фанаты Карацубы, то в первую задачку контеста, где вам предстоит умножить два числа, Карацуба как раз отлично заходит. Карацуба — это такой алгоритм, который учит вас делать переносы в конце. Если вы пытаетесь делать переносы по ходу кода Карацубы, она перестаёт работать быстро, возникают всякие мелкие проблемы. В Фурье у нас будет то же самое. Везде, где можно думать без переноса, я считаю, что переносы делаются в конце, и мы как-нибудь их потом сделаем.
Главное — не забыть подумать про максимальный размер числа в ячейке. Например, если я складываю числа, то максимальное значение, которое окажется записано в одной ячейке, — это . А если я делал умножение без переноса, какое максимальное значение одного разряда будет?
— .
— Неточный ответ. Очень сильно неточный ответ. — это результат произведения двух цифр, но у вас же в одном разряде стоит сумма нескольких произведений: в каждом столбике вы умножаете много раз. Давайте обычное умножение:
for (int i = 0; i < n; i++)
    for (int j = 0; j < m; j++)
        c[i + j] += a[i] * b[j];
В одной ячейке у вас складывается сразу таких произведений по , поэтому в одной ячейке будет . Соответственно, если вы умножаете числа с помощью Карацубы, которая переносит всё в конец, вы должны позаботиться о том, чтобы эта величина влезала в ваш элементарный тип. И тут система счисления нам уже не подойдёт. Можно запариться и делать переносы по ходу Карацубы; если запариваться не хотим, учитываем ещё , и оказывается, что для обычной Карацубы, которую мы пытались написать, основание можно брать только . Поясню ещё раз эту мысль про : неважно, как именно работала Карацуба, — в конце результат получается без переноса, и в конце там точно будет .
Я написал один for для сложения, но кое-что забыл: ++ для следующего разряда. Надо делать a[i+1]++, это правда, не надо это бросать. Следующая операция — вычитание. Чтобы не писать for на доске каждый раз с нуля, я как бы скопировал код в новое место и исправляю уже там: a[i] -= b[i], а перенос, если значение стало меньше нуля, нужно, наоборот, прибавлять.
// a -= b
for (int i = 0; i < n; i++) {
    a[i] -= b[i];
    if (a[i] < 0) { a[i] += B; a[i + 1]--; }
}
Давайте напишем ещё что-нибудь — умножение на короткое число, операцию «умножить на ». Умножаем на и, если нужно, в конце переносим. Кстати, с вычитанием у меня тут была опечатка: условие должно быть именно «меньше нуля», а не «меньше »; вот тогда и нужно делать перенос. Теперь я умножил на каждую цифру, и если результат больше либо равен основанию, то нужно делать перенос. Этот if почти никогда не срабатывает, казалось бы, — тем не менее мой опыт говорит, что он позволяет выиграть несколько процентов, поэтому я его на всякий случай пишу. Перенос здесь уже приходится делать с использованием деления: значение надо будет взять по модулю, поэтому сперва я делаю перенос вперёд — a[i+1] += a[i] / B, — а потом a[i] %= B.
// a *= k
for (int i = 0; i < n; i++) {
    a[i] *= k;
    if (a[i] >= B) { a[i + 1] += a[i] / B; a[i] %= B; }
}
Если вы пишете на приличном языке программирования, у которого нормально работает оптимизатор, например на C++, то, естественно, деление и взятие по модулю превращаются в одну процессорную операцию — «поделить с остатком». На языке ассемблера деление и остаток делаются одной операцией сразу, вам об этом думать не надо, оптимизатор всё за вас сделает.
И давайте ещё какую-нибудь отвратительную операцию — деление на короткое. Кто сейчас может сходу сообразить, как делить на короткое число, скажем, на три?
— Бинпоиск.
— Бинпоиск по ответу — вообще хорошая тема применительно к делению: если вы умеете умножать, но не умеете делить, делаем бинпоиск по ответу, и на коротеньких числах это как-то работает. Это правда. К сожалению, если у нас число длины , то есть оно порядка , то логарифм этого числа, за который будет работать бинпоиск по ответу, — это примерно . То есть у бинпоиска появился квадрат: деление стоило бы .
Надо делать цикл в другом порядке. Вот здесь я старался делать переносы в конце, а деление на короткое — это первый раз, когда перенос не получится отделить от самой операции, придётся переносить по ходу. Будем действовать как при умножении, но делить. Перед тем как поделить на , мне нужно отдать то, что не поделилось, то есть остаток, в предыдущий разряд. Поэтому я пишу: к a[i-1] прибавить остаток, а остаток — это a[i] % k, причём при переносе в предыдущий разряд он умножается на основание системы счисления.
// a /= k
for (int i = n - 1; i >= 0; i--) {
    a[i - 1] += (a[i] % k) * B;
    a[i] /= k;
}
Элементарные операции, сравнение алгоритмов умножения и интерполяция
Простые операции на этом закончились. Отдельно иногда выделяют ещё две элементарные операции: битовый сдвиг на один вправо и битовый сдвиг на один влево. Сдвиг — это деление на два, сдвиг — умножение на два. Почему выделяют именно эти две операции? Потому что бинарная арифметика — это вот такой набор элементарных операций: . Через них можно выразить всё остальное, что нам желательно иметь.
Что такое «всё остальное»? Во-первых, через эти операции можно выразить умножение. Правда, работать оно будет за квадрат, зато у вас получится простой короткий код; впрочем, умножение вы и так обычно умеете написать за квадрат, так что это не очень интересно. Во-вторых, можно выразить деление. Кто писал деление длинных чисел, знает, что через бинарные операции получается заметно более простой код, — и это уже важно. Подробно мы его обсуждать не будем, кому интересно — есть в конспекте. В-третьих, можно получить даже длинный gcd: для наибольшего общего делителя длинных чисел можно писать специальное умножение и взятие по модулю, а можно сказать, что gcd в BigInteger тоже выражается через эти простые бинарные операции. Если мы выражаем всё через деление и умножение на два, то все три операции работают за , где — битовая длина числа. Про элементарную длинную арифметику, видимо, всё.
— Можно вопрос? Почему при делении ты добавляешь остаток к разряду с номером на единицу меньше, а эти слагаемые взяты по модулю и умножены на ?
— Потому что я в любой момент могу взять и сделать такой перенос, от этого смысл числа не поменяется. Число — это на самом деле сумма , а массив устроен соответственно. Поэтому в любой момент я могу сказать, что старший разряд целиком переехал в более младший. Когда я делил на короткое, почти вся часть поделилась нацело, а какая-то часть не поделилась; я взял ту часть, которая сейчас не поделилась, и сказал, что поделю её потом. Давайте пример: делю число на , старшие цифры в привычной манере пишу слева. Семёрку делю на три, получаю два, остаётся единица — она переезжает в следующий разряд, и теперь я делю на , получаю шесть. Итого — всё так же, как мы делали руками.
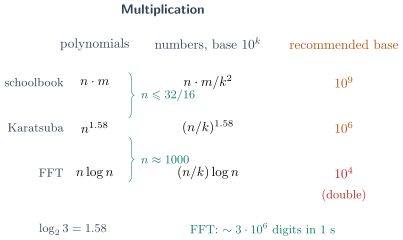
Теперь про быстрое умножение. До того как мы начнём делать БПФ, давайте поймём, что у нас уже есть. Есть многочлены и есть числа, и любой алгоритм, который мы знаем, работает и для многочленов, и для чисел, но есть нюанс. Если мы берём базовое умножение за квадрат, то для многочленов он работает ровно за произведение длин многочленов, ровно за столько операций. Если мы говорим про числа, мы ещё выбираем систему счисления: числа нам обычно дают, например, в десятичной системе, и длину мы, как у строк, тоже измеряем в десятичной системе. Поэтому, если — это длины чисел в десятичной записи, а систему счисления мы выберем (или вообще какая-то маленькая константа в -й степени: ), то на самом деле всё работает в раз быстрее. Поэтому не забывайте выбирать систему счисления настолько большую, насколько можете.
Аналогично с Карацубой; для неё я уже не буду писать , а напишу просто от . Напомню, за какую степень работает Карацуба?
— .
— В каждой группе должен быть человек, который помнит константы. Давайте освежим. Число ?
— .
— Число ?
— .
— Отлично. Золотое сечение?
— .
— Неплохо. Логарифм трёх по основанию два?
— .
Вот за столько Карацуба работает для многочленов — , и за для чисел с максимально возможной выбранной системой счисления. Сейчас мы научимся делать то же самое за время , а для чисел — за . Получается такая таблица: квадратичное умножение — для многочленов и для чисел в базе ; Карацуба — и ; БПФ — и . Это к чему? К тому, что, несмотря на то что преобразование Фурье мы будем изучать для многочленов, оптимизация «выбрать большую систему счисления» для Фурье тоже работает.
Для умножения за квадрат систему счисления можно брать хоть — большое . Для Карацубы, как мы только что обсудили, если мы пишем её удобным образом, лучше взять систему счисления поменьше, порядка . Для Фурье, если мы используем стандартный тип — а естественно использовать стандартный тип, потому что всё, что вы делаете с типом , процессор делает быстро, — нам, к сожалению, понадобится система счисления примерно , иначе накопится слишком большая погрешность.
Второе, о чём хочу сказать, — сравнение двух последних строчек таблицы. Карацуба сильно дольше, но на самом деле в Карацубе, если очень маленькое, мы дёргаем умножение за квадрат: правильно написанная Карацуба естественно содержит такую оптимизацию — если уже не больше 16 или 32, то квадрат будет работать не хуже, а скорее всего даже лучше. То же самое с Фурье и Карацубой: на не слишком длинных числах Карацуба выигрывает, потому что, во-первых, показатель степени не сильно больше единицы, а во-вторых, в Фурье будут операции с комплексными числами. То есть в одном случае умножений комплексных чисел, а в другом — умножений целых чисел со взятием по модулю. Какая из констант быстрее, нужно тестировать уже на конкретной архитектуре. Я когда-то считал, что примерно до выгодно пускать Карацубу, но это должен быть результат эксперимента на конкретной архитектуре.
Теперь, собственно, пусть нам дали длинные числа и мы хотим умножать их очень быстро. Вообще Карацуба тоже неплохо справляется: если числа длины до 100 тысяч, то в правильной системе счисления Карацуба работает почти мгновенно. БПФ же позволит умножать за секунду числа длины порядка 3 000 000 — это пример, чтобы вы понимали порядок.
Перейдём к общей идее БПФ. Было ли у вас преобразование Фурье?
— Только формула.
— Хорошо. Тогда про интерполяцию. Что вы уже знаете про интерполяцию?
— Например, что интерполяционный многочлен существует и единственный.
— Да. Если у меня есть точки и значения в этих точках , которые я хочу получить, то существует единственный многочлен такой, что , то есть у него ровно коэффициентов, и . Если бы степень была равна , коэффициентов было бы уже . Интерполяцию вы умеете делать с какого-то времени: есть формула Лагранжа, есть метод Ньютона. Вопрос в том, за сколько это работает, если мы попытаемся действительно провести вычисление. Есть небольшая разница между тем, когда вы пишете формулу от руки на бумажке, и тем, когда компьютер запускает алгоритм. Единственное, на чём нам нужно зафиксироваться: Лагранж или Ньютон — что вам ближе после курса математики? Мне тогда ближе Ньютон. Будем делать по Ньютону.
Метод Ньютона — это метод по индукции. Пусть по индукции мы уже решили задачу для первых точек; давайте добавим последнюю точку. Для предыдущих значений у нас всё точно совпадает, и чтобы в них ничего не испортилось, я добавляю такую вещь: . Я уверен, что значения в первых точках это не испортит. Умножить это нужно на что-то, чтобы подогнать значение в точке . Многочлен по первым точкам обозначим , а произведение из скобочки обозначим . Оба они имеют какие-то значения в точке , и мы хотим, чтобы выполнялось линейное уравнение , где — искомый коэффициент. Отсюда , и именно с таким коэффициентом я домножаю скобку.
За сколько это всё работает? Очередной шаг — это, во-первых, умножение на ещё одну скобку; умножение на такую короткую скобку работает за линейное время . Ещё нужно посчитать значения в точке, а подстановка — это тоже линейное время. Посчитали значение, посчитали значение, умножили — это один шаг; шагов всего , итого . За столько у вас сейчас работает интерполяция. Если бы вы всё делали по Лагранжу, получили бы тот же самый квадрат.
Теперь в чём суть быстрого преобразования Фурье? В совершенно определённых точках, красивых, мы сейчас сумеем проинтерполировать за время . Общая схема преобразования Фурье такая. Мы просто хотим умножить два числа, а начинаем делать странные вещи: сперва мы считаем значения и значения в каких-то красивых точках. Эти точки давайте уже начнём обозначать . Зная значения многочленов и в точках , мы можем узнать значения произведения в этих же точках. Как?
— Значения перемножаются.
— Верно. Получили здесь массив , здесь массив — это преобразования Фурье и — и за линейное время посчитали их поточечное произведение. Схема целиком:
fA = FFT(A)
fB = FFT(B)
for i: fAB[i] = fA[i] * fB[i]
AB = FFT^{-1}(fAB)
Я, видимо, вас обманул: интерполяция — это не первая стрелочка, первая стрелочка — это вычисление значений в точках, а вот последняя стрелочка — обратное преобразование, и она как раз интерполяция. Именно вычисление значений в точках называют прямым преобразованием Фурье, а обратную стрелочку — обратным преобразованием Фурье. Поскольку прямое и обратное преобразования Фурье — это один и тот же код, запущенный с разными параметрами, наша цель сейчас — научиться делать одно преобразование и понять, почему второе то же самое. Будем учиться вычислять значения в точках.
Какие точки, строго? Точки комплексные, равные корням из единицы: -я точка — это корень из единицы нужной нам степени. Напоминаю, как комплексные корни из единицы выглядят на картинке; здесь я нарисовал все корни из единицы степени восемь. Нам нужно число, которое в восьмой степени даёт единицу: длина этого числа должна быть ровно единицей, чтобы и длина в восьмой степени была единицей, а угол должен быть , умноженный на какую-то константу, и эта константа у меня меняется от 0 до 7. Корни из единицы обладают замечательным свойством: они образуют группу по умножению, циклическую и очень просто устроенную. Есть базовый корень, обозначим его , а любой другой корень — это просто . Я специально не использую букву для индексов, потому что сегодня она зарезервирована под мнимую единицу; потом вернётся в обиход.
Вот в таких точках мы и собираемся считать значения. БПФ — это алгоритм «разделяй и властвуй», мы делим пополам. Поделить пополам не получится, если взять не степенью двойки: на каком-то шаге нужно будет делить пополам нечётное число, и это вызовет неразрешимую проблему. Поэтому скажем, что длина каждого из многочленов и равна степени двойки. Я собираюсь их перемножить и получить многочлен произведения, а длина произведения — это сумма длин. Соответственно, обратному БПФ нужно, чтобы точки были те же самые, а было не меньше суммы длин. Поэтому я выбираю любую степень двойки .
Что такое сумма длин? В математике любят слово «степень», но со степенью постоянно нужно делать плюс-минус единичку. У меня есть массив коэффициентов, у него есть длина, и длина многочлена — это . Вот из-за этих плюс-минус единичек я и не люблю работать со степенями — есть длина массива. Кстати, на доске у меня в этом месте опечатка: под вторым слагаемым написано , а должно быть . Все многочлены в C++ хранятся просто массивом.
И, собственно, как же мы это сделаем? Смотрите, фокус. Всё предыдущее было подготовкой, а теперь единственный фокус, в котором и заключается преобразование Фурье. Если я хочу посчитать значения многочлена в точках, я записываю его в следующем виде: . Здесь я просто сгруппировал все чётные степени — это — и все нечётные, вынеся из них , — это . Это я сделал за линейное время: разбил массив коэффициентов на два массива коэффициентов — чётные степени и нечётные степени.
А потом — два рекурсивных вызова. Чтобы посчитать значения многочлена в точках , мне нужно посчитать в этих точках значения многочленов и . Если рекурсия вернула эти значения, я циклом пробегаюсь по точкам и в каждой говорю, что , где , — потому что , то есть квадрат -го корня — это ровно -й корень. А дальше в чём фокус? Фокус в том, что от возведения в квадрат корней стало в два раза меньше: у меня было величин , а разных квадратов очень мало — , порядок падает .
Давайте убедимся в этом на картинке. Возьмём корни четвёртой степени — их четыре: . После того как я все корни возвёл в квадрат, они перешли в корни второй степени — логично, что квадраты корней четвёртой степени являются корнями второй степени, и осталось только и . Действительно: , , и тоже. Так что четыре корня четвёртой степени при возведении в квадрат дают всего два значения — .
Алгоритм преобразования Фурье на идейном уровне уже закончился. Дальше мы будем долго заниматься реализацией: сперва чтобы она была корректной, потом чтобы её оптимизировать. А идея закончилась здесь: распилили на два массива, сделали два рекурсивных вызова и, делая их, заметили, что теперь считаем значения только в интересных точках, а не в . Вопросы какие-нибудь?
— А база в этой рекурсии какая?
— Давайте поговорим про базу. Кстати, я тут по индукции поддерживал замечательное свойство: количество точек , то есть точек, совпадает с длиной многочлена. Плохо, что коэффициенты я тоже назвал той же буквой — можно перепутать, поэтому скажу, что коэффициенты — это . Так вот, длина многочлена поделилась пополам и количество точек поделилось пополам, соответственно, в базе рекурсии у меня есть многочлен длины 1, который я хочу посчитать в одной точке. Многочлен длины 1 — это только свободный член, так что я возвращаю его коэффициент:
if (N == 1) return a_0;— это значение многочлена в точке , которая равна единице. Да и вообще в любой точке многочлен длины 1 даст значение .
Корни из единицы, предподсчёт и рекурсивное БПФ
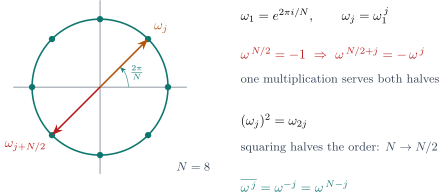
Давайте сделаем рекурсивную реализацию. Нам ещё нужно уметь быстро предпосчитать корни всех степеней двойки. Сейчас я буду писать код целиком, а начинается он с предподсчёта — поэтому сперва общие слова про предподсчёт корней. Есть два способа: правильный и неправильный.
Неправильный способ — вычислять корни по цепочке умножений: когда я в цикле считаю значение , получать из предыдущего корня. Или делать то же самое на этапе предподсчёта. Соблазн понятен: все наши корни имеют вид , то есть следующий корень — это предыдущий, умноженный на главный корень . Так делать, к сожалению, нельзя, если вы не хотите словить проблемы с погрешностью. Причём они будут прямо хардкорные: даже для системы счисления с основанием вы, скорее всего, уже получите неверный ответ, может быть, и для на очень длинных числах. Слишком много умножений — и всё схлопывается по погрешности в неправильный ответ.
Как правильно? Правильно вспомнить, что экспонента считается через косинус и синус, и честно завести массив всех корней — это самый простой способ. В массиве корней лежат комплексные числа, а комплексное число — это пара, поэтому я пишу фигурную скобку:
Root[j] = { cos(2 * PI / N * j), sin(2 * PI / N * j) };Обратите внимание: внутри косинуса и синуса мнимой единицы нет — она относилась к записи . Я предлагаю посчитать сейчас один массив корней, используя начальное значение . Само при рекурсии будет убывать, делиться пополам, а предподсчитанный массив я построю один раз — для самого мелкого корня. Извините, я забыл домножить на внутри косинуса и синуса; теперь формула верная.
Если я посчитал длинный массив корней, а мне нужны корни порядка , то я буду ходить по этому массиву шагом : нулевая ячейка, вторая, четвёртая и так далее. Если мне нужны корни порядка , я буду ходить шагом . То есть если сейчас длина массива маленькая, например , то я знаю исходную длину массива, который сделал в предподсчёте, знаю текущую длину, знаю, корень какого порядка мне нужен, — и значит, знаю, с каким шагом идти по массиву. Видимо, с шагом . Соответственно, к -му корню я обращаюсь так:
root[j * N / n]Вот это и будет нужного порядка.
Это не самый оптимальный способ. Обратите внимание: несмотря на то, что весь алгоритм работает за , а предподсчёт — за линейное время, вызовы косинуса и синуса влияют на полное время работы. То, что я раз вызываю косинус и синус, конечно, не замедлит программу в два раза, но процентов на тридцать — ощутимо замедлит. Можно быстрее. Если бы я все корни вычислял через умножение на первый, это было бы заметно быстрее, но создавало бы кучу погрешности. Оптимальный предподсчёт корней делается как в дереве отрезков — снизу вверх, удвоением.
— Серёж, а можешь ещё раз тезисно, что произошло? Мы ввели этот массив корней и…
У меня была математическая формула. Математическую формулу нельзя запрограммировать напрямую, потому что в коде нет этих значков. Я только что сказал, что вместо я буду подставлять вот такую штуку. Что это такое? У меня есть один посчитанный массив корней порядка ; когда мне понадобится корень порядка , — а всегда получается из делением пополам, в рекурсии всегда пополам, — я вот так к нему обращусь. Я посмотрел, что нужно идти с некоторым шагом, и понял, что в общем случае шаг именно такой.
Теперь про оптимальность вычислений. Более оптимальный способ выглядит так. На контесте, честно говоря, не помню, как было; я планирую, что везде будет заходить и этот способ, но не проверял. Более быстрый способ говорит, что корни с номерами и мы будем получать из -го корня. Соответственно, косинус и синус я вызову только один раз — когда посчитаю . Для краткости массив корней будем обозначать буквой . Оказывается, что
r[2 * j]     = r[j] * r[j];
r[2 * j + 1] = r[2 * j] * r[1];
то есть , а . Несмотря на то, что здесь тоже много умножений, глубина цепочек умножений уже не , а всего . Поэтому на практике погрешность оказывается удовлетворительной. В первом варианте, когда длина цепочки умножений была , напоминаю, под угрозой была даже точность в маленькой системе счисления; здесь же я теряю примерно полразряда. То есть, скажем, работало для — теперь работает для , что-то такое.
Переходим собственно к Фурье. Пишем код FFT. Я получаю вектор и должен вернуть его преобразование Фурье — ещё один вектор. Длина вектора — это как раз степень двойки, , и эту степень я буду обозначать . В некоторых реализациях люди любят таскать за собой; мне оно, вроде бы, нигде не нужно, поэтому я не буду. Итак, я сохраню из вектора — я знаю его size.
Теперь мне нужно разбить на два кусочка, и . Я пробегаюсь по индексам и в зависимости от чётности записываю элемент либо в , либо в . Через push_back, кажется, можно, да? То есть — это вектор нечётных, — вектор чётных. Получил два вектора.
for (int i = 0; i < n; i++)
    (i & 1 ? a1 : a0).push_back(a[i]);
Что дальше? Собственно, рекурсивные вызовы: длины этих векторов в два раза меньше, поэтому от я могу вызвать себя, и от я тоже могу вызвать себя. Теперь надо из двух ответов получить то, что я верну. Пусть — вектор из нулей; в него я и буду записывать ответы. Пишем по формуле — на всякий случай выпишу её в рамочке. Буква у меня занята вектором коэффициентов, поэтому многочлен обозначу большой буквой:
Вот это та формула, которую я хочу использовать в цикле for. В неё я хочу подставить . Причём многочлен считался только от квадратов, поэтому если здесь я беру -й корень, то туда мне нужно взять -й квадрат. Поэтому — это просто плюс корень , умноженный на . Это единственное место, где я использую , и сюда я его и поставлю — к предподсчитанному массиву надо обратиться. Беру из предподсчитанного массива нужное мне значение: я хочу -й корень, но иду с большим шагом, потому что текущее уже отличается от исходного .
В этом коде есть сейчас ровно одна ошибка. Я не учёл, что квадраты пробегают цикл два раза. Если корни, когда я их рисую на круге, бегут вот так, то квадраты бегут с вдвое большим шагом — а значит, проходят круг два раза. Поэтому при обращении к массивам нужно не забывать брать по модулю длины меньшего массива. Длину меньшего массива можно было бы обозначить , и , но давайте без штрихов — не будем вводить лишние обозначения, просто напишу «пополам». И модуль нужно применить к обоим индексам:
vector<comp> fa(n);
for (int j = 0; j < n; j++)
    fa[j] = fa0[j % (n / 2)] + root[j * N / n] * fa1[j % (n / 2)];
return fa;
Вопросы по идее, по коду, по предподсчёту?
— Серёж, можешь ещё раз пояснить, когда мы обращаемся к половинкам, которые так же посчитали, к чётным и нечётным, почему там по модулю?
Потому что там я считал от всех квадратов. Соответственно, первому корню отсюда соответствует первый квадрат, второму — второй квадрат. Если сейчас , я хочу посчитаться в точках , то в рекурсивном вызове я сосчитаю не от этих четырёх точек, а только от точек — от точек и . Дальше: точке соответствует квадрат , точке — квадрат , точке — снова квадрат , точке — снова . При возведении в квадрат остаются только и . Ещё что-нибудь?
Нужно ещё сказать про базу. Когда мы писали код, я до этого отвечал на этот вопрос, но по ходу мы забыли: если длина равна единице — вот здесь, когда мы узнаём длину, — то я, естественно, возвращаю просто , поскольку . Это про то, что на нижнем уровне рекурсии всё просто.
if (n == 1) return a0;Эта версия Фурье считается просто — это простая версия, которой никто никогда не пользуется, потому что она бесконечно долго работает. Асимптотика, конечно, , но нам надо, чтобы она работала ещё раз в десять быстрее. Хотя, ладно, она не прямо плохая: если выберем хорошую систему счисления, она вполне норм. Хуже было бы, если бы вот тут вы написали прямо косинус и синус — тогда был бы честный 100% TL. Или если бы пытались вычислять корни -го порядка вместо обращения к предподсчитанному массиву. Как только мы ввели предподсчёт, мы решили почти все проблемы; осталось дорешать остальные.
Переходим к хорошей реализации Фурье. Вообще, сейчас это чем-то похоже на merge sort. Классическая схема «разделяй и властвуй»: взяли две половинки, сделали от них рекурсивный вызов, по двум половинкам собрали результат. А merge sort можно было написать нерекурсивно.
— Помните, как нерекурсивно писать merge sort?
— Снизу вверх.
Да, снизу вверх. Давайте, перед тем как переходить к новому алгоритму, я нарисую картинку для merge sort. Она выглядит вот так — это дерево merge sort. Давайте нарисую подробнее, там ещё отдельные элементы были: изначально у нас массив вот в таком состоянии. Как делать нерекурсивно? Подниматься вверх по слоям и говорить, что мы идём шагом степени двойки: вот здесь пойдём шагом , вот здесь шагом и так далее, — и будем вызывать merge половин. Идём шагом , вызываем merge половин; идём шагом , вызываем merge половин.
Фурье — то же самое. Смотрите, вот у нас написан merge половин — вот он. Давайте идти снизу вверх и делать то же самое, что в merge sort. Видите: половинка , половинка , и я могу записать результат слияния на то же самое место. Нюанс только один: merge sort, когда спускался вниз, не переставлял элементы — он просто спускался, а всё интересное происходило потом. А здесь я, когда спускаюсь вниз, хитро переставляю коэффициенты: сперва идут чётные коэффициенты, потом нечётные.
Я сейчас оптимизирую код принципиально, потому что вот этот кусочек кода, который переставляет коэффициенты, тоже работает за . Пока спускался — выполнял перестановки на каждом уровне; а теперь я чуть подумаю, пойму, в каком порядке их нужно расставить, и сразу поставлю их за линейное время в правильном порядке. Сперва идут чётные, потом нечётные. Обычно как идут числа? Обычно сперва идут те, у которых старший разряд — ноль, а потом те, у которых старший разряд — один. А у нас сейчас сперва идут числа, у которых младший разряд — ноль, а потом те, у которых младший разряд — один. Значит, нужно записать числа в порядке обратной битовой записи.
Пусть — исходный массив, и я не буду его трогать. Мне дали массив; я — функция FFT, и не принято портить входные данные, которые мне кто-то дал: вдруг они ценные. Я буду создавать массив . Сперва я запишу в то, что лежит на самом нижнем уровне, а потом несколько раз вызову цикл for, который мержит половинки. Изначально в по индексу «перевёрнутая битовая запись числа » я запишу значение :
fa[rev(i)] = a[i];— А что такое ещё раз?
— это обратная битовая запись числа . У меня сейчас есть все числа от нуля до некоторой степени двойки.
— «Обратная» — это в смысле «меньше»?
Нет, в смысле «реверс строки». Реверс строки. Я хочу сперва поставить числа, у которых младший бит — ноль, на те места, где они стояли в исходном массиве. Нет, получается неочевидно; давайте я произнесу так, чтобы было прямо очевидно. Что такое обратная битовая запись числа? Видимо, начинать нужно вот так.
Естественно, — это перестановка порядка два: если применю её два раза, ничего не поменяется. Поэтому неважно, пишу я тут или там — код будет работать одинаково. Но по смыслу того, как я сейчас объясняю, надо написать вот здесь:
fa[i] = a[rev(i)];Итак, что стоит на -й позиции? На -й позиции стоит то число, у которого младший бит такой, как у старший, следующий бит такой, как у следующий сверху, и так далее. То есть я перевернул битовую запись и посмотрел, какое же встало на эту позицию.
Как всё-таки посчитать массив ? Мы это уже делали, когда проходили динамику по подмножествам в первом семестре: считается динамикой. Нужно сперва перевернуть все биты, кроме первого, а все биты кроме первого — это . Давайте на картинке попробуем понять, что такое «все биты кроме первого» и как они переворачиваются. Вот число, вот все биты кроме первого. Казалось бы, беда — но они как раз перевернутся, всё прекрасно, и автоматически встанут на нужные позиции. Если тут был порядок , то в результате переворота я как раз получу… или нет? Или да? Сейчас.
Нет, я пытался вас обмануть. Не ровно то же самое: в числе всегда ровно бит. Если я возьму и начну переворачивать, то из-за сдвига к числу дописался нолик, и после переворота этот нолик как раз встанет на первую позицию — вот этот нолик я лучше буду обозначать звёздочкой. Итого результат переворота: фиктивный нолик встанет на младшую позицию, а дальше пойдут уже все биты и так далее до конца числа. Поэтому мне нужно результат переворота числа ещё поделить пополам — сдвинуть вот в эту сторону. А потом нужно ручками взять младший бит числа и поставить его на старшую позицию. Я так и делаю: беру , сдвигаю его, и добавляю младший бит на место старшего:
rev[i] = rev[i / 2] / 2 + ((i & 1) << (k - 1));здесь пробегает все значения из .
Нерекурсивное БПФ: бабочка и битреверс
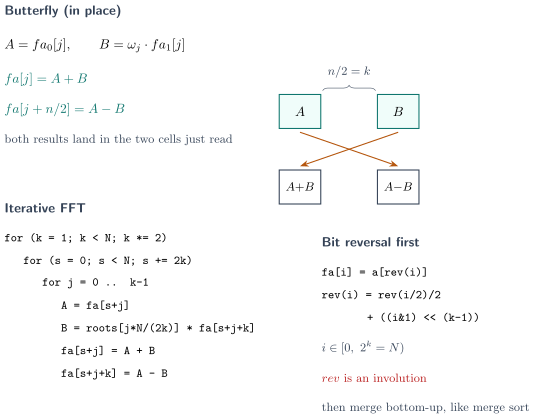
Этот предподсчёт я делал один раз заранее — тогда же, когда вычислял корень. При каждом умножении я его повторять не буду. Спуск вниз закончен, теперь надо писать подъёмы. Давайте я их напишу, потому что там тоже есть что заоптимизировать — ровно в два раза.
Я перепишу цикл for, который у меня сейчас есть. Я буду вести его по от нуля не до , а — внимание — до включительно, то есть до . Я сделаю только половину работы и напишу
fa[j] = fa0[j] + w[j] * fa1[j];то есть . Корень я здесь пишу для понятности: формулу мы один раз выписали, второй раз переписывать её лень.
Что будет происходить, когда я пойду во вторую половину? Раньше цикл шёл от нуля до , а теперь посмотрим на значения от до . В том коде индекс брался как раз по модулю , поэтому в обращениях к массивам и ничего не поменяется. Поменяется только корень. Чем корень с номером отличается от -го корня?
— Как из корня быстро получить корень ?
— Они почти равны, но со знаком минус.
Да. Нарисуем картинку. Вот корни, которые шли до номера , а вот следующие корни. Каждый из них как раз получается из предыдущей половины: вот нулевой корень и вот корень номер , вот первый корень и вот корень номер . Каждый раз это тот же корень с минусом.
Это было геометрическое объяснение, а можно понять то же самое и алгебраически. По определению , а внезапно равно : если взять корень -й степени из единицы и возвести его в степень , получится ровно . Итого .
Если бы я сейчас написал второй цикл for, мне нужно было бы сделать в нём всё то же самое, только произведение взять со знаком минус. Вывод: я могу делать в два раза меньше умножений комплексных чисел. Я могу прямо в том же самом цикле for дописать строчку . Давайте обозначим те половинки, которые я уже посчитал: , . Я как раз ввёл специальные переменные, сохранил в , сохранил в — и теперь просто пишу и :
for (int j = 0; j < n / 2; j++) {
    A = fa0[j];
    B = w[j] * fa1[j];
    fa[j]         = A + B;
    fa[j + n / 2] = A - B;
}
У меня уменьшилось число обращений к памяти и уменьшилось число умножений.
Осталось сказать, кто такие массивы , и . Вы можете писать как-то иначе, но по смыслу надо записать в fa, fa0 и fa1 указатели на правильные куски массива. Вы же можете пользоваться не только векторами, а прямо указателями — это C++-ный трюк. Тогда fa — указатель вот сюда, туда же, куда указывает fa0; fa0 — указатель на первую половину, fa1 — на вторую.
И здесь есть ещё приятный момент. Смотрите: когда я работаю с -й ячейкой, данные я беру из -й и из -й ячейки — это как раз и . И результат я записываю в те же самые ячейки. Поэтому мне не нужно каждый раз создавать новый массив fa. Как это делается в merge sort: взяли две половинки, результат слияния — абсолютно новый массив. Здесь я тоже планировал начать так делать: и — две половинки, результат слияния — новый массив, который потом скопирую на место. Но я могу сделать преобразование прямо в том же самом месте — просто потому что на картинке увидел, что ячейки как раз совпадают.
Пишем код. Сперва перебираем степень двойки, для которой у меня уже всё посчитано: перебираем , пока , и каждый раз умножаем на два. Моя цель — взять два кусочка длины и смержить их в кусочек длины . Дальше я перебираю начало кусочка: перебираю с шагом , естественно, пока оно не вылезет за пределы массива.
— А может, в первом цикле for ты имел в виду k++?
— Нет, именно . Можно было выбрать показатель степени двойки, а можно саму длину — у меня это именно длина блока, степень двойки. Я хочу пользоваться таким , поэтому в условии пишу .
Теперь вношу самый главный цикл. Сейчас у меня два кусочка длины — рисую картинку — мержатся в один кусочек длины . Внутренний цикл for будет идти именно до : я перебираю все элементы одного из кусочков, от нуля до включительно. И дальше я пишу четыре строчки кода: , и две записи в массив.
for (int k = 1; k < N; k *= 2)
    for (int s = 0; s < N; s += 2 * k)
        for (int j = 0; j < k; j++) {
            A = fa[s + j];
            B = roots[j * N / (2 * k)] * fa[s + j + k];
            fa[s + j]     = A + B;
            fa[s + j + k] = A - B;
        }
Чему равно ? Это элемент массива . Чему равно ? Это нужный корень, умноженный на элемент второй половины. Корень я копирую из массива roots: беру — видите, делить надо именно на , потому что когда я мержу два кусочка длины в кусочек длины , я хочу брать корни порядка . Умножить это надо на . И оставшиеся две строчки: я беру две ячейки, первая — , вторая — , и пишу в них и .
Здесь важная поправка: в двух местах я по инерции написал , а должно быть — спасибо. Сейчас поправлю оба места. И да, правильно заметить, что в этих обозначениях , а значит . Просто где-то в предыдущей жизни у меня числа не было, а в цикле for я почему-то решил его использовать.
Это называется быстрое нерекурсивное преобразование Фурье. На него можно навешивать ещё какие-то небольшие оптимизации, но всю принципиальную работу мы уже сделали. Давайте перечислим, что произошло. Первое: я сразу написал код с предпосчитанными корнями — корни заранее предпосчитал, разменивая память на время. Второе: мы избавились от той части работы объёмом , которую делали на этапе рекурсивного спуска, сказав, что у нас есть перевёрнутые биты (битреверс) и элементы исходного массива изначально расставлены в правильном порядке. Третье: когда я мержу кусочки, мне не нужен специальный новый массив, чтобы копировать туда результат. Раньше и были отдельными массивами, и потом я создавал новый массив и записывал результат в него. Теперь я делаю преобразование прямо в том же самом месте: беру два элемента, вот это , вот это , и крест-накрест меняю их друг с другом.
— Серёжа, можешь ещё раз про индексацию , почему она такая?
— Начиная с позиции в массиве сейчас лежат подряд два массива, которые в предыдущей жизни назывались у нас и . Соответственно, если я хочу обратиться к , я обращаюсь к . Аналогично с : к началу надо добавить длину первой половины, и поскольку половина — это , получается .
Теперь вы хранители тайного знания о том, как писать Фурье нормально. У вас будет возможность это применить. Советую сперва попробовать написать рекурсивно: там всё идёт по формуле — видим одну формулу, применяем её, и сразу работает. Нерекурсивная версия — это результат нескольких заходов размышлений, и в ней есть ровно два места, где легко ошибиться, несмотря на то что получается красиво и коротко. Если вы хотите уметь это самостоятельно, лучше начинать с рекурсивной версии. Специально для этого на Codeforces есть задачка, и там заходит почти всё что угодно — ну, как «всё что угодно»: надо всё-таки помнить про константу и подсчитывать.
Давайте поговорим о тематике. За семестр мы не прошли две темы: одна называется теория чисел, вторая — архиваторы. Содержание лекции про архиваторы: это Хаффман; это арифметическое кодирование, то есть Хаффман с нецелыми длинами кодов; это LZSS и алгоритмы, как написать его за линейное время, с некоторыми техническими подробностями, как написать правильно. И это BWT — преобразование Барроуза–Уилера — плюс MTF (move-to-front) плюс RLE, то преобразование, которое обычно делают до Хаффмана. Мы двумя способами научимся получать такой же хороший результат, как делают архиваторы RAR. И ещё поговорим про теорию информации.
— А вы в BWT уже поняли, как делать обратное преобразование?
— Нет, ещё не поняли.
А в теории чисел — дискретное логарифмирование, поиск первообразного корня. Вы знаете, что это такое? Вы, кстати, знали, как первообразный корень искать?
— Искать перебором.
Да, и ещё про то, где всё это нужно и как применять, например в длинной арифметике, при работе с первообразными корнями; дискретное логарифмирование, чуть-чуть про факторизацию — наверное, совсем чуть-чуть, и ещё что-то там было. Кажется, я уже рассказал про обратные числа и про решето — а тут будет немного подробнее, как считать всякие функции. Итак, есть выбор: архиваторы или теория чисел. Могу выбрать я, а можете сейчас проголосовать, кто что хочет.
— Это за сегодня?
— Нет, сегодня мы это не будем. У нас сегодня предпоследняя лекция, и вы получите домашку про Фурье. Следующая лекция будет последней, и домашки не предполагается: практика будет, а домашки через неделю не будет. Поэтому вы можете выбрать ту тему, которая вам интереснее. Семестр у нас на этом заканчивается. В принципе, если будет желание, можно в какой-нибудь день просто собраться онлайн и рассказать оставшуюся часть.
Я предлагал рассказать что-нибудь одно из двух: или архиваторы, или теорию чисел. По умолчанию у меня стояли архиваторы, так что если вы сейчас ничего не поменяете, то будет про архиваторы. Голосуем. Теория чисел: раз, два, три, четыре, пять, шесть, семь. Архиваторы: раз, два, три, четыре, пять, шесть, семь, восемь. Вам, конечно, надо было встать, чтобы я считал аккуратнее. Итого: архиваторы — восемь голосов, теория чисел — семь. Здорово. Меня, и не только меня, всегда удивляло, почему в некоторых странах с двухпартийными системами выборы каждый раз проходят прямо на грани, 45–50%. А у нас сейчас получилось точно так же, причём само по себе — я к такому не готовился.
Возвращаемся в мир FFT. Сегодня нам нужно доделать преобразование Фурье: мы ещё не знаем обратное преобразование и не знаем, как использовать FFT именно для умножения чисел. Казалось бы, всё уже есть: есть чёрный ящик FFT, есть схема — сперва применить прямое преобразование, потом поточечно умножить, потом применить обратное, и всё. Но вы же видите, что FFT работает с комплексными числами, а многочлены, которые вы хотите умножать, обычно с вещественными, даже с целыми коэффициентами. Нельзя ли это как-то подхачить — поиспользовать то, что исходные коэффициенты вещественные, а преобразование мы делаем от комплексных чисел? Ответ, конечно, да, можно.
Если наши исходные многочлены — это и , то я могу получить два преобразования Фурье за одно. Я беру FFT от массива , где : из двух вещественных чисел очень естественно сделать одно комплексное. Сделали, запустили FFT от массива — и теперь нужно сделать расщепление, то есть расщепить результат на и . Это универсальный приём, его можно применять не только в умножении двух чисел.
Как расщепить? Когда я начинаю думать про формулу, у меня что-то в фоновом режиме напрягается, но на самом деле расщепление — это просто одна формула; давайте разберёмся, что в ней происходит. Если бы у меня было просто комплексное число, то я бы взял сопряжённое к нему, чтобы получить действительную часть: . Вот так вообще достаётся вещественная часть. Значит, мне нужно научиться делать сопряжение — но не самого , а внутри: у меня от таких коэффициентов уже посчитано что-то сложное, и сопрягать я хочу как бы под преобразованием.
Начнём с простого. Если у меня есть -й корень, то чему равно его сопряжение?
— Умножить на минус один?
— Нет-нет-нет, а что такое сопряжение? Давайте нарисуем на картинке. Сопряжение — это явно не умножение на минус один: умножение на минус один — это поворот на , а сопряжение — это отражение относительно вещественной оси. Вот -й корень, а вот сопряжённый к нему. Какой это корень?
— Можно сказать, что -й.
— Да, а можно коротко написать : естественно, я всё понимаю по модулю , так что это и есть .
Теперь подумаем про свойства сопряжения. Если я сопрягаю произведение двух чисел, я утверждаю, что это то же самое, что сперва сопрячь каждое, а потом умножить: . По сути сопряжение — это умножение угла на минус один, а при умножении комплексных чисел углы просто складываются. Поэтому я могу сперва сложить углы, а потом умножить результат на минус один, а могу сперва умножить оба угла на минус один, а потом сложить — получится одно и то же. Про сложение можно сказать то же самое: сопряжение суммы — это сумма сопряжений, .
И этого мне, наверное, хватит для счастья. Потому что что такое преобразование Фурье? Это подстановка корней в многочлен, то есть сплошные умножения и сложения. Сопрягать сам корень я уже умею, а умножения и сложения у меня теперь тоже под контролем.
Обратное преобразование и итоговая схема умножения
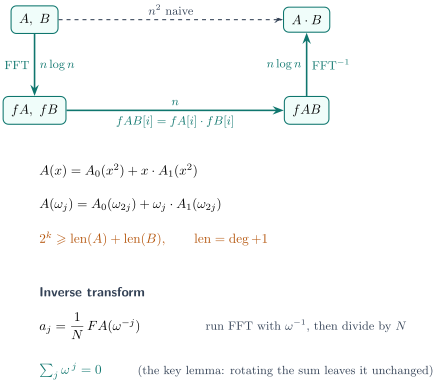
Сопряжение можно вынести за все умножения и все сложения — именно на этом держится трюк. Посмотрим, что у нас есть. Есть многочлен , составленный из двух множителей: , где и — многочлены с вещественными коэффициентами. Есть посчитанные значения: , а . Моя задача — из посчитанных значений вытащить и . Если кто-то уже видит, как это сделать, можете меня ускорять.
Если бы у меня было сопряжение , всё было бы очень просто. И ведь оно у меня есть: я могу взять конкретное посчитанное комплексное число и просто его сопрячь — гениально, никакого дополнительного преобразования Фурье для этого не нужно. Давайте расписывать, чему это сопряжение равно. Поскольку в комплексных числах и сложение, и умножение можно вынести за сопряжение, получается
Здесь я воспользовался тем, что мои конкретные и — вещественные: сопряжение их коэффициентов ничего не делает, оно только сопрягает аргумент, то есть переводит в . А сопряжение мнимой единицы — это минус , отсюда и минус перед вторым слагаемым.
Если я хочу, чтобы здесь был не минус, а плюс, нужно брать сопряжение в точке . Итого получаются такие формулы для коэффициентов прямого преобразования Фурье многочленов и :
Индекс я ставлю под сопряжение, чтобы после сопряжения там оказался как раз нужный мне . В первой формуле мнимые части сократились, и осталась вещественная. Во второй, наоборот, сократилась вещественная, а мнимая осталась с коэффициентом , поэтому строго математически там стоит не , а . Но делить на не нужно: можно поделить пополам и взять мнимую часть числа. Поэтому в реализуемой форме я пишу так: здесь беру вещественную часть, а здесь — просто мнимую. У стандартных комплексных чисел всё это, естественно, есть: real и imag.
Кстати, про стандартные комплексные числа. Когда вы в прошлые годы писали свои комплексные числа вместо std::complex, программа начинала работать процентов на десять быстрее. Я до сих пор не знаю, за счёт чего, но чуть-чуть ускориться так можно. Казалось бы, как можно неправильно написать комплексные числа? Умножение, деление, вещественная часть, мнимая часть — как ни пиши, всегда получится одинаково. А вот пишешь сам — получается на десять процентов быстрее. Если когда-нибудь узнаете почему, расскажите мне, мне это очень интересно.
Вопрос: во сколько раз последняя оптимизация позволила ускорить итоговый алгоритм умножения двух длинных чисел и через Фурье? В полтора раза. Изначально у нас было три преобразования Фурье: два прямых сверху и одно обратное. Теперь — одно прямое и одно обратное, то есть два вместо трёх. Ускорение в полтора раза.
Переходим к обратному FFT, и начнём с реализации. Пусть у нас есть функция FFT. Я умею применять её к исходному массиву — получается прямое преобразование Фурье. Чтобы получить обратно, достаточно написать
a = FFT(fa);и потом сделать ещё две вещи. Первая — пореверсить всё, кроме нулевого элемента: reverse(a + 1, a + N). Этот плюс один означает, что нулевой элемент я оставляю на своей позиции. Вторая — не забыть поделить весь массив на константу: a /= N. Что константа равна именно , мы поймём по ходу доказательства. Итого функция одна, и прямой ход, и обратный.
Есть и другая реализация, которая работает чуть иначе. Она говорит, что можно пользоваться практически одной и той же функцией, но с параметром: , а потом . Тогда нужно запускать функцию либо в точке и её степенях — и так далее, — либо в точке и её степенях: . Деление на при этом остаётся, а реверс уходит. Но этот /= N всё равно придётся дописывать после вызова FFT, то есть какой-то код снаружи остаётся в любом случае. Чтобы упростить себе код функции FFT и предподсчёт, я обычно на этот параметр забиваю и делаю реверс.
Давайте сперва поймём, почему реверс в точности эквивалентен вычислению в точке . Что у меня записано в ячейках до реверса? Значение в точке , значение в точке , значение в точке и так далее. После реверса в первой ячейке оказывается значение в точке . А мы знаем, что . Одной строчкой reverse я добился того, что в массиве теперь записаны значения многочлена в степенях .
Доказательство. Что у нас есть? У нас есть такие суммы:
Здесь — мой коэффициент, а — это -й корень, возведённый в степень ; сам -й корень получается из исходного возведением в степень . Давайте распишу эти суммы подлиннее, чтобы с ними было проще общаться, — получится вот такая табличка:
В первой строке я подставляю , во второй — , в третьей — . Надеюсь, на трёх строчках уже понятно, что я делаю. Я знаю массив и хочу узнать массив .
Как найти , как вы думаете? Обратите внимание: присутствует в каждой сумме. Например, — это просто сумма всех коэффициентов; про остальные строки так сказать уже нельзя, там у коэффициентов стоят разные степени корня. Я предлагаю вам сейчас мысленно сложить все строчки, складывая их по столбцам. Сумма первого столбца — это, очевидно, : в первом столбце везде написано . Сумма второго столбца — это , умноженное на сумму всех , и эта сумма оказывается равна нулю. Сумма следующего столбца — это , умноженное на сумму степеней с шагом два; поскольку — корень -й степени, здесь суммируются корни степени .
Сформулируем лемму: . Доказывали вы когда-нибудь такое? Геометрически. Доказательств много, а я хотел повторить уже известное вам, так что давайте геометрическое. Можно было бы сказать, что для каждого слагаемого найдётся противоположное ему, и слагаемые соберутся по парам, — но это точно правда только для чётных , хорошая ремарка. Поэтому произнесу геометрическое доказательство иначе. Если повернуть весь этот круг на , то есть на угол , то множество слагаемых перейдёт в себя. Значит, ответ — это какое-то комплексное число, которое не меняется от поворота на некоторый угол. Я знаю только одно такое число — это ноль. Множество слагаемых не поменялось от поворота, значит, и сумма не поменялась, значит, это число — ноль.
Единственное исключение — на какой угол поворачивать нельзя, чтобы доказательство осталось корректным. Нельзя поворачивать на нулевой угол; если поворачиваем на любой ненулевой, доказательство имеет смысл. Поэтому с первым столбцом так и выходит: угол, на который там нужно поворачивать, — это , то есть угол нулевой, и при повороте число остаётся собой. Для остальных столбцов углы поворота — , и так далее; все эти числа не единицы, угол не нулевой, поэтому все суммы зануляются.
Итак, мы научились получать : это просто сумма всех , поделённая на большое . Как теперь получить ? Я хочу привести мои строки примерно к такому же виду, чтобы у везде коэффициент был единицей. Для этого я умножу на , — на , — на и так далее, целиком всю сумму. Тогда в столбце, соответствующем , получится , а остальные столбцы по той же лемме занулятся.
Давайте теперь внимательно посмотрим на ту величину, которую я при этом посчитал. Чтобы вернуть , я взял на какую-то степень , на какую-то степень и так далее — а это ровно значение многочлена с коэффициентами в точке . Проверим гипотезу, что это и правда похоже на подстановку в многочлен. Чтобы получить , мне нужно домножить строки на и так далее, то есть я подставляю в многочлен точку .
Сделаю вывод:
где — многочлен с коэффициентами . И эту величину можно посчитать двумя способами: либо чуть подкостылить функцию FFT внутри, либо в конце взять и перевернуть результат.
— Вопросы по обратному преобразованию? А где у нас само перемножение? Где перемножение многочленов?
Да, оно потерялось. С произведением многочленов у нас никогда не было проблем, поэтому мы им особо и не занимались. Схема состоит из трёх кусочков: из получить , потом перемножить значения, потом сделать обратное преобразование. Зная значения двух многочленов и в точке, значение произведения получаем так: берём значения в одной и той же точке и перемножаем. Запишу на всякий случай:
Поэтому в каждой точке мы тратим одну операцию.
— В формуле, где мы выражаем : как получается, что такое и почему умножается на ? Рассуждения, которые были рядом, я понял, а как обобщить их до общей формулы — нет.
Вот эта степень — это на самом деле произведение номера строки на номер столбца. Я заметил, что когда я первый столбец делаю единичным, мне нужно домножать на в степени «номер строки». Для следующего столбца нужно домножать на в степени «номер строки, умноженный на два», а это то же самое, что подставить в многочлен с коэффициентами точку . Что-то у меня непонятно получается — давайте попробуем по-другому: меньше конкретных чисел, больше общих формул. Расписываю прямо:
То есть я сложил все суммы в строках с какими-то коэффициентами. На картинке мы разобрали случаи , , . На какие коэффициенты нужно домножать суммы в строках в общем случае? В общем случае нужно домножать на минус те степени, которые стоят в этом столбце, а в столбце стоят ровно . Вот вся матрица: её -я ячейка — это , где — номер столбца, а — номер строки. Я просто говорил всё это без общего индекса, потому что так обычно легче воспринимается, поэтому общий индекс нигде и не писал. Так вот, имеет вот такой коэффициент; я хочу, чтобы этот коэффициент стал единицей, и домножаю вот на такой. Сперва я увидел, что хочу ровно вот эту сумму, никакую другую, а потом обратил внимание, что эта сумма с точностью до множителя есть значение многочлена вот в такой точке.
— В чём тогда победа FFT над альтернативами, если у нас всё в итоге тоже свелось к перемножению двух многочленов, пусть и в преобразованном виде?
В том, что в преобразованном виде многочлены перемножаются за линейное время: в каждой точке я считаю значение за одну операцию. Вот эта стрелочка работает за , обратная стрелочка тоже за , а вот эта, средняя, — за . Профит в этом.
Давайте чуть-чуть поговорим про погрешности. Так же, как и метод Гаусса, всё это считается на вещественных числах, значит, погрешность точно будет. Никаких теоретических оценок, позволяющих сказать «вот это точно работает», я не знаю. Я знаю оценку, когда точно не работает, и эмпирический результат, когда работает. Итак, когда точно не работает? Мы уже знаем, что у произведения двух многочленов коэффициенты будут порядка , умноженного на квадрат основания системы счисления. Соответственно, эта величина должна быть не больше того, что вмещает используемый вами тип: double держит примерно –, long double — примерно –.
Это теоретическая оценка. Если вы выбрали систему счисления так, что даже это неравенство не выполнено, то вы точно получили переполнение — вам не хватит значащих знаков. Эмпирически мы видим — просто запускаем решение на разных тестах, — что если взять чуть-чуть меньше, буквально на треть разряда меньше, то точности уже хватает. То есть этими формулами можно пользоваться как основой для выбора системы счисления. Если система счисления не подошла и вы поймали WA, можно потом взять основание поменьше: .
Теперь вы готовы писать FFT. Отдыхайте, всем приятного.