Четвёртое определение древесной глубины и кратчайшие расстояния через дерево исключений
Мы продолжаем разговор про наши замечательные параметры, и сегодня я хотел бы обсудить оставшиеся аспекты древесной глубины — из тех важных и очевидных, что у нас есть на данный момент. Пока видимость у нас очень ограниченная: мы не видим всех параметров сразу, и я стараюсь выдавать порциями то, что можно сказать про параметр прямо сейчас, локально. Постепенно будем всё усложнять, добавлять параметры и рассказывать про связи между ними. Когда-то у нас даже должен начать появляться обещанный граф параметров: для него была отсрочка из-за домашнего задания, где надо было восстанавливать связи между параметрами, и мы решили, что показывать его будет нехорошо. Теперь руки развязаны, так что потихоньку его подготовим.
Особенно хотелось уделить внимание древесной глубине как параметру в плане её полиномиальных применений. Не так много есть параметров, вокруг которых развили теорию, реально использующуюся на практике. Как оценивать, насколько параметр реально используется, насколько он релевантен и важен, не очень понятно — но тем не менее параметр заслуживает внимания к такому вопросу.
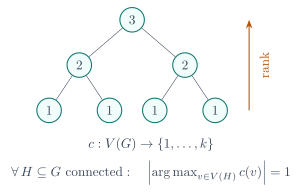
Давайте придумаем ещё какое-нибудь альтернативное определение древесной глубины. Это будет уже четвёртое определение: до этого было три — первое совсем обычное рекурсивное, второе через дерево исключений (elimination tree), третье про игру полицейских и грабителя. Четвёртое определение такое. Назовём раскраску вершин графа в цветов подходящей, если у любого связного подграфа вершина максимального ранга единственна. Цвета здесь важны именно как числа из множества , и по смыслу цвета — это ранги.
Тогда можно определить как минимальное число , при котором существует подходящая раскраска. Обратите внимание: такая раскраска напрямую не определялась как правильная, но на самом деле она обязана быть правильной. Несложно доказать это утверждение в качестве упражнения. По сути выбор вершины максимального ранга — это и есть выбор корня в дереве исключений для текущего подграфа: по такой раскраске легко строится elimination tree, а по elimination tree так же легко строится раскраска. Доказывать тут нужно только то, что в связном подграфе не бывает двух вершин одного максимального ранга, но это доказывается. Вопросы по такому определению есть? Размялись — отлично.
Давайте тогда попробуем ускорять алгоритмы поиска кратчайшего пути на заданном графе. Постановка такая: дан граф , и приходят запросы. Запросы простые: чему равно — длина кратчайшего -пути. Для простоты граф у нас неориентированный — ориентированных графов у нас пока особо и не было. Можно иметь неотрицательные веса на рёбрах. Тут можно задавать много вопросов про то, что происходит с отрицательными весами, но это мы зададим потом; давайте сначала поймём, как конструкция работает для неотрицательных весов. Для отрицательных многие алгоритмы на самом деле тоже работают, вопрос только в том, как именно.
Задача понятная: если вы по каким-то причинам разрабатываете альтернативный сервис поиска маршрутов на карте, вам, может быть, понадобится быстро отвечать на такие запросы. И оказывается, что дерево исключений даёт здесь суперпростую конструкцию. Сначала я расскажу очень простую конструкцию, которая мало что позволяет, а потом мы перейдём к конструкции более известной и поймём, от чего же мы стремились избавиться в первой.
Предложение. Возьмём некоторое дерево исключений высоты нашего графа — то же самое, что подходящая раскраска. Раскраска нам сейчас немножко поможет понять интуицию, что на самом деле происходит. У нас есть совершенно естественная иерархия на графе: вспоминаем, что в elimination tree при удалении вершины граф распадался на компоненты связности, и так далее. Я предложу сначала конструкцию, а потом мы поймём, почему она работает.
Конструкция будет такая: я буду насчитывать кратчайшие пути от вершины до всех её потомков в некотором графе. Если я взял elimination tree, то для вершины у меня определено не подмножество, а поддерево — поддерево elimination tree для вершины . Скажем, для корня мы знаем, что . Понятно, что такое . И теперь я предлагаю просто делать какой-то подсчёт внутри таких поддеревьев.
Во-первых, замечу, что в нормальном elimination tree множество связно в , то есть подграф связен. Единственный случай, когда мы не можем этого добиться, — когда исходный граф был несвязным, но тогда граф, понятно, можно разделить на независимые части. Откуда это понятно? У разумного elimination tree всегда так, потому что иначе я могу разбить его на две части и подвесить одну из них просто сюда.

Тогда определим граф, соответствующий вершинке в elimination tree: это как раз подграф, порождённый на этих вершинах, . То есть я взял, вырезал поддерево и посмотрел, что это была за штука в графе. И теперь внутри я насчитаю кратчайшие расстояния от вершины до вершины — и делать это я буду для всех . Я прямо беру свой подграф — вот как это всё выглядело в графе на картинке: вот был корень, при его удалении получилась вот такая история, и здесь тоже есть свой корень, вершинка . Внутри этого подграфа я считаю все кратчайшие расстояния. Если вы когда-нибудь работали с центроидной декомпозицией, для деревьев такое точно делалось и происходит очень часто; а теперь мы то же самое делаем внутри графа.
Понятна конструкция? За сколько я её считаю, товарищи? Давайте внутри одного графа. Понятно, что это просто задача single source shortest paths — путь от одной вершины до всех остальных внутри конкретного графа . Мы привыкли, что это работает за . Конечно, современными технологиями и прорывами эту штуку уже умеют делать как-то быстрее — правда, всё это получилось ещё до LLM. Но вообще мы больше привыкли к тому, что здесь стоит ещё и , количество рёбер внутри этой компоненты: . Это не так важно: каким-то алгоритмом мы это считаем, обычным алгоритмом Дейкстры.
Теперь я утверждаю, что с помощью этих величин я очень быстро могу считать кратчайшие расстояния между вершинами. К тому, что сказал Саша — сколько это в сумме по всему графу, — мы потом перейдём. А считать я теперь могу за ; точнее, не за , а за высоту этого дерева: высота у меня , так что считать я могу за .
Давайте посмотрим, как это выглядит на elimination tree. Если я возьму вот эти две вершины и рассмотрю между ними кратчайший путь в графе , то через какую вершину он обязательно будет проходить, как вы считаете? Через какую вершину мы точно знаем, что он пройдёт?
— Через наименьшего общего предка.

— Не факт, на самом деле. В дереве это действительно было бы так: если бы граф был настолько простым, что он дерево, то эту вершину конкретно определял бы наименьший общий предок. Но когда у нас уже более общая штука, у меня могли быть рёбра — ребро идти сюда и ребро идти вот сюда, мне никто этого не запрещал. И тогда кратчайший путь между ними выглядит вот так. То есть кратчайший путь обязательно содержит вершину большего ранга, чем они сами, и это будет обязательно одна из вот этих вершин.
Давайте вернёмся к нашей раскраске и напишем утверждение: любой путь от до проходит через одного из общих предков и . Утверждение формулируется для любого пути, не только для кратчайшего. Понятно? Отлично, давайте докажем.
Рассмотрим этот путь от до . Мы знаем, что на нём есть вершина наибольшего ранга, и, согласно нашему определению, эта вершина единственна. Пусть — вершина наибольшего ранга на пути. Это значит, что она самая высокая в дереве — это очевидно. Теперь нам хочется сказать, что — предок и, соответственно, предок . Есть ли у кого-то понимание, почему это так работает? Доказать это можно разными способами, и картинка тут скорее даёт больше интуиции, чем формальный аргумент. Прямого ребра из в нет, и прямого ребра из в тоже нет — в этом и суть.
Формальный аргумент всё-таки нужно провести, хотя по существу всё просто: множество предков и — это разрез между и , вот и всё. Рассмотрим и : вот будет их наименьший общий предок в дереве, какой-то наименьший общий предок, а вот будет корень. Фишка в том, что если я все эти вершины из графа удалю, то от до дойти никак нельзя вообще. Поэтому утверждение совершенно понятно.
Вырожденность и contraction hierarchies
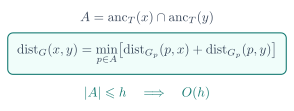
Множество общих предков отрезает от . Мы с вами знаем, что на момент этого удаления и лежат в разных компонентах связности. Понятно, что при удалении от графа отвалятся и ещё какие-то компоненты, но они нам не интересны. Поскольку — вершина максимального ранга, по построению получается, что путь целиком содержится в . Отсюда всё и следует: нам нужно просто сложить .
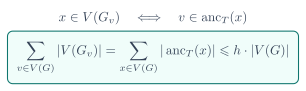
Итак, мы построили очень простой предподсчёт, который позволяет искать расстояние за — всё-таки общего предка перебрать придётся, мы ведь не знаем заранее, какой из них подойдёт лучше всего. Но возникает вопрос: за сколько всё это работает в сумме? Понятно, что суммарный размер графов предподсчёта не будет очень большим. Просуммируем количество вершин внутри всех этих подграфов. Каждая вершина участвует только в подграфах своих предков, поэтому у каждой вершины не больше вхождений в эту сумму, и мы получаем оценку .
Но тут есть вопрос: а как, собственно, оценить количество рёбер в этих подграфах? Количество вершин мы оценили, а количество рёбер — нет. С рёбрами есть очень простая, пусть и довольно грубая оценка — возможно, можно оценивать и сильнее, — и она связана с другим параметром.
— Скажите, друзья, пока есть какие-то вопросы? Нет?
Хорошо, у нас всё очень просто, мы уже размялись, можем идти бодрее. Стираем всё это.

Есть такой параметр, который называется вырожденность, по-английски degeneracy. В случае графов это не обзывательство. Параметр очень хороший, потому что он позволяет оценивать плотность графов, но при этом не очень интересный: маленькая вырожденность не гарантирует, что задача простая. Что же это такое? Граф называется -вырожденным, если его вершины можно упорядочить вот таким образом: граф у нас неориентированный, я выписываю вершины в ряд в порядке некоторой перестановки и ориентирую все рёбра слева направо. Я хочу, чтобы у каждой вершины было не больше рёбер направо. Это и называется -вырожденным графом. По сути, это то же самое, что сказать: я могу удалять из графа по одной вершине степени не больше , пока граф не исчезнет, — это ещё одно определение.
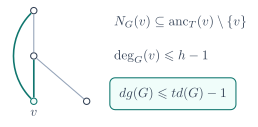
Вырожденность графа обозначается вот так: , при котором является -вырожденным. Вырожденность, конечно, ищется за полином: вы просто жадно берёте вершину минимальной степени и выкидываете её, и это работает. Древесная глубина всегда говорит нам, что в графе есть вершина степени не больше, чем древесная глубина минус один. Действительно, если вы возьмёте лист в вашем elimination tree, то его соседями могут быть только предки, и их не больше — больше просто быть не может. Поэтому мы знаем, что .

Чем же нам вырожденность помогает? Это очень простой параметр для оценки разреженности графа: число рёбер в графе не превосходит вырожденности, умноженной на число вершин, то есть . Здесь даже можно было бы поставить , и вообще оценку можно сделать ещё точнее, но нам хватит и простой формы, поэтому минус единицу я стираю. И отсюда следует, что рёбер в наших подграфах тоже будет не слишком много — в худшем случае порядка квадрата. То есть алгоритм будет работать достаточно быстро.
Но можно заметить, что вырожденность — не очень хороший параметр для нас, потому что мы ищем параметры, относительно которых задача начнёт решаться эффективно.
— Как вы думаете, начиная с какой вырожденности задача решается сложно?
— Два.
Да, два. Давайте разберёмся по порядку.
— Вырожденность ноль — это какой граф?
Из зала отвечают верно. Действительно, означает, что , то есть в нет рёбер. Если мы возьмём вырожденность один, это значит, что в графе всегда есть лист, то есть это лес (дерево, если граф связный). А когда вырожденность равна двум, это уже очень похоже на кубические графы: кубический граф — это граф, в котором степени всех вершин равны трём. Такие графы я плохо рисую сходу; простейший пример — , это кубический граф. И если из такого графа удалить одну вершину, его вырожденность будет уже равна двум, при условии что он был связным.
А на кубических графах у нас уже куча задач NP-трудна — например, гамильтонов путь. Из вырожденности два, разумеется, не следует, что граф кубический или субкубический, — такого вывода сделать нельзя. А вот в обратную сторону верно: если субкубический, то есть является подграфом кубического, и при этом связный, то . Так что многие задачи при степенях ровно три в графе уже не решаются. А когда максимальная степень в графе равна двум, это просто циклы или пути.
— Вопросы, друзья, по этой истории?
Но я вам обещал сказать, почему эта конструкция очень-очень нехорошая. Она очень простая, но очень нехорошая: она не позволяет почти ничего делать.
— Как вы думаете, почему эта конструкция нехорошая? Чего бы мы хотели от новой конструкции? Нет идей?
Согласен, странно задавать такой вопрос, когда ответ знаю только я, и догадаться, наверное, сложно. Ответ в том, что нам нужно обновление весов рёбер, а предложенная конструкция его не поддерживает. Возьмите очень простой elimination tree. Дерево с неглубоким elimination tree может быть очень широким — всё равно очень широким. Пусть у нас есть вот такая вершина, из которой выходит много-много длинных путей, и вот это ребро — прямо реально единственное ребро, соединяющее её со всем остальным. В предподсчёте у меня хранятся кратчайшие пути в эту вершину отовсюду. И если я поменяю вес этого ребра, а оно лежало вообще на любом пути отсюда вот сюда, то придётся менять все кратчайшие пути внутри этого графа. Нехорошо.
На самом деле нашу конструкцию можно было чуть ослабить: мы сделали её слишком сильной, считали слишком много, и поэтому ничего не получалось. И тут возникает штука, которая называется contraction hierarchies. Это прямо гуглится, про это есть нормальная статья в Википедии, там всё хорошо описано. Насколько я понимаю, изначально она не была связана с древесной глубиной, но так вышло, что древесная глубина очень-очень хорошо описывает эту конструкцию.
Идея в следующем: сокращать путь до такого короткого нам было не нужно. Что мы сделали? Мы взяли и превратили имевшийся -путь вообще в два ребра — назовём их сразу shortcut’ами, шорткатами. То есть я всегда знал: если я хочу соединить вот эти вершины между собой, у меня всегда найдётся один такой шорткат и один такой шорткат, и их сумма даст кратчайший путь. Но в асимптотике это сильно не помогало: нам всё равно нужно было искать ту самую вершину, то есть на запрос мы не добились. Давайте лучше применим другую идею: будем превращать путь в такой путь, который сначала поднимается по рангам, а потом опускается.
Понятно, что пока непонятно, что это значит. Сейчас объясню. Что мы вычисляли до этого? В том сценарии мы для каждой пары , где — предок , считали . Но этого получилось очень много, и, как оказалось, пересчитывать это очень сложно. Более того, если мы меняем рёбра между высокоранговыми вершинами, это влияет на расстояния между низкоранговыми, то есть на какие-то вычисления на низкоранговых вершинах.

Давайте поймём, откуда вообще берутся contraction hierarchies. Нарисуем наш путь — эта картинка, если что, с Википедии, её можно потом посмотреть отдельно. Откуда берутся стягивания? Стягивания берутся из того, что мы добавляем не все шорткаты. Шорткат — это когда я прямо посчитал какое-то кратчайшее расстояние в каком-то графе. А здесь мы будем строить шорткаты следующим образом: мы будем запрещать вот такие ямы. Вот это наш путь, а по вертикали отложен ранг вершины, то есть её положение внутри elimination tree: самый низкоранговый — это лист, повыше — что-то промежуточное, на самом верху лежит корень. Вот эта верхняя вершина — та самая, которая раньше была общим предком, который мы искали.

Нарисуем для примера вот такую историю: пусть здесь у меня был очень хороший участок. И дальше я буду итеративно делать следующее. Если у вершины оба её соседа — более высокоранговые вершины, я создам между ними новый шорткат. Его желательно рисовать другим цветом; вопрос, какой цвет тут вообще будет видно — кажется, что на зелёной доске видно только красный. Так и будем продолжать. Вот эта вершина из пути как бы стирается, то есть дальше мы смотрим только на путь из новых шорткатов. Следующая вершина, видите, тоже находится в яме — этот участок тоже надо сократить, добавляем вот такой шорткат. В результате у нас получился вот такой путь, и его мы сокращаем так: из двух новых шорткатов делаем третий шорткат. Теперь наш путь действительно сначала поднимается по рангам от листьев к корню, а потом спускается.

На elimination tree это выглядит довольно сложно, но примерно так: была вершина, у неё было два ребра — в одного предка и в другого предка, — и поэтому мы сделали вот такой шорткат, который состоит из этих двух рёбер. Дальше это всё начинает подниматься наверх. Суть в том, что теперь шорткаты появляются друг из друга: два шортката превращаются в третий, и так далее. Но фишка в том, что шорткат меняет только шорткаты выше, чем он сам. Если у меня был шорткат с низкоранговой вершиной, идущий в более высокоранговые вершины, то новый шорткат, который я создам, будет лежать строго выше, чем эти два, — он как бы будет их накрывать. Из-за этого граф пересчёта у меня оказывается достаточно ограниченным: если ребро меняется, оно меняет только то, что сверху. Вот примерно такая история. Думаю, что contraction hierarchies я расскажу только на этом уровне, потому что…
Вычисление параметров: точно, перебором или приближённо
Не хочу убивать на это очень много времени: штука довольно сложная для осознания. Но идея понятная. Получилось, что теперь любой наш путь — это путь, который сначала поднимается по рангам, а потом опускается, потому что направления я выбрал именно так. Точнее говоря, у меня получается два склеенных пути, каждый из которых поднимается по рангам. Думаю, мы дадим какое-нибудь домашнее задание про contraction hierarchies — если кому интересно, как раз будет повод разобраться. Вопросы?
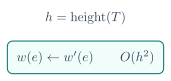
Итак, с такой системой, если её правильно построить, обновление одного ребра будет стоить , где — это как раз высота дерева исключений. Я, честно говоря, не знаю, как можно было эту конструкцию придумать: первая конструкция, где мы просто считаем расстояния для каждой пары , где — предок , кажется мне суперестественной, а вот эта — совсем нет. Пока я готовился к лекции, пришлось попотеть, хотя я это сам реализовывал — конечно, не один, а с командой, часть из которой присутствует здесь. Штука совсем неочевидная. Вот примерно такая история про применение древесной глубины, которую я знаю; наверное, это самое релевантное в плане практической части.
Конечно, встаёт вопрос: а к чему всё это можно применить, то есть каким графам это всё применяется? И самое главное — хорошо, я знаю, что если нашёл хорошее дерево исключений, то, наверное, смогу что-то быстро пересчитывать. Но как же эти хорошие деревья исключений вообще искать? Не все параметры одинаково хороши в том плане, что их надо уметь хорошо искать. Поэтому мы плавненько переходим к вычислению параметров — к теме, о которой мы пока говорили мало, потому что у нас было слишком мало параметров, а теперь параметров достаточно много.
Одна из центральных проблем всей нашей истории в том, что параметры у нас есть и их надо использовать, но чтобы их использовать, нам нужно знать значение самого параметра, а более того — нужно знать ещё и структуру, которую этот параметр задаёт. То есть чтобы параметр использовать, его нужно вычислить: и его, и структуру. Если вспомнить древесную глубину, то мы знаем, что у нас есть дерево исключений. Но пусть мы умеем вычислять древесную глубину как число — это нам никак не поможет. Хотя, если мы умеем быстро вычислять древесную глубину, можно сделать такой переборчик: перебирать, какую вершинку поставить в корень, вычислять древесную глубину образовавшихся подграфов и выбирать лучший корень, рекурсивно действуя дальше. Для этого нам нужно изобрести алгоритм, который для любого подграфа вычисляет древесную глубину в точности, — и тогда структуру восстановить получится. Фишка в том, что если нам кто-то просто дал граф и сказал: «его древесная глубина вот такая», — нам это ничего не даст, потому что никакие наши алгоритмы мы ускорить не сможем.
Поэтому так или иначе нужно задаться вопросом: а как же параметры вообще вычисляются? И тут нужно отталкиваться от того, какие алгоритмы мы разрабатываем. Вот в этом примере мы разрабатывали полиномиальные алгоритмы, практически даже линейные: если древесная глубина — константа, предподсчёт вообще линейный, никаких квадратичных зависимостей нет, ну только если рёбер было очень много, тогда будет . А какие у нас алгоритмы обычно? Давайте приведу пример: стандартный алгоритм работает за — это так называемый single-exponential. В перерыве мы достаточно подробно подискутировали по поводу того, что здесь бывает: в науке пытаются улучшать и константу в экспоненте, и уже даже полином . Скорее люди пытаются понять, какие тут есть границы: если мы хотим линейное время, насколько можно уменьшить зависимость от , и наоборот — насколько можно уменьшить эту зависимость, повышая полином. Это всё изучают и этим интересуются, но какого-то чёткого требования строго улучшать полином, конечно же, нет.
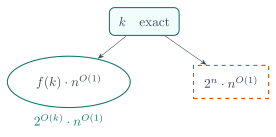
Собственно, речь о чём? Мы хотим использовать параметр. Например, чтобы использовать параметр «вершинное покрытие» (VC), это самое вершинное покрытие нужно найти. И вот мы хотим, чтобы алгоритм остался single-exponential, то есть наш параметр — это . Что для этого можно сделать? Во-первых, параметр можно вычислить точно — и, конечно же, вместе со структурой. Но поскольку большинство разумных параметров вычислять NP-трудно, обычно это делается за какое-то большое, неполиномиальное время: либо у нас какое-нибудь , если параметр нам это позволяет (а не все параметры позволяют), либо параметр можно вычислять вообще только полным перебором, за .
Конечно, нас больше интересует первая история. И даже более того: если параметр вычисляется тоже за single-exponential время, то вообще всё шикарно — мы за single-exponential время вычисляем параметр и потом за single-exponential время решаем нашу задачу. Всё супер. А вот что творится в другом случае: даже если это single-exponential, экспонента здесь может быть больше, чем там, хотя это бывает редко. А может быть и так, что single-exponential алгоритма у меня вообще нет, функция нехорошая, и тогда вычисление параметра, конечно, будет доминировать над решением задачи. Но такие вычисления нас, в принципе, не очень интересуют: не очень понятен сценарий, в котором нам нужно вычислить параметр суперточно. Возможно, только если вы много раз решаете одну и ту же задачу, граф потом не будет меняться, и вам сейчас очень важно вычислить этот параметр точно.
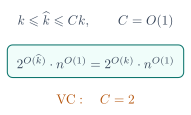
Замечу, что это, в принципе, был некоторый перебор, а такое нам нужно не всегда. Смотрите, например, на вершинное покрытие: его действительно можно вычислить за время, зависящее от , и, кажется, быстрее, чем полным перебором — там уже константа лучше, чем . Точное время я, честно говоря, не помню, но давайте напишу примерно . А что ещё мы знаем про вершинное покрытие? Все очень любят 2-приближение для вершинного покрытия. Как оно строится? Найдём максимальное паросочетание и возьмём все вершинки — концы рёбер паросочетания. Заметим, что вставить сюда 2-приближение — это просто ухудшит в два раза показатель степени, так что при прочих равных нам это может пригодиться.
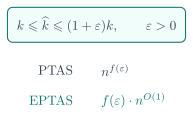
Поэтому второй способ — параметр можно аппроксимировать. Аппроксимаций есть очень много, и историй, как это делается, тоже. Самые сильные аппроксимации приближают с точностью для любого фиксированного . А что такое такое приближение? Мы находим какую-то структуру, которая не хуже, чем в раз: то есть здесь, грубо говоря, вместо будет . Самый лучший сценарий — когда это работает за ; бывает сценарий, когда у меня — я просто примеры напишу. Бывает просто constant-ratio, то есть -приближение только для какого-то конкретного , как в случае с вершинным покрытием.
Да, с вершинным покрытием мы знаем, что 2-приближение есть, — и если то, что недавно анонсировали, верно, то сделать лучше, чем 2-приближение, NP-трудно. Правда, для vertex cover, я думаю, уже доказано, что PTAS не бывает: вот такое — приближение с точностью за полиномиальное время для любого — называется polynomial-time approximation scheme. PTAS для него точно нет, потому что есть константа, для которой он не приближается; и, в общем, кажется, что тоже уже нельзя. А бывает, что приближение какое-то похуже — как мы делали для древесной глубины, то есть -приближение. Для древесной глубины мы с вами на прошлой лекции за полином научились строить -приближение: мы просто построили DFS-дерево и сказали, что это -приближение. И всё это, конечно, за полиномиальное время.
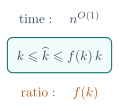
Хорошо, давайте что-нибудь из этого тогда построим — не буду голословить. Применим какие-то из этих вещей к конкретным параметрам: для вершинного покрытия мы вроде всё обсудили более-менее, давайте обсудим, как вычисляются ещё какие-то параметры. Сегодня у нас будет обсуждаться примерно три параметра, сейчас поймём какие. Первый набор параметров — это расстояния до каких-то классов графов, как vertex cover: у нас были расстояние до кластера, расстояние до клики. Давайте возьмём параметр «расстояние до кластера», distance to cluster.

Первое, что нужно в таких штуках, — посмотреть на сам класс; для каких классов графов это всё работает, я объясню потом. Посмотрим просто на кластерные графы. Напомню определение: граф является кластерным, когда любая его компонента связности — это полный граф. Равносильно: в нет порождённого . Что такое порождённый подграф? Это когда я оставил только какие-то вершины. Имеется в виду следующее: если я выберу любые три вершинки , я не получу граф, изоморфный пути на трёх вершинах, то есть . Это доказывается несложно, можете поупражняться.
Теперь, чтобы вычислить distance to cluster, что я просто должен сделать? Я должен удалить какие-то вершинки, чтобы в графе пропали все , чтобы никакого не осталось. Отсюда следует простая переформулировка: давайте выделим все тройки вершин, образующие . Тогда расстояние до кластера — это просто минимальное число вершин, которыми нужно проткнуть все . То есть теперь я ищу множество , пересекающее каждую тройку хотя бы один раз. Понятно такое?
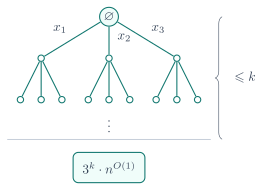
Отсюда сразу можно вывести алгоритм, который будет работать за FPT-время. Как его реализовать? Очень просто: строим полным перебором. Изначально ; если не протыкает некоторую тройку, переберу три варианта, что это за элемент. У меня получается дерево рекурсивного перебора: я начинаю с пустого множества , и у меня есть некоторая тройка, по которой я делаю ветвление — branching по-английски. Раньше любили это называть расщеплением; я против слова «расщепление», я не понимаю, откуда там расщепление, это ветвление, конечно.
Итак, в тройке три элемента: , или , и дальше перебор продолжается. Глубина у него будет не больше, чем : если вы ищете distance to cluster не больше, чем , то это дерево имеет высоту не больше, чем . То есть просто полный перебор, который обрубается на глубине . Так мы сможем вычислить наш distance to cluster за время . Конечно, я думаю, это не оптимальный алгоритм — но у нас в этом курсе нет задачи придумывать оптимальные алгоритмы, которые вычисляют параметры.

Супер, значит, мы получили. Но если вам не нравится и вам хотелось бы вычислять что-то за полином, можно построить 3-приближение. А каким образом его построить? Тут нужно просто сделать другое действие. Если не пересекает некоторую тройку, я же знаю, что я обязан содержать что-то из неё, — а давайте я возьму из неё всё целиком, все её элементы. Это не значит, что я одновременно беру все тройки: это просто такой алгоритм, который берёт произвольную ещё не проткнутую тройку и берёт все её элементы. Понятно, что все тройки, из которых я брал элементы, попарно не пересекаются.
Feedback vertex set и рандомизированный алгоритм
По построению все эти тройки не пересекаются. Из каждой я был обязан взять один элемент, а взял три — значит, это просто -приближение. То есть вот эта логика даёт мне , а вот эта — -приближение.
Замечу, товарищи, что на самом деле эта история работает для очень большого набора классов графов, которые задаются определённым образом. Называется это -free graphs, и это вообще отдельная история в структурной теории графов — изучать вот эти классы графов, то есть изучать конечное множество запрещённых графов . Кластерные графы — это у нас -free graphs. Например, пустой граф — это просто -free граф, потому что в нём нет ни одного ребра. Правда, обычно называют , потому что это полный граф на двух вершинах. Какие-то ещё простые примеры знакомых нам классов графов, которые так описываются, я вспомнить не могу.
Но суть в том, что класс графов описывается конечным — а иногда и бесконечным — множеством запрещённых подграфов. И когда это множество конечно, всё делается вот таким же образом: у нас есть запрещённые картинки, мы находим запрещённую картинку, перебираем, что из неё надо удалить, и удаляем. Поэтому схема очень общая: для всех таких параметров у нас есть эффективные вычисления. Вопросы? Хорошо, давайте пойдём к следующему параметру.
Следующий параметр у нас будет feedback vertex set. Наверное, зря я стираю эту доску — надеюсь, вы либо запоминаете, либо записываете. Кто помнит, что такое feedback vertex set?
— Расстояние до леса.
Здорово, действительно так: это distance to forest. Лес — это тоже -free граф, но тут уже бесконечное — это просто набор всех циклов. И, конечно же, мы не можем выделить все циклы в графе, потому что циклов в графе может быть экспоненциально много; точно не полином, если их длина не константная. Кроме того, у нас может быть так, что расстояние до леса маленькое, а циклы очень длинные — достаточно взять один большой-большой длинный цикл. Поэтому этот параметр так просто не даётся: чтобы его посчитать, нужны какие-то преобразования графа.
Что мы сделаем первым делом? Заметим, что произвольную вершину степени можно не удалять. Это не значит, что все вершины степени можно не удалять — это, конечно, неправда. Это значит, что если я возьму какую-то конкретную вершину степени , я могу сказать: существует ответ, который её не содержит, существует такое множество, которое её не содержит. Доказывается это очень легко. Какая у меня задача? Разрушить все циклы. И если эта вершина попала в ответ, то понятно, что любой цикл, в котором она лежит, содержит и её, и каждого из её двух соседей, — так что я могу с успехом поменять её на соседнюю вершину.
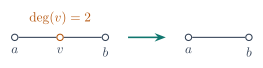
Поэтому можно сделать следующее: взять вершину степени и стянуть любое из двух инцидентных ей рёбер. Что такое стягивание ребра? Я просто склеиваю эти две вершинки, и больше ничего не меняется; в случае вершины степени это равносильно замене двух её рёбер на одно ребро между её соседями. Это наше преобразование графа, и мы знаем, что если мы найдём ответ в новом графе, то будет ответ и в исходном. Но пока совершенно непонятно, чем нам стало проще жить после того, как мы это сделали.
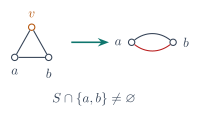
Тут ещё был некоторый неприятный крайний случай — случай треугольника. Треугольник — это отдельный цикл, который стянуть не получается: если мы просто стянем вершину степени , то останется одно ребро. Поэтому нужно разрешить иметь параллельные рёбра, и тогда всё становится понятно: если мы получили пару параллельных рёбер, это просто значит, что одну из двух её вершин надо удалять. Проще всего в этом случае разрешить параллельные рёбра; какого-то другого простого способа избавиться от треугольников я не знаю. Могут возникать и петли, но если петля возникла, мы точно знаем, что эту вершинку надо удалить.
Что мы теперь можем сказать про оставшийся граф? Мы знаем, что степень любой вершины хотя бы : . А отсюда мы можем посчитать, что рёбер в графе очень много. Сколько рёбер я знаю в графе , если минимальная степень равна , друзья?
— Три вторых.
Правильно, молодцы, сказали быстрее, чем я написал: . А в чём фишка? Фишка в том, что когда мы удалим искомое множество , то в оставшемся графе число рёбер обязано быть меньше числа вершин — ведь это лес. Согласны с таким? То есть когда я найду свой distance to forest, я точно знаю, что ; в частности, рёбер остаётся меньше, чем . Что отсюда получается? Что очень большая доля рёбер графа должна пропасть.
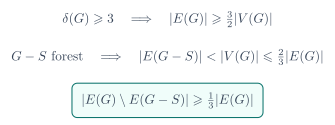
Давайте посчитаем, какая именно доля — правда, пара у нас поздняя, и считать мне уже сложно. Рассмотрим — множество исчезнувших рёбер. У нас должна пропасть целиком половинка от , а — это хотя бы треть от , правильно? Значит, . Оценка тут не лучшая, но кажется, что так. Что отсюда следует? Что если я возьму случайное ребро, то с вероятностью хотя бы этого ребра не будет в оставшемся графе. Согласны? Я ожидал, что там получится одна вторая, но у нас получилась одна треть.
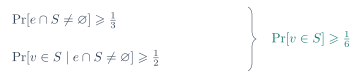
Что мы теперь делаем, товарищи? Мы просто берём случайное ребро, и с вероятностью хотя бы оно обязано из графа пропасть — а это значит, что какой-то его конец нужно удалить. Так давайте угадаем и конец, который нужно удалить: с вероятностью мы правильно угадали вершину ответа. Итак: угадаем ребро — это ОК с вероятностью ; угадаем конец ребра из — это ОК с вероятностью ; значит, всё вместе ОК с вероятностью . Оценил я очень грубо, кажется, можно оценить и лучше, но мы с вами не гонимся за константами в этом курсе — у нас приятное обсуждение идей.
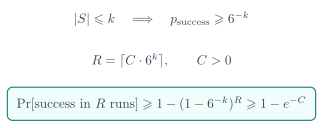
И если мы предполагали, что существует некоторое размера , то, повторив эту историю раз, мы получаем, что всё ОК с вероятностью . Согласны? А дальше просто повторим весь алгоритм: повторим раз, и будет ОК с вероятностью . Здесь, друзья, очень-очень грубо, потому что точно эти вещи я без выкладок быстро не воспроизведу. И обратите внимание: у меня должно было получиться число, стремящееся к единице при увеличении , — поэтому именно , а не . Вот так всё и есть, а как это доказывать, вы разберётесь.
Вот и наш могучий параметр — с вероятностным FPT-алгоритмом. А как построить приближение? По той же схеме, что мы делали раньше: давайте возьмём случайное ребро и возьмём оба его конца в ответ. Можно посчитать матожидание всей этой истории и убедиться, что получится нормальное приближение; рассказывать это я сейчас не буду, времени остаётся очень мало. Понятно, как делать приближение на основе вот этой идеи — угадываем ребро, но вместо того, чтобы брать один конец, берём оба?
— Да, можно, конечно, можно. Просто мы пытаемся простыми идеями получить простые алгоритмы.
Там много всяких историй есть. Есть параметризованные алгоритмы, которые работают намного лучше, и они будут не рандомизированные — ведь у нас получился вероятностный алгоритм. Приближённые алгоритмы тоже есть; для feedback vertex set они, по-моему, используют линейное программирование, и это как-то связано с базисом циклов. Правда, базис циклов, по-моему, больше работает для рёбер. В общем, надо думать.
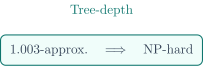
Хорошо, и наш любимый параметр — tree-depth. И тут самое интересное: оказалось, что здесь большая research-задача, не решённая до сих пор. Что про примерно известно? Известно, что -приближение NP-трудно, то есть очень близко приблизить NP-трудно — в частности, PTAS не существует. Но, по-моему, никаких других нижних оценок на приближение у нас нет. Есть какие-то разные полиномиальные приближения; я не буду их выписывать, я лучше расскажу, чего бы мы хотели.
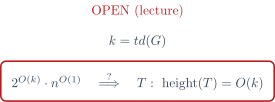
Чего мы на самом деле хотим добиться? Мы хотим добиться настоящей штуки. Мы с вами построили single-exponential алгоритм по — алгоритм, который работает за , то есть за экспоненту от на полином от размера инстанса. И для этого мы хотели бы, чтобы можно было вычислить примерно за такое же время. Причём даже не в точности вычислить: нам хотелось бы хотя бы следующего — за время вычислить дерево исключений (elimination tree) высоты . Согласитесь, это решило бы все наши проблемы: мы вычислили его не точно, но точно нам и не нужно было — мы хотели лишь сохранить single-exponential.
То есть мы хотели бы алгоритм, который представляет собой микс из приближённых алгоритмов и параметризованных. Это нормально, это называется FPT approximation algorithm: видите, люди, когда могут что-нибудь придумать, миксуют идеи вместе. И такой алгоритм реально оказался бы полезным. Но это открытая задача.
Резюмирую, что мы примерно знаем про . Точные оценки я не готовил, потому что считаю, что точные оценки без алгоритмов нам не очень полезны. Кажется, за poly время можно найти дерево исключений высоты — то есть приближение с множителем , где , так что сама высота получается порядка . И можно за время вычислить точно. Но это примеры; я не уверен, что это реально state of the art результаты — у меня, к сожалению, не было времени сравнивать их между собой, я скорее искал, знаем ли мы нужную нам штуку.
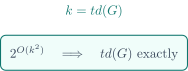
И такую штуку мы действительно не знаем. Вроде бы мы подобрались близко: есть какие-то приближения, что-то присутствует, — но мы далеко. Поэтому, когда мы говорим, что у нас есть single-exponential algorithm от , мы говорим это только при условии, что нам кто-то дал дерево исключений нормальной высоты. Вопросы какие-нибудь? На этом, наверное, у нас всё: дальше говорить я, пожалуй, уже не смогу, что-то устал. Но на вопросы с удовольствием поотвечаю, если они у вас есть.
Вычисление древесной глубины: открытая задача и план курса
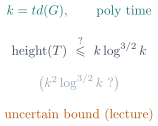
Давайте уточним первый пункт. За полиномиальное время можно найти elimination tree высоты не больше , где . Изначально я записал этот пункт как «можно получить -приближение», но правильнее говорить именно о дереве исключений такой высоты, поэтому хвост про приближение я стираю. Обратите внимание: три вторых здесь — это степень логарифма, , а не основание. И вот здесь я сомневаюсь: может быть, в показателе у была и двойка. Поэтому рядом я подписываю второй вариант — .
Я собирал эти оценки через специальных помощников, и они иногда выдавали мне разную информацию. В любом случае всё это гуглится в несколько запросов, точных оценок я здесь специально не добивался — цели такой у меня нет. Хороший вопрос, да: я сам это записал и не уверен. Мне кажется, что скорее верен второй вариант, с квадратом, но нужно отдельное исследование, чтобы установить, какой именно алгоритм у нас есть. Так что к числам на доске относитесь как к ориентиру, а не как к гарантированному state of the art.
Итоговая картина для вычисления древесной глубины такая. Приближение с коэффициентом уже NP-трудно. Есть однократно экспоненциальный по алгоритм со временем . За полиномиальное время мы умеем строить дерево исключений высоты (или — см. выше), а за время умеем вычислять точно. А вот то, что хотелось бы иметь как минимум, остаётся открытой задачей: за время построить дерево исключений высоты . Это не домашнее задание, а настоящий открытый вопрос — он так и остаётся на доске с восклицательным знаком.
Потом, когда мы будем изучать параметры посложнее, чем древесная глубина, — а начнём мы, думаю, уже со следующей лекции, — картина станет богаче. Первая треть курса на этом закончилась: сегодня была четвёртая лекция, и дальше начинается вторая треть, про самые сочные параметры. В серединке у нас будут всякие древесные ширины и прочее, прочее.