Древесная глубина: рекурсивное определение и дерево исключений
Я рад продолжить наш курс. Сегодня у нас третья лекция, и я подумал, что пора переходить к более интересным параметрам — но при этом всё ещё простым. Пока что мы успели разобрать только очень простые параметры, которые в основном заключаются в том, что мы удаляем вершины из графа, чтобы получилось что-то совсем простое, — так называемые distance to trivialities. С ними мы сколько-то поработали, и я более-менее считаю эту тему закрытой. Мы к ним, конечно, будем возвращаться и будем сравнивать их с новыми параметрами, но пора переходить к чему-то более серьёзному.
Начать мы хотим с так называемых параметров ширины, width parameters. Смотрите: это довольно неформальная штука, то есть что такое width parameter — сложно определить в каком-то общем виде, сложно сказать, когда параметр является параметром ширины. Если с distance to triviality всё довольно просто — вы просто задаёте класс графов, — то здесь не совсем понятно, что это значит. Поэтому мы будем потихоньку узнавать параметры, относящиеся к этой категории, и понимать, почему же они называются параметрами ширины. Думаю, со временем это станет нам понятно.
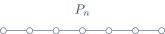
Один из простых классов графов, которые мы ещё совсем не рассмотрели, — это путь. Его же ещё называют бамбуком, а обозначается он обычно — путь, состоящий из вершин. Очень простой граф, и с ним можно делать вообще много чего. Структура пути нам на самом деле очень знакома, например, просто из всяких линейных алгоритмов на массивах: по факту массив — это и есть граф-путь, где вершины просто стоят друг за дружкой. Можно и так на это тоже смотреть. И сегодня у нас даже будут аналогии как раз со структурами данных на массивах: внезапно массивы могут обобщаться до произвольных графов. В каком-то роде это, конечно, не очень формальный аргумент, но тем не менее такую закономерность мы с вами увидим.
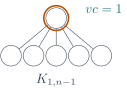
Ещё у нас был такой простой класс графов, как звезда. Понятно, что она обозначается , если я хочу вершин; её ещё иногда обозначают просто . Проверим: каким параметром из тех, что у нас уже были, звезда определяется проще всего? Их было немного. Чему равен vertex cover у звезды? Единице. Звезда — это в точности те графы, у которых vertex cover равен единице: любая вершина имеет соседей только в vertex cover. Правда, говорить тут нужно о связном графе — иначе могут добавиться ещё изолированные вершины, спасибо. Итак: если граф связный, то граф с vertex cover, равным единице, — это в точности звезда, .
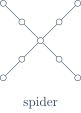
И фишка в том, что многие наши алгоритмы здесь ломаются; сейчас я попытаюсь объяснить, чего же мы хотим от ширины. Стоит нам чуть-чуть усложнить звезду — но везде, — и стоит нам усложнить путь — но везде, — как вдруг у нас всё перестаёт работать. Например, давайте я нарисую звезду немножко другую: такую, у которой будет по два отростка везде, а может, и по три отростка. Механизм vertex cover уже не сработает, потому что vertex cover сразу же вырос. Но при этом, согласитесь, локально звезда не сильно поменялась: граф всё так же выглядит очень просто — удали одну вершину, и появятся какие-то простые объекты, в данном случае пути из двух рёбер.
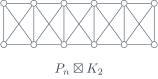
Точно так же можно усложнить и путь — например, сделать путь из пар вершин, то есть у меня будут просто пары вершин. Это как бы такой удвоенный путь, но на самом деле он выражается через произведение графов: это так называемый strong product, , — кажется, именно сильное произведение, это всё можно поискать. Я просто каждую вершину заменяю на ребро и соседние пары соединяю полностью. И все алгоритмы, да и параметры distance to triviality, будут здесь работать плохо: у такого графа никак не удалить сколько-то мало вершин, чтобы получился опять какой-то простой граф типа пути. Тем не менее вы согласитесь со мной, что этот граф простой — просто путь, у которого как бы увеличили ширину на два.
И вот эта интуиция — как раз то, чего мы хотим от ширины: граф по структуре глобально похож на путь или на звезду, но локально в нём что-то поменялось. И мы на пути к тому, чтобы потихонечку превращать всё это в параметры графов — такие, чтобы у подобных графов параметр не был очень большим.
Параметр, с которым мы столкнёмся сегодня, — это древесная глубина, так называемый treedepth. Относится ли он к параметрам ширины? Он называется древесной глубиной, но да, относится. Конкретно в нашем курсе я отношу его к параметрам ширины, потому что это, скажем так, очень ограниченный параметр ширины; почему это так, мы поймём потом, когда будем вводить более осмысленные параметры ширины. У нас всё получится.
Определений у древесной глубины достаточно много. И в каком-то смысле мы будем получать что-то похожее вот на это: пока можно ориентироваться на звезду, у которой удлинили пути. Глубина такой удлинённой звезды — это примерно и будет наша древесная глубина; по крайней мере у этого графа она будет чуть поменьше, мы с вами увидим. Чем ещё интересен treedepth: у него достаточно много разных интересных определений, и более того, вы с этим параметром уже встречались. Думаю, если вы проходили курс алгоритмов, вы так или иначе с ним сталкивались: по крайней мере вы делали правильную декомпозицию вот этого пути относительно древесной глубины. А если вы делали алгоритмы с деревьями посложнее, то тоже, наверное, встречались с treedepth.
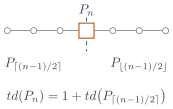
Давайте, собственно, описывать этот параметр. Интуиция у него такая: будем просто удалять из графа вершины и смотреть, на что он разваливается. Вот как, например, в пути: если я удалю середину, путь развалится на две части, и теперь эти две части становятся независимыми. И рекурсивно я могу делать в них то же самое. Давайте эту интуицию как-то определим. Я буду строить определение treedepth для графов общего вида, так что графы здесь получатся и несвязные.
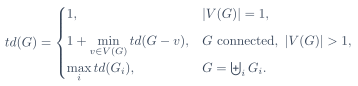
Итак, чему равна древесная глубина графа ? Она равна единице, если состоит из одной вершины: . Далее, для связного графа — то есть нам нужно найти лучший способ удалить одну вершину из графа: я беру лучшую вершину и удаляю её, а и означает просто удалить вершину. Кстати, можно было бы поставить ещё случай «если состоит из нуля вершин, то » — так было бы, наверное, лучше по индукции, но я уж как написал, так написал. И третий случай, который как раз и реализует нашу интуицию с компонентами связности, — это максимум: , где — компонента связности графа . В полном смысле компоненты связности внутри графа будут независимы.
Это первое определение древесной глубины. Дерева тут совсем нигде нет, но дерево получается очень естественным образом. Давайте попробуем построить elimination tree пути. Думаю, интуитивно понятно, что надо брать вершину, которая бьёт путь практически на два равных пути. Приведём пример. Можно доказать, что с ростом древесная глубина будет как-то вырастать, и фишка такая, что на самом деле : большая половина будет иметь ровно столько вершин, только брать надо с округлением вверх. Согласны с таким утверждением? Жёстко доказывать, что выгодно бить пополам, я не буду: монотонность проверяется легко, там всё делается легко.
И что же у меня тогда получается? Тогда естественным образом здесь получается дерево. А строится оно следующим образом и называется elimination tree — то есть это второе определение, через elimination tree. Давайте, наверное, лучше будем строить уже на этой доске, правда, так у меня быстро доски закончатся. Вот как оно выглядит для пути: я просто выбираю серединку — это просто , пусть чётное для нашего удобства, — и ставлю её вот здесь, в корень. А ниже у меня получается слева и справа.
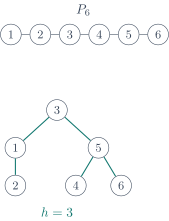
Если мы попробуем взять какой-нибудь конкретный путь — давайте для простоты, например, из шести вершин, — то как будет выглядеть elimination tree для него? Возьмём троечку как корень; тогда вот здесь у меня будет elimination tree для пути вот такого размера. Я специально неудобно перенумерую вершины, чтобы мы с вами понимали, что происходит. Практически единственное elimination tree для пути из двух вершин выглядит вот так, а для пути из трёх вершин лучшее elimination tree будет вот такое. Понятно? Такая история.
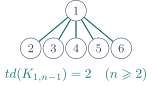
При этом я замечу, что хотя для пути у меня лево и право задаются естественным образом, в определении elimination tree никакого порядка на детях, конечно же, нет. И компонент у меня может быть гораздо больше, чем одна. Например, как выглядит elimination tree у звезды, друзья? В корне — центр звезды, а все листья — её дети: оно просто совпадает с этой самой звездой. То есть звезда — сама себе оптимальный elimination tree.
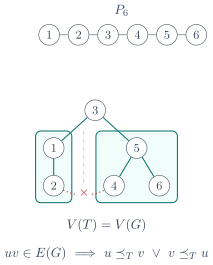
Но формально я ещё не определил, что такое elimination tree, — я просто объяснил, как по вот этой рекурсии строится elimination tree: я ставлю в корень выбранную вершину и дальше рекурсивно строю дерево. На самом деле elimination tree — это некоторое корневое дерево над вершинами графа , и в самом определении, если что, никакой рекурсии не будет. Вершины дерева совпадают с вершинами графа , то есть , но вот рёбра совпадать не обязаны: вовсе не подграф графа . Это можно видеть вот здесь: в случае звезды они прямо в точности совпали, это удобно, но в общем случае включение не обязательно. И выполнено следующее: если в графе есть ребро , то тогда в дереве является предком или наоборот.
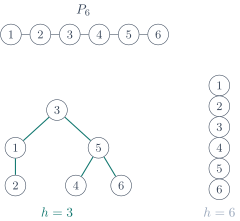
Такое определение описывает любое elimination tree, не обязательно оптимальное. Это я пока определил только, что такое elimination tree. Конечно, например, и путь тоже сам себе elimination tree: я могу написать вот так вот, цепочкой , — это тоже нормальный elimination tree для пути. Мы же, конечно, ищем оптимальный — просто оптимальный не всегда ищется легко. Для древесной глубины нам важно именно оптимальное elimination tree графа. И тогда можно написать, что древесная глубина равна минимальной высоте среди всех elimination tree заданного графа. Давайте я напишу это вот здесь, на новой доске.
— Кстати, можно вопрос? А предок имеется в виду прямым предком или любым предком? — Любым, любым.
— То есть получается, что любое остовное дерево графа — это elimination tree? — Нет, это не так. Импликация-то у нас в одну сторону: если ребро есть в , то — предок или наоборот. — Но если мы построим дерево, которое включает все вершины графа, то в нём это условие должно быть выполнено для любой пары вершин, являющейся ребром. — Да, именно так. Спасибо за пояснение из зала — вопрос был по определению, почему не любое остовное дерево графа подходит. Потому что, когда мы разбили наш граф вот на два поддерева, мы запретили все рёбра, которые ведут отсюда туда; вот эти части действительно независимы.
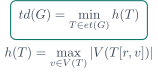
Давайте напишем: , где минимум берётся по всем elimination tree графа , а — это просто высота дерева. Что такое высота дерева, понятно, друзья: когда у меня дерево корневое — то есть я его подвесил за корень, и все рёбра так же ориентируются, — высота дерева есть максимальное расстояние от корня до листа.
— Имеется в виду рёберная глубина или вершинная? — Здесь вершинная, потому что параметр получается вершинный. Он и должен быть вершинным; просто иногда любят вычитать единичку из количества вершин, но тут не вычитается. Будем говорить так: минимальная высота дерева в вершинах.
Согласитесь, что это равенство с первым определением доказывается легко — мы его уже практически связали. Потому что структура elimination tree задаёт выбор вершины , а в обратную сторону выбор вершины задаёт корень elimination tree и дальше рекурсивно. Скажите, пожалуйста, нужно ли это рассказывать подробнее? У нас сегодня много интересных фактов, так что давайте так: если будут вопросы, можно ко мне подходить.
Примеры и оценки: клика, двудольный граф, центроид, DFS-дерево
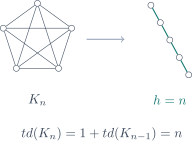
Если останутся непонятные места, я могу пояснить их в перерыве или после лекции. Давайте посмотрим ещё несколько примеров elimination tree. Начнём с клики — полного графа. Чему равна древесная глубина полного графа? Здесь можно заметить, что никакого выбора у нас на самом деле нет: какую бы вершину я ни удалил, останется изоморфный тот же граф, всегда. То есть .
Этот граф никогда не распадётся на компоненты связности: при удалении любой вершины он остаётся связным. Никакого ветвления не будет, поэтому elimination tree здесь — просто бамбук, то есть .
Что ещё хорошего можно заметить про древесную глубину? Если является подграфом , то . Почему? Потому что рёбер стало меньше, то же самое elimination tree по-прежнему подходит, и всё в порядке. Это свойство приятное, и оно выполняется далеко не для всех параметров: например, для distance to cluster оно не работает, потому что брать подграф там дорого — кластеры могут разрушаться.
Отсюда же видно, что бамбук на всех вершинах (в любом порядке вершин) — корректное elimination tree совершенно любого графа; просто оно никогда не бывает лучше, чем . Это вполне разумно: в бамбуке каждая вершина является предком или потомком любой другой, поэтому условие на рёбра выполнено автоматически.
Давайте разберёмся, что же такое elimination tree на пути и на что это очень похоже. Каждая вершина в оптимальном elimination tree соответствует отрезку вершин исходного пути. По сути это дерево отрезков — надо только понять, на чём именно оно строится. Проще всего воспринимать это как дерево отрезков, элементы массива в котором — рёбра. Когда вы разбиваете отрезок пополам, вы удаляете вершину, и массив тоже распадается на две части. Аналогия, конечно, не совсем точная, но смысл такой: мы декомпозируем граф пополам и потом можем очень удобно собирать ответы на отрезках.
При этом это, конечно, очень специальный случай. В дереве отрезков нам известно много дополнительных свойств — например, что отрезок разбивается на ограниченное число частей. В графах в чистом виде это, разумеется, работать не будет.
— Вопросы по этому поводу есть?
Я тут, конечно, немного помахал руками, но на дерево отрезков это действительно очень похоже. Хорошо, давайте порисуем ещё какие-нибудь графы — например, полный двудольный граф . Какая у него древесная глубина, как вы думаете?
— Минимум, наверное.
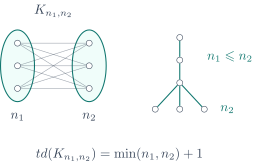
Да, ответ тут такой же, как для вершинного покрытия: мы выписываем одну долю вот так, в цепочку, а другую долю — вот таким образом, веером под ней. Получается : цепочка из вершин одной доли, а из её нижней вершины — веер из листьев.
Какие ещё интересные замечания можно сделать про древесную глубину? Например, что она не превосходит вершинного покрытия: . Это, казалось бы, можно заметить из предыдущего факта: если у меня граф с небольшим вершинным покрытием, то он как раз подграф полного двудольного графа. Хотя нет, это неправда, подграфом полного двудольного графа он, конечно, не является; давайте посмотрим, чего же он подграф. Если вершинное покрытие у меня какое-то маленькое, а вот здесь есть ещё сколько-то вершин, то в худшем случае вершинное покрытие само является кликой. В этом смысле он, конечно, не подграф полного двудольного графа, потому что в полном двудольном графе рёбра внутри одной доли запрещены — обе доли являются независимыми множествами.
— То есть правильно я понимаю, что на самом деле мы говорим, что у любого графа можно взять вершинное покрытие (vertex cover) и нарисовать такую картинку, где по вертикали идут вершины вершинного покрытия, а под ними — все остальные вершины? Вот пример elimination tree для совершенно любого графа.
— Да, именно. Это действительно вот такое глупое elimination tree, которое основано только на вершинном покрытии: сначала выписываем в цепочку полностью всё вершинное покрытие, а потом — все остальные вершины.
Хорошо, давайте перейдём к тому объекту, про который уж точно нельзя сказать, что он не elimination tree, — к деревьям. Давайте поймём, какая древесная глубина у дерева. Какие есть гипотезы, друзья?
— Не хуже логарифма. Возьмём у дерева центроид.
Всё правильно: у дерева надо брать центроид, и всё будет хорошо. Древесная глубина у деревьев действительно варьируется: мы видели, что есть деревья, у которых она константна — например, звезда, у неё древесная глубина . Видели мы и путь, у которого древесная глубина . А можно ли на дереве добиться этого логарифма сверху? Да, можно.
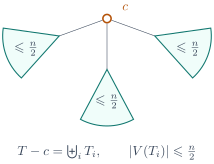
Из курсов алгоритмов, я думаю, вы это слышали всюду, где обсуждались деревья. Утверждение: в любом дереве есть вершина, удаление которой оставляет компоненты связности размера не больше .
— А минус один там можно поставить?
— По-моему, можно даже минус один. Нет, нельзя: для пути минус один поставить нельзя.
Факт знакомый? Такая вершина ищется довольно легко — по спуску по дереву. Если я стою в вершине и её удаление мне не помогает, то у меня есть ровно одна тяжёлая компонента связности; нужно перейти в неё и искать центроид там. Этот процесс в конечном итоге закончится, потому что назад я вернуться не смогу; разберите это в качестве упражнения. Эта вершина, конечно же, и называется центроидом. Стоит вспомнить, что таких вершин может быть две, но больше двух быть не может — на картинке как раз видно, что их две.
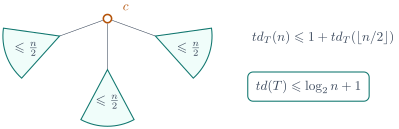
Отсюда следует, что древесная глубина дерева не превосходит логарифма . Давайте дадим точную оценку. Если я беру дерево на вершинах, то . Кажется, отсюда получается ровно двоичный логарифм, правда?
— Плюс один.
— Согласен, плюс один: когда я пришёл к одной вершине, должна получиться единица. Спасибо. Итого .
Есть несколько вопросов про то, как древесную глубину использовать. Те, кто помнит что-то про центроиды, может вспомнить и центроидную декомпозицию, но к ней я бы перешёл попозже: это не самое весёлое, и не то, чем я хотел бы сейчас сильно заниматься. Если вы делали какие-то продвинутые алгоритмы на деревьях, то с этим вы уже встречались.
Я бы хотел побольше рассказать о связи с другими параметрами. У меня здесь написаны два определения древесной глубины. Давайте добавим чуть больше интуиции того, что же она такое на самом деле. Окажется, что класс графов, который она задаёт, описывается очень просто, и что есть очень простой параметр, который вы знали до этого курса и который эквивалентен древесной глубине. Мы сейчас к этому параметру придём.
Хорошо, давайте поговорим о том, как древесную глубину хоть как-то вычислить. Есть ещё один объект, с которым вы работали: если вы проходили графы, вам почти наверняка рассказывали этот алгоритм — поиск в глубину. Про поиск в глубину есть такое утверждение: если я обошёл поиском в глубину неориентированный граф (поиск в глубину рассказывается и для ориентированных, и для неориентированных графов), то в дереве обхода…
— Нужно напомнить, что такое поиск в глубину?
— Нет, не будем; в пререквизитах это есть.
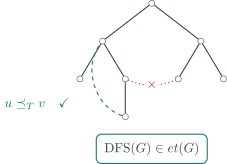
В поиске в глубину доказывается следующий факт: рёбер между вершинами из разных ветвей дерева обхода не бывает. Что из этого следует для дерева обхода в глубину? Раз таких рёбер не бывает, то какие бывают? Только рёбра, соединяющие предков с потомками. А значит, DFS-дерево — это просто некоторое elimination tree. Это понятно, или нужно рассказать поподробнее? Хорошо.
Вопрос: а насколько хорошее это elimination tree? Можем ли мы дать какие-то гарантии? Можем ли мы связать высоту этого дерева с древесной глубиной, или высота DFS-дерева может быть неограниченно далека от настоящей древесной глубины? Как вы считаете?
— Если мы запустим DFS на пути от его крайней вершины, зазор будет экспоненциальный.
Да. Если взять граф-путь и запуститься от крайней вершины — да и вообще в пути, от любой вершины, — у вас получится DFS-дерево высоты не меньше , что экспоненциально от настоящей древесной глубины. А может ли быть хуже, чем это? Ответ: нет. На самом деле DFS-дерево имеет высоту не больше . Я пишу это без всяких констант: возможно, где-то надо добавить плюс-минус единицу, с этим мы разберёмся. А то, что высота хотя бы , я думаю, понятно.
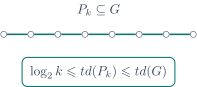
К этому факту нужно потихоньку подойти. Снизу он понятен по определению , а сверху совсем не понятен. Оказывается, всё сильно заточено на путях, и нам нужно следующее утверждение: если граф содержит простой путь длины , то .
Как его доказать? На самом деле просто по тем свойствам, которые мы уже написали. Рассмотрим наш граф ; мы знаем, что у него есть подграф , то есть . По монотонности мы утверждали, что . Остаётся доказать только то, что древесная глубина пути на вершинах не меньше двоичного логарифма от , то есть . Не знаю, понадобится ли нам сейчас округление вниз.
Как это доказать, товарищи? Достаточно просто. Возьмём какое-нибудь elimination tree нашего пути. Мы знаем, что при удалении одной вершины граф распадается либо на одну компоненту связности, либо на две. Отсюда следует, что возможны два случая: либо корень с двумя поддеревьями, где лежат пути и , либо корень с единственным поддеревом, где лежит путь . Я имею в виду, что здесь записано elimination tree пути . Понятно, почему так? Я же однозначно задаю, на что разбивается граф, — я не могу выбрать, на какие подграфы он распался.
Отсюда следует, что , где минимум берётся по всем разбиениям с . По-хорошему надо было бы взять и второй случай тоже, но понятно, что он будет хуже, чем разбить граф на две части, поскольку древесная глубина монотонна. И понятно, что это по индукции хотя бы двоичный логарифм от : . Наверное, очень простые вещи я сегодня рассказываю.
Длиннейший путь и игра «коп — грабитель»
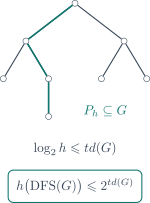
Итак, что же мы с вами получили? Вы, наверное, уже догадались, какой параметр оказывается эквивалентен древесной глубине — если всё предыдущее понятно, то это можно додумать самостоятельно. Давайте ещё раз посмотрим на DFS-дерево и поймём, почему теперь я могу доказать утверждение о том, что его высота не больше . DFS-дерево даёт нам простой путь: если DFS-дерево имеет высоту , то граф содержит в качестве подграфа, то есть . Высота здесь, как и раньше, измеряется в вершинах. Отсюда следует, что , а дальше остаётся проэкспоненцировать. Кому хочется возиться с округлениями — повозитесь, пожалуйста, за меня: я этого дела не люблю, оно заставляет сильно думать, а смысла в нём немного.
Вот он, наш параметр: это просто длина наидлиннейшего пути в графе. Давайте введём его на этой доске, а предыдущую пока оставим — определения снизу я сохраню, чтобы они были у нас на виду. У этого параметра, кстати, даже есть собственное имя, когда мы рассматриваем циклы; а вот как он называется одним словом в случае путей, я не знаю. Определим — длину наидлиннейшего простого цикла в . Этот параметр известен как circumference; по-русски это переводится как «окружность», но что такое окружность графа, по-русски не очень понятно.
— Это про простые структуры речь?
— Да, именно так: наидлиннейший простой цикл в .
Парный термин — обхват, наикратчайший простой цикл. Давайте для ликбеза запишем и его: — это длина наикратчайшего простого цикла, и именно слово «обхват» используется в русском языке. Здесь, конечно, нужно не занудствовать и не считать одно ребро циклом: кто-то любит объявлять ребро циклом длины два, поскольку каждую вершину оно содержит ровно один раз, — но само ребро при этом содержится дважды. И, наконец, у нас есть параметр — то же самое, но для путей. Запишем утверждение: эквивалентен , древесной глубине .
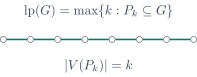
— А чем не диаметр, если мы говорим про невзвешенные графы?
— Диаметр — это длина наидлиннейшего из кратчайших путей. Например, у полного графа диаметр равен единице.
— А, то есть в диаметре берётся максимум по минимуму, а здесь просто максимум.
— Да, именно. Поэтому кратчайшие пути искать можно за полином, и диаметр тоже вычисляется за полином — всё нормально. А наидлиннейший путь за полином мы считать не умеем; мы даже не умеем его хорошо приближать, но это уже отдельная история про приближения.
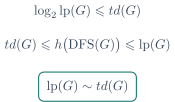
Переходим к доказательству — хотя, кажется, мы с вами всё уже доказали. С одной стороны, мы получили, что . А в другую сторону?
— Мы ведь доказали, что не больше высоты DFS-дерева, а высота DFS-дерева не больше, чем .
— Да, спасибо, именно так и обозначим. То есть через DFS-дерево докажем, что больше либо равен высоте какого-то DFS-дерева . А мы знаем, что DFS-дерево — это elimination tree, поэтому его высота хотя бы . Итого: .
— Где-то здесь нужна степень?
— Нет, здесь не нужна. Вопрос только в том, в чём мы меряем : наидлиннейший путь мы меряем в вершинах, поэтому всё сходится. Обратите внимание, что с наидлиннейшим циклом вершины и рёбра дают одно и то же, а с путём — нет. Поэтому напишем прямо над параметром: число вершин в наидлиннейшем простом пути. Видите, DFS-дерево внезапно стало мостиком между параметрами.
Очень занятным я здесь нахожу следующий факт: это можно сравнить с массивом. Когда мы строили дерево отрезков над массивом, длина массива задавала сложность алгоритма. Здесь получается нечто похожее: если в графе нет длинных простых путей, то и древесная глубина будет маленькой, что вполне укладывается в аналогию с массивами.
У нас остаются две вещи. Во-первых, замечательное альтернативное определение древесной глубины, во-вторых — то, как древесную глубину использовать. На самом деле здесь очень много динамического программирования, но мы с вами динамического программирования уже наелись на прошлой лекции, поэтому я постараюсь подойти немного с другой стороны. И вообще расскажу, что древесная глубина, как и дерево отрезков, применяется не только к NP-трудным задачам. Даже некоторые коллеги, сидящие здесь, вместе со мной использовали древесную глубину в enterprise-задачах для вполне практических целей.
— Там были NP-трудные задачи?
— Да, задачи были NP-трудные, но мы запускали на них полиномиальные эвристики. Об этом я расскажу в следующей части лекции, а если не успеем — перенесём на следующую.
Я забыл сказать ещё один важный термин. Остовные подграфы , которые являются elimination tree, имеют собственное имя — это деревья Тремо (Trémaux trees), названные в честь учёного. В определении elimination tree мы специально отмечали, что включение не обязательно; здесь же речь именно про тот случай, когда оно выполняется. В частности, DFS-дерево — это дерево Тремо.
Давайте продолжим: я не хотел бы вас сильно задерживать, но хочу успеть рассказать кое-что замечательное. Раз уж сегодня у нас меньше алгоритмов и больше структурных соображений, я начну с дополнительного определения древесной глубины, которое нам встретится и дальше. Окажется, что если в этом определении поменять пару правил, то получится совершенно другой параметр графа. Итак, концепт, с которым мы столкнёмся, называется Cop-Robber Games. Этот концепт встретится нам как минимум в трёх параметрах, и древесная глубина — первый из них; возможно, по ходу курса появятся и ещё.
В чём заключается общая идея? Представьте, что вы работаете на вашем графе за отдел полиции — то есть играете всё-таки не за преступников, а за законопослушных ребят: копы у нас законопослушные. Есть некоторый нехороший преступник, и вы с помощью копов стремитесь его зажать. Копов может быть несколько, но что именно представляет собой — это будет варьироваться, и что делает злоумышленник на графе — тоже может варьироваться. Давайте объясню на примере древесной глубины.
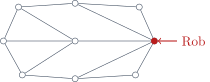
Весь граф — это как бы целый город, и в какой-то его вершине находится злоумышленник; я назову его . Первое правило: находится ровно в одной вершине единовременно. Понятно, что он может делать: ходить только по рёбрам, причём в этой истории скорость у него обычно бесконечная — он может двигаться бесконечно быстро, и копы с этим ничего не сделают. Второе правило: блокирует вершину одной фишкой — мы просто ставим в вершину копа, и специально называть копов не будем. Правда, изображать злоумышленника крестиком было не очень разумно: крестик у нас как раз обозначает блокировку вершины. Третье правило: после блокировки преступник не может ходить через заблокированные вершины — это то же самое, как если бы вершина удалялась из графа.
И отдельное замечание про фишки: поставленную фишку убирать нельзя. То есть мы как бы полностью сжигаем вершину, и в данной истории она удаляется из графа. Так будет не всегда — не всегда мы будем запрещать убирать фишку.
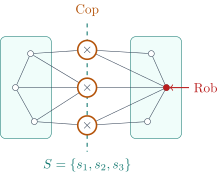
Как это может выглядеть? Какая цель у полицейских? Зажать преступника где-то в ограниченной области. Понятно, что если мы заблокируем всего одну вот эту вершину, то множество вершин, где преступник может находиться, не изменится: он по-прежнему может оказаться в любом месте графа. Но если я заблокирую фишками вот эти три вершины, то получается, что преступник, хотя он и двигается с бесконечной скоростью, в любом случае остался либо в этой части графа, либо в этой. Как бы он ни двигался, пока я ставлю фишки, он всё равно окажется зажат здесь или здесь.
Поэтому нужно добавить ещё одно правило: в любой момент времени может узнать положение . У нас будет и сценарий, когда копы этого знать не могут, — и получится другой параметр: даже не видя преступника, мы всё равно его поймаем, но там потребуется разбирать другой случай. И это всё. Теперь смотрите, какова наша стратегия и как она связана с древесной глубиной. Мы ставим три фишки и делим граф на компоненты связности — точно так же, как в древесной глубине. Затем подсматриваем, в какой из компонент находится преступник, и идём играть только в эту половину. Частей, конечно, может быть больше двух: вот здесь может быть ещё один участок графа, так что их может оказаться три, четыре, десять.
Как же определяется древесная глубина через количество фишек? По сути я уже всё сказал: древесная глубина — это минимальное количество фишек, которое нужно , чтобы поймать . А когда мы считаем, что поймали ? Когда ставим фишку ровно туда, где он находится. Запишем: проиграл, если поставил фишку в него. Легко понять, что это возможно только тогда, когда у осталась одна вершина и деться ему уже некуда.
И утверждение: минимальное количество фишек, необходимое для поимки , в точности равно . В одну сторону это доказывается совсем тривиально — мы фактически всё уже обсудили. А в другую сторону я, честно говоря, доказательство сегодня не подготовил, да и такой цели у меня не было: я хотел рассказать саму идею, а доказательства мы ещё успеем рассмотреть. Доказательства в обратную сторону будут довольно сложными. Давайте докажем простую сторону, чтобы всё стало понятно.
Как это сделать? На elimination tree играть очень просто: elimination tree высоты позволяет выиграть, имея фишек. Примерно понятно, как это нужно делать? Давайте попробуем, Дамир, хорошо? Сначала сделаем вот это. Я же не могу вам сказать «сейчас мы докажем», если сам чего-то не продумал, — но я с вами согласен, может получиться и на халяву. Давайте просто посмотрим: есть у меня некоторый elimination tree.
Применение древесной глубины: решение NP-трудных задач
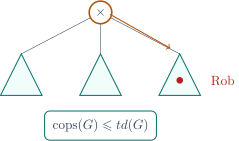
Я ставлю фишку в корень дерева. Дальше у меня есть, более-менее, два варианта: либо дерево с одним потомком — тогда вообще никакого выбора нет, — либо потомков много. То есть я всегда просто ставлю фишку в корень elimination tree и смотрю, где находится преступник. Дальше я перехожу в нужную компоненту, а все остальные отбрасываю: я говорю, что в той части города я его больше не ищу. Это просто спуск по elimination tree в нужную сторону.
И что мы с вами доказали? Что число фишек — обычно число фишек как раз и называется числом копов, , — не превосходит древесной глубины. У копов, заметьте, бывают очень разные возможности в зависимости от вашего города: у копов разное финансирование. Вот у этих есть только древесная глубина, то есть ловить они умеют только по древесной глубине. Значит, . Согласны, что в эту сторону мы доказали?
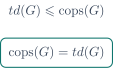
Давайте докажем и в обратную сторону. Кажется, Дамир предложил дельную мысль — только нужно, как обычно, наложить какие-то ограничения на стратегию. Докажем, что : теперь нужно сделать наоборот, из стратегии копов построить elimination tree. Что мы заметим? Заметим, что у копов есть оптимальная стратегия, в которой выбор фишек зависит только от текущего графа и от компоненты связности, в которой находится Rob.
И отсюда уже более-менее всё очевидно. Дело в том, что у преступника бесконечная скорость, и мне не важно, в какой именно вершине он находится: в любой момент времени он может мгновенно переместиться куда угодно, но только внутри своей компоненты связности — скакнуть из одной компоненты в другую он не может. Отсюда автоматически следует, что текущий выбор фишки копов — это просто выбор корня elimination tree для текущей компоненты связности. Это первое замечание; дальше, выбор фишки на текущем графе — это корень elimination tree.
Ну и всё. Мы знаем, что у копов есть стратегия, которая работает на этих компонентах связности; мы просто делим эту стратегию на много частей и применяем каждую к своей компоненте. Достаточно формально я объяснил, или что-то не вяжется? Здесь действительно получилось одно к одному, нужно только аккуратно всё склеить. Так будет не всегда: когда мы объявим такую же игру для древесной ширины, там так просто не получится — там будет настоящий ужас.
С этими играми разобрались. Есть и другие определения, но на них я пока остановлюсь: определений нам пока хватит. Вообще, у нас с вами должно появиться ещё много концептов — например, концепт миноров графа, до которого мы пока не дошли. Но видите: древесная глубина — очень простой параметр, о котором можно очень много говорить, и всё с ним приятно и просто. Давайте перейдём к применениям древесной глубины.
Первое из её применений — это решение NP-трудных задач. Вещь это не вполне формальная: не каждая NP-трудная задача решается с опорой на древесную глубину, но таков общий подход — мы получаем какую-то экспоненту от древесной глубины. И во многом это делается динамическим программированием, в котором нужно держать какое-то подмножество интересных вершин. Помните, как мы делали на прошлой лекции: считали динамику по дереву и смотрели профиль feedback vertex set — это было довольно неприятно. Здесь тоже такое работает, но я хочу предложить что-то более простое для понимания; к динамическому программированию мы ещё успеем перейти, и, кстати, оно будет приятнее, чем в случае feedback vertex set.
Это к тому, что более выразительный параметр не обязательно сложнее в работе: если параметр описывает большее семейство графов, работать с ним не обязательно тяжелее. У нас, например, был вариант взять параметр «максимальное число листьев» (max leaf number). Он довольно ужасно сформулирован, непонятно, как с ним работать, и при этом он описывает очень маленькое семейство графов, — мы решили этот параметр вообще выкинуть из курса, потому что непонятно, что про него рассказывать. Параметр этот классический, он изучался очень давно, но потом люди уже поняли, чего они хотят от параметра.
Давайте подойду к решению NP-трудных задач с такой стороны. Представьте себе просто полный перебор на графе: вы хотите найти ответ на какую-то задачу и перебираете все подмножества. Например, решаем вершинное покрытие, . Как я его решаю? Перебираю все и проверяю, что — вершинное покрытие. И это можно организовать как рекурсивный перебор.
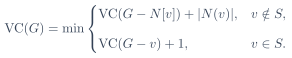
Организуется он так. Пусть — это либо случай, когда я беру вершинку в ответ, либо случай, когда не беру. Если вершинку я в ответ не беру, то в ответ придётся взять всех её соседей: я удаляю замкнутую окрестность и прибавляю количество соседей. Либо я могу просто удалить вершинку из графа и взять её в ответ. Итого
Пример получился не очень простой, надо было написать что-нибудь попроще, но уже не важно. Согласны с такой рекуррентой? Серёжа так смотрит, будто я набажил. Нет, всё хорошо. И согласитесь, это легко переделать в рекурсивный перебор: у нас просто функция от графа считает вершинное покрытие.
А помните первое, рекурсивное определение , которое тоже позволяло так делать? Там мы тоже определяли что-то рекурсивное. Так вот, древесной глубиной можно пользоваться, чтобы правильно организовать вот эту рекурсию. Смотрите: глубина этой рекурсии в худшем случае равна . Можно, конечно, преобразовать граф так, чтобы она была поменьше, чем , но не важно — она всё равно зависит от количества вершин в графе. Поэтому такой перебор будет экспоненциален от .
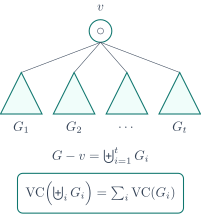
А теперь смотрите, что будет, если я буду брать вершинку как корень elimination tree текущего графа. Ведь выбор вершины в рекурренте вообще никак не задан — я могу взять произвольно. Если — корень elimination tree, то в обеих ветках мой граф вершинку больше не содержит, а значит, и там и там он распадается на компоненты связности — именно потому, что вершинка удалилась. А вершинное покрытие я умею решать на компонентах независимо: если взять дизъюнктное объединение графов, то
Это практически бесплатная победа: я просто выбираю вершинки таким образом, и глубина рекурсии оказывается не больше, чем древесная глубина. Понятно, почему глубина рекурсии не больше, чем ? Потому что при каждом новом вызове древесная глубина графа обязательно сокращается на единицу — именно так я выбираю вершинку . Вопрос только в том, какое получается общее время работы. Давайте это поймём; я тут, честно говоря, засомневался, что оценка будет хорошей от древесной глубины.
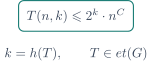
Видимо, можно просто доказать по индукции такое утверждение: на графах древесной глубины эта рекурсия работает не больше, чем . Вы пока, может быть, не переписывайте — я не знаю, правда ли это, но должно быть правдой. И, понятно же, что все эти соотношения написаны как тождества, но за каждым из них стоят полиномиальные алгоритмы, которые это считают. Нужна какая-то база индукции: на пустом графе, в котором вообще ничего нет, алгоритм должен выдавать нуль, или хотя бы на графе из одной вершины он должен выдавать нуль — не важно.
Давайте поймём, что при всё очевидно: он действительно столько работает. Почему он работает полиномиальное время? Потому что граф древесной глубины нужно разбить на компоненты связности — мы помним, что граф может быть несвязным, — а граф древесной глубины это просто куча изолированных вершин, то есть всё, что там нужно сделать, полиномиально.
А когда больше, что я знаю? Что время работы на древесной глубине не превосходит следующего. У меня есть два вызова, каждый из них занимает , умноженное на этот полином; я удалил одну вершинку, и всё это нужно умножить на два и добавить ещё какой-то полином от . Получается
Откуда двойка? Это я домножил, потому что у меня два вызова. Но индукция получилась очень плохая: у нас время зависит и от , и от , и с этим всегда надо быть аккуратным — здесь теряется. Давайте доказывать по индукции более аккуратный факт, а именно
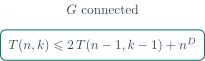
Вот это я и доказываю по индукции, с указанной выше базой. А что за ? Это полином, который нужен, чтобы сделать сам рекурсивный вызов: выделить вершинку , построить два графа и сделать два рекурсивных вызова. Тогда корректнее написать так:
Теперь всё хорошо: я уменьшил число вершинок на единицу и на единицу. Что, Серёж, не сойдётся?
— Только в связных графах.
— Что в связных графах работает?
— Ну потому что в несвязном графе может не уменьшиться при удалении вершины.
— Нет… А, я понял, о чём речь. Да, спасибо, Саша, это действительно чётко. Нам нужно добавить сюда ещё один переход: если нам дали несвязный граф, его надо разбить. То есть если граф несвязный, то вызов нужно заменить вот на это — на то, что у меня уже написано, на сумму по компонентам. Это и есть дополнительный переход алгоритма. И тогда я точно знаю, что при рекурсивном вызове уменьшится обязательно.
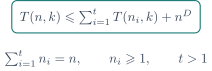
Но тогда и этот переход нужно будет провести через индукцию. Давайте это напишем. Рекуррента — это то, как алгоритм работает на связных графах. А на несвязных графах — спасибо большое, что вы следите внимательно — нужно доказать, что
Итак, нам нужно доказать по индукции две рекурренты. Первая — случай несвязного графа, когда я разбил граф на части; вторая — случай связного графа, когда я уменьшил на единицу. Как вы считаете, получится у нас эти рекурренты доказать, или я накосячил? Давайте попробую; времени у нас осталось только на это, что-то новое начинать не хочется.
У меня тут, признаюсь, была хитрость. Я писал одну статью, и там была такая рекуррента, которая не сходилась: пришлось усиливать предположение индукции, чтобы она сошлась. Правда, там граф делился не на непересекающиеся части — он пересекался по двум вершинам, — и индукцию приходилось проводить именно так. Давайте посмотрим, что будет здесь.
Итак, случай несвязного графа назовём , а случай связного — . Что нам нужно доказать в случае ? Кажется, нужно доказать, что
где — размеры компонент связности, — число компонент, и важно, что : иначе доказать не получится, потому что появится лишний множитель. Значит, нам нужно оценить разность минус вот эта сумма — выписывать её целиком я не буду.
Проверка оценки и вопрос о вычислении td
Думаю, в целом понятно, к чему мы пришли: для меня гораздо важнее то, что мы сделали раньше, чем именно эти выкладки. Но такие выкладки, конечно, нужно проверять, потому что может случайно оказаться, что алгоритм работает не за , а за — и такое бывает. Есть ли вопросы, как мы к этим выкладкам пришли? Тогда давайте доведём их до конца; если сейчас ничего не получится, в начале следующей лекции мы это быстро сделаем, я просто подготовлю выкладки заранее. Нам ведь нужно, чтобы между этими двумя величинами был запас.
— Там степень , а ты не фиксировал — ты можешь выбрать какую угодно.
Я сейчас показываю не то, что нужно. Мне нужно показать, что оценка сверху, которая у меня есть на , не хуже вот этой, то есть что она взята с запасом. Иначе говоря: когда я разбил вершин на части, у меня появился некоторый запас — именно это и надо проверить.
— Дели на , дели на , и получается что-то такое. Видимо, оставшуюся единицу надо ещё перенести.
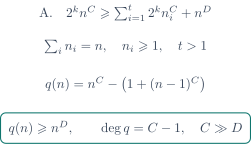
Давайте посмотрим, когда эта сумма достигает максимума. На множитель я вообще забью: просто положу , чтобы мне было хуже. Тогда получается, что мне нужно показать неравенство — то есть что, уменьшив на единицу, я выигрываю хотя бы . Верно ли это? Разумеется, при этом должно выбираться как функция от . Сколько я выигрываю, если из полинома вычитаю единицу — выигрываю ли я здесь полиномиальные множители?
— Слева получится многочлен степени .
Да, именно так: старшие коэффициенты друг друга уничтожают, cancel out, и слева остаётся многочлен степени . И этот многочлен степени должен быть больше, чем — это выполняется при условии , но нужно проанализировать его коэффициенты. Кроме того, нужно убедиться, что максимум, который может достигаться в этой сумме, выглядит именно так; мне кажется, что это действительно максимум. Тогда всё проходит.
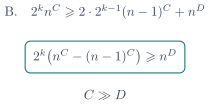
Вторую оценку, случай Б, тоже надо проверить. Нам нужно убедиться, что оценивает сверху выражение, которое даёт индукционное предположение: . Я здесь написал не очень аккуратно — следовало бы писать что-то вроде равенства, потому что мы доказываем именно оценку сверху на , но так всегда происходит. Дальше всё то же самое: у нас снова возникает разность . Видите, как важна здесь эта минус единица: если бы её не было, всё это, конечно же, было бы неверно.
Получается, что мы написали просто какой-то рекурсивный перебор — на самом деле не совсем тупой, чтобы его построить, кое-что надо знать, — и при правильном выборе вершин добились того, что алгоритм работает очень просто. И никакого динамического программирования нам при этом не понадобилось. Мы дошли до конечной точки первого пункта: «Применение . 1. Решение NP-трудных задач», и проверили, что важные выкладки действительно сходятся. Это тот аппарат, который так или иначе приходится проделывать всегда, когда вы анализируете время работы таких рекурсивных алгоритмов. Какие есть вопросы?
— как параметр кажется не очень интересным, потому что для алгоритма нужно знать само дерево, а найти это дерево кажется не очень просто.
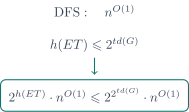
Согласен, Константин замечает совершенно правильно: нам нужно знать elimination tree нашего графа. Правда, можно заметить, что найти elimination tree нужно только для исходного графа, а остальные потом просто восстанавливаются. И тогда возникает реальный вопрос: как вычислять ? Я как раз хотел посвятить вычислению параметров отдельные лекции. Пока что мы умеем вычислять только приближённо и экспоненциально: за полином мы получили elimination tree высоты не больше , и в комбинации с этим алгоритмом получается не очень хорошо — выходит . Пока мы умеем только так, по-другому считать мы не знаем.
Видите, насколько эти параметры многогранны: нам интересны ещё и те параметры, которые реально можно хорошо вычислять или приближать.
— То есть если мне кто-то просто дал знание, что древесная глубина этого графа такая-то, мне всё равно нужно знать само разложение, elimination tree.
Да, согласен: само знание ничего не даёт. Поэтому я думаю, что мы этому посвятим либо часть какой-то лекции, либо целиком отдельную лекцию вычислению параметров, потому что это получается прямо отдельный топик, о котором надо говорить. И он, конечно, важен — люди о нём действительно думают. Ещё вопросы?
— Есть ли полиномиальный алгоритм, который находит этот лучший elimination tree с каким-нибудь приближением — с константным?
Не могу сказать: я не изучал литературу, может быть, и есть. Смотрите, обычно сейчас все алгоритмы, которые улучшают поиск параметра, применяют к древесной ширине — по древесной ширине есть просто целый набор таких алгоритмов. Я подготовлюсь к лекции по вычислениям и посмотрю, есть ли что-то интересное для древесной глубины, потому что так, быстро, это понять невозможно. А для древесной ширины я могу назвать несколько алгоритмов прямо сейчас, потому что их знают просто все. Древесная ширина — это такой параметр, который…
— Затмил просто всё.
Да. Мы с вами ещё поймём, почему он так важен. Ещё вопросы? Действительно, сколько может быть вопросов, когда уже 19:40. Хорошо, тогда спасибо всем, кто пришёл сегодня, — очень рад, что вы здесь.